假設一家精密加工廠導入業務 agent 整理詢價信:讀信、對照圖面與材質、標出缺漏的資訊,再擬一封回覆給業務確認。展示那天,它把三封信整理得清清楚楚,大家都很滿意。
上線第二週,業務發現它把一封「急件、需要陽極處理」的詢價歸成一般件。客戶把需求寫在附件 PDF 的備註欄,而展示用的三封信,剛好都把需求寫在信件內文。驗收的考題要從你過去真的遇過的案件裡挑,展示用的案件只能證明它做得到,證明不了它每次都做得到。
這篇整理 agent 專案的驗收怎麼做:怎麼定義「完成」、怎麼用歷史案件建測試集、要看哪幾個數字、上線前後各要測什麼,以及交接時要交出哪些東西。
為什麼 agent 驗收和一般軟體不一樣
一般軟體輸入一樣,輸出就一樣,寫好測試就能判斷對錯。agent 不是這樣。OpenAI 的評估指南一開頭就說,生成式 AI 的輸出會變動,同樣的輸入可能得到不同結果,傳統的軟體測試方法不夠用。Google 的 Agent Development Kit(ADK)文件也提到,模型的機率特性讓單純的通過/不通過判斷常常不適用,要同時評估最終回覆和 agent 走過的步驟。
Anthropic 在一篇談 agent 評估的文章裡用了一個很好懂的例子:訂機票的 agent 在對話最後說「您的機票已訂好」,但真正要檢查的是資料庫裡有沒有那筆訂位。看 agent 說了什麼不夠,要看系統裡實際發生了什麼。
換到工廠的情境,例如客服 agent 回覆「已建立品質異常單」,驗收要打開系統,確認單據真的存在、批次編號對、負責人指派對。
步驟也要看。例如 agent 最後的答案正確,但過程中先嘗試讀一個它不該讀的報價資料夾,被權限擋下才改走別的路。結果是對的,過程卻透露了風險,這種問題只看最終回覆是看不出來的。
先定義什麼叫「完成」
Anthropic 對好的測試題有一個很實用的標準:兩位熟悉這項業務的人各自判斷,會得到一樣的通過或不通過結論。兩個人意見不一,代表題目本身還不夠清楚,拿它去打分只會產生雜訊。
實際做法是請兩位業務各自替同樣 10 件信填答案,對不上的地方,就是定義還不清楚的地方,先討論清楚再擴大到 50 件。
所以寫測試集之前,先替每一種任務寫下「完成」的定義:
| 任務 | 完成的定義 | 怎麼檢查 |
|---|---|---|
| 整理詢價信 | 材質、數量、交期、表面處理都抓對;缺漏欄位全部標出;急件有標記 | 和業務事先填好的標準答案逐欄比對 |
| 建立品質異常單 | 單據存在於系統,訂單、批次、機台欄位正確 | 到系統查單據,不只看 agent 的回覆 |
| 擬回覆信 | 業務只需小幅修改就能寄出 | 事先定義「小幅」,例如改動不超過兩句 |
| 該轉人工的案件 | 沒有自行處理,轉給指定的人並附上原因 | 查轉派紀錄與附註內容 |
最後一列最容易被漏掉。驗收不只看 agent 做對多少,也要看它在不該做的時候有沒有停下來。
還要先講好「部分正確」怎麼算。例如 agent 抓對了材質和數量,卻漏標急件,這一件算通過還是失敗?我建議把欄位分成關鍵欄位和一般欄位:急件標記、交期、數量錯一個就算失敗;備註的措辭不夠精準,記下來但不影響判定。這條規則要在跑測試之前寫好,事後才定,很容易變成替結果找理由。
用過去的真實案件建測試集
很多團隊覺得要先準備幾百題才能開始評估。Anthropic 的建議是,從真實失敗案例中挑 20 到 50 個簡單的任務,就是很好的起點;專案初期每一次修改的影響都很明顯,小樣本就看得出差異。OpenAI 也把「測試資料不能反映實際的案件分布」列為常見錯誤,並建議把歷史資料和正式環境的資料納入測試集。
假設這家加工廠從過去三個月的詢價信裡挑出 50 件:
- 30 件一般詢價,資訊完整
- 10 件缺少材質、數量或公差等資訊
- 5 件急件,需求寫在附件或信件最後一行
- 5 件應該轉人工的信,例如要求特殊折扣、夾帶客訴、內容和詢價無關
每一件由業務先填好標準答案,包括該不該轉人工。這 50 件就是之後每次修改都要重跑的考題。測試集裡有客戶名稱、圖面和報價,存放方式要比照原本的業務資料;交給外部開發廠商之前,先確認哪些欄位需要遮蔽。
工具只是輔助。例如 Microsoft Copilot Studio 的 agent 評估功能,單次問答的測試集每組最多 100 個案例,測試結果在系統裡保存 89 天,要長期保存得匯出成 CSV。測試集和每次的結果,要存成團隊自己掌握的檔案。平台會變動,例如 OpenAI 已公告它的 Evals 平台將在 2026 年 10 月底轉為唯讀、11 月底關閉。
驗收要看的四個數字
| 指標 | 怎麼算 | 假設的驗收門檻 |
|---|---|---|
| 任務成功率 | 符合「完成」定義的案件數 ÷ 測試案件數 | 應自行處理的 45 件中至少 42 件 |
| 轉人工的正確率 | 該轉的有轉、不該轉的沒轉 | 5 件應轉人工的信全部轉出 |
| 錯誤攔截 | 出錯的案件中,被確認點或規則攔下的比例 | 寄出前全部攔下 |
| 交接完整度 | 接手的人不需問原開發者就能處理的項目數 | 交接清單全部完成 |
門檻由業務單位決定,表裡的數字只是示範。有兩個地方要特別注意。
第一是一致性。Anthropic 提到,如果 agent 每次嘗試的成功率是 75%,連續三次都成功的機率只有約 42%。對客戶的流程要看的是每次都做對的機率,所以同一組考題要多跑幾次,看結果穩不穩定。假設 50 件跑三次,其中 3 件每次的結果都不一樣,這 3 件比平均成功率更值得先處理,它們通常指向說明不清楚的規則或資料。
第二是錯誤類型。只看成功率會漏掉錯在哪裡。把失敗案件分成讀錯資料、漏掉步驟、工具呼叫失敗、做了超出權限的嘗試幾類,每一類的處理方式都不一樣。讀錯資料可能要整理知識來源;超出權限的嘗試則要回頭檢查權限與人工確認的設計。
寫成雙方都能核對的驗收條件
把上面的內容寫成一段文字,放進需求書或合約附件。例如:
以過去三個月的 50 件詢價信為測試集(清單與標準答案見附件,由業務部填寫)。agent 連續執行三次,應自行處理的 45 件每次至少 42 件符合完成定義;5 件應轉人工的信每次都轉出;並行運作兩週,所有差異案件皆有紀錄與處理結論。
這段文字有三個重點:考題和標準答案在開發前就定好、成功要連續多次成立、並行運作的差異要有結論。先定考題再開發,雙方對「做完」的認知才會一致。
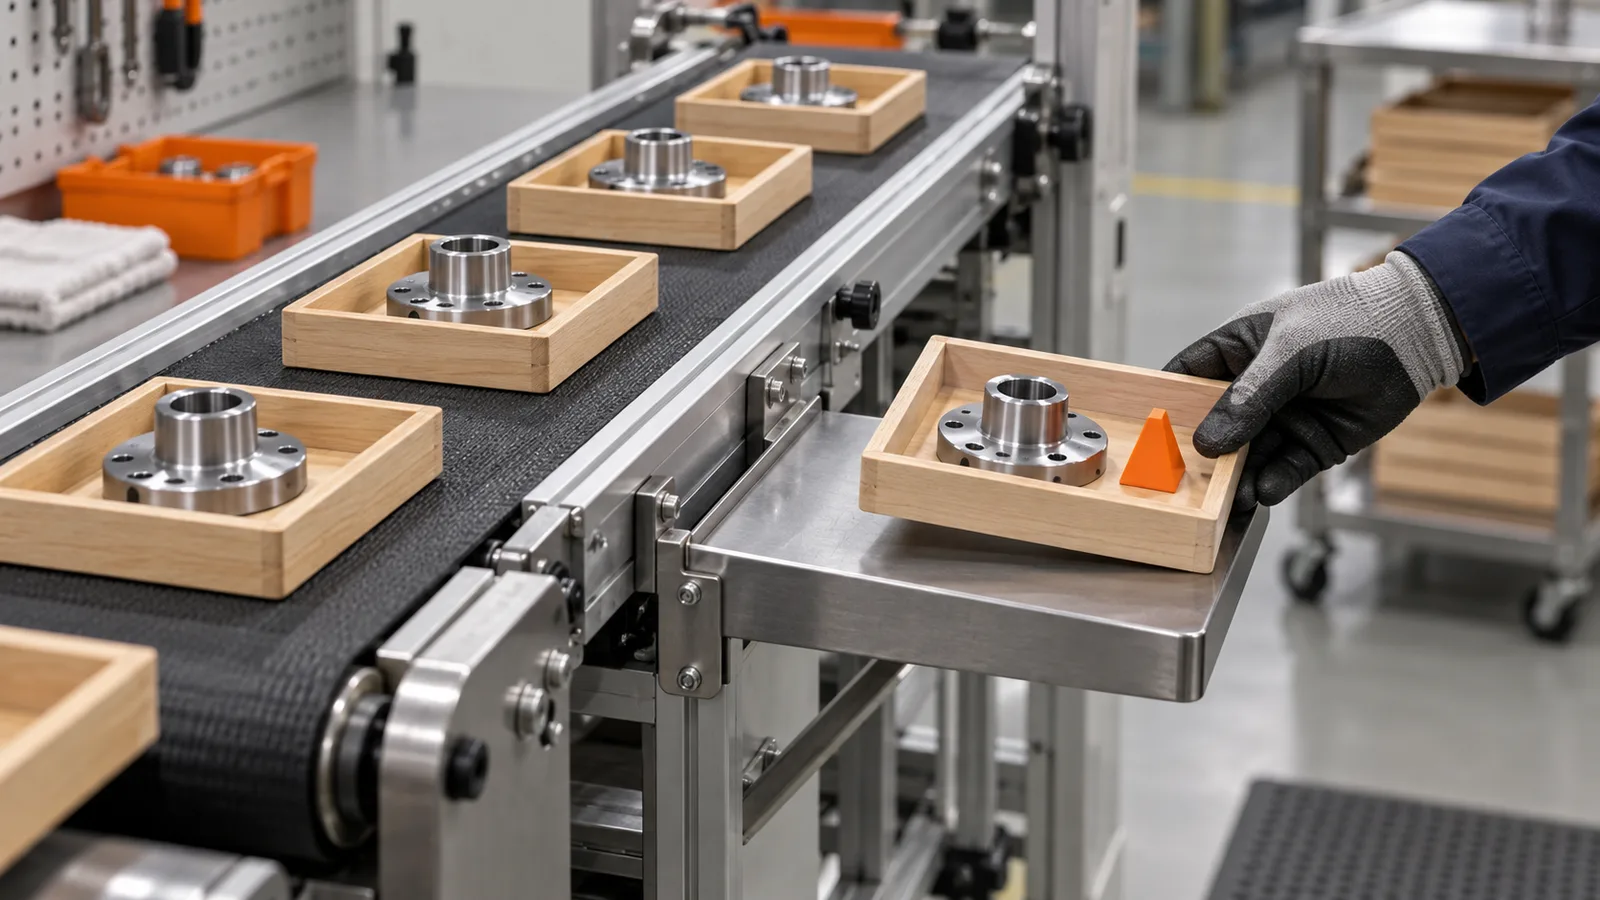 大部分案件照常完成,出問題的那一件要被攔下來,交到人的手上檢查。
上線前先並行跑,上線後持續重測
上線前:和人並行一段時間
測試集過關之後,我建議先讓 agent 和人並行處理同一批新進案件一到兩週。agent 照常產出結果,但不寄出、不寫入正式資料,產出只存在測試區;業務照原本的方式處理。每天挑幾件比對兩邊的結果,差異記下來,補進測試集。
假設並行兩週共進來 80 件詢價,其中 6 件兩邊結果不同:4 件是 agent 漏看附件,2 件是業務自己漏標了急件。後面那 2 件也值得記下來,它說明標準答案本身也要再對一次,人工流程同樣會出錯。
這一步能抓到測試集沒涵蓋的案件類型。開頭那封把需求寫在附件的急件,通常就是在這個階段被發現的。
上線後:同一組考題持續重測
NIST 的 AI 風險管理框架在衡量(MEASURE)這一項寫明,AI 系統應在部署前測試,也要在運作期間定期測試。OpenAI 建議設定持續評估,每次修改都重跑,並把新發現的狀況加進測試集。
Anthropic 把測試分成兩種:能力測試問「它做得到什麼」,一開始通過率低,用來推動改進;回歸測試問「它還做得到原本會的事嗎」,通過率應該接近百分之百。能力測試穩定通過後,就轉成回歸測試持續跑。模型升級、提示調整、新增工具、流程改變,任何一項變動都要重跑回歸測試。
除了重跑考題,上線後每週看三個數字:轉人工的件數、被確認點攔下的件數、人工修改草稿的幅度。轉人工突然變多,可能是客戶換了信件格式;人工修改變多,可能是提示或資料來源出了問題。門檻也要事先寫好,例如回歸測試通過率掉到 90% 以下,就暫停自動寫入,退回只產出草稿的模式。
交接文件要交出什麼
agent 上線後,負責維護的人常常不是當初開發的人。交接時至少交出這幾樣:
- 流程說明:agent 負責哪幾步、哪幾步留給人
- 權限表:每個工具的等級與確認點
- 測試集與最近一次的結果,包括失敗案件的分析
- 已知限制:哪些案件類型還處理不好
- 停用與退回人工的步驟,以及誰有權執行
- 操作紀錄怎麼查、保存多久
- 誰負責重跑測試、多久一次
判斷交接有沒有完成,最直接的方法是找一位沒參與開發的同事,只看這份文件回答三個問題:這週 agent 處理了幾件、哪一件出了錯、要怎麼暫停它。三題都答得出來,交接才算完成。失敗案件的分析要附原因和處理狀態,接手的人才分得出哪些是已知問題、哪些是新問題。導入效益的算法,也可以參考 Claude Skill 使用方式裡「效益怎麼衡量」那一段。
驗收做不到的事
- 測試集只代表過去:新的客戶、新的產品線、新的信件格式,都可能落在測試集外。例如公司開始接醫療器材零件,詢價信會多出認證文件的要求,這類信在測試集裡一件都沒有。這就是為什麼上線後要持續把新案件補進去。
- 自動評分會出錯:用 AI 替 AI 打分可以省人力,但 OpenAI 建議用人的判斷來校準自動評分,Anthropic 也強調要實際閱讀執行紀錄,確認失敗是 agent 真的做錯,還是評分標準誤判。假設先拿 20 件人工評過的案件讓 AI 評分,兩邊結論大致一致,再擴大使用。
- 分數高也要看紀錄:成功率很高、但每件都走了很繞的路或多呼叫了不必要的工具,成本和風險都會累積。OpenAI 的追蹤評分就是為了看出這種問題:它是否選對工具、該交接時是否交接。
跟其他準備工作怎麼接
驗收條件其實在選流程時就該想好,見哪些企業流程適合先交給 AI agent。權限等級決定了錯誤攔截要測什麼,見 AI agent 的權限與人工確認怎麼設。
如果還在決定由誰來開發,驗收標準也是和廠商談合約時最該寫清楚的一段,見企業 AI agent 自建、用平台還是委外。
我們怎麼驗收
我們的企業 AI 營運方案在需求診斷階段就會確認明確的交付與驗收標準,測試集和完成定義是其中一部分。驗證上線階段會在真實業務中測試驗證,確認流程安全無誤後才正式上線;上線後進入持續維護,流程調整或模型升級時一起重跑測試。例如詢價整理這類流程,我們會先和業務一起從過去的信件裡挑出考題、填好標準答案,再開始串接系統。
常見問題
測試集要多少案件才夠?
起步 20 到 50 件就夠,重點是從真實案件裡挑,並涵蓋一般件、缺資料、急件和該轉人工這幾類。之後把並行運作與上線後遇到的新狀況陸續補進去。
成功率要多高才能上線?
看流程的出錯代價。只產出草稿、由人確認後才送出的流程,門檻可以低一點;直接寫入系統或對外寄送的流程,門檻要高,而且要看多次執行都成功的比例。門檻應該由業務單位訂,寫進驗收條件。
可以用 AI 來評分 AI 嗎?
可以,而且能大幅省下人工。前提是先用一批人工評分過的案件校準,確認 AI 評分和人的判斷一致,之後也要定期抽查執行紀錄。
模型升級之後要重新驗收嗎?
要。模型、提示、工具或流程任何一項改變,都要重跑回歸測試。有測試集的團隊可以在幾天內確認新模型能不能換,沒有測試集的團隊往往要花好幾週重新試。
並行運作要跑多久?
我建議至少涵蓋一個完整的業務週期,例如一到兩週,讓月初、月底或出貨日這些比較忙的時段都被跑到。比對結果穩定、新的差異類型不再出現,再進入正式上線。
參考來源
以下依各組織公開文件整理,工具功能與服務期程以官方頁面當下為準。