做 AI 搜尋競品缺口分析的方式,是先固定題庫、競品集合、事件定義與證據範圍,再把同一組問題下的回答要點、來源 URL、適用條件和頁面證據攤成一張 gap matrix。這適用於要把競品觀察變成內容待辦的團隊;競品出現在回答裡不代表它的頁面比較好,自有來源被引用也不代表主張被支撐——兩邊都要打開頁面核對。本文提供的是可以照著建表的東西:五種 gap 的分類、三層比較單位、Evidence Matrix 的欄位與範例、四欄優先排序、五步實作流程,以及競品分析推不出來的市場結論。
先擋掉一種最常見的報告:「競品 A 被提到 8 次,我們 3 次」。這句話裡沒有任何可以交辦的東西——你不知道那 8 次裡有幾次說錯了它的產品類別,也不知道我們那 3 次是不是每次都缺了導入限制。缺口要拆開,才變成工作。
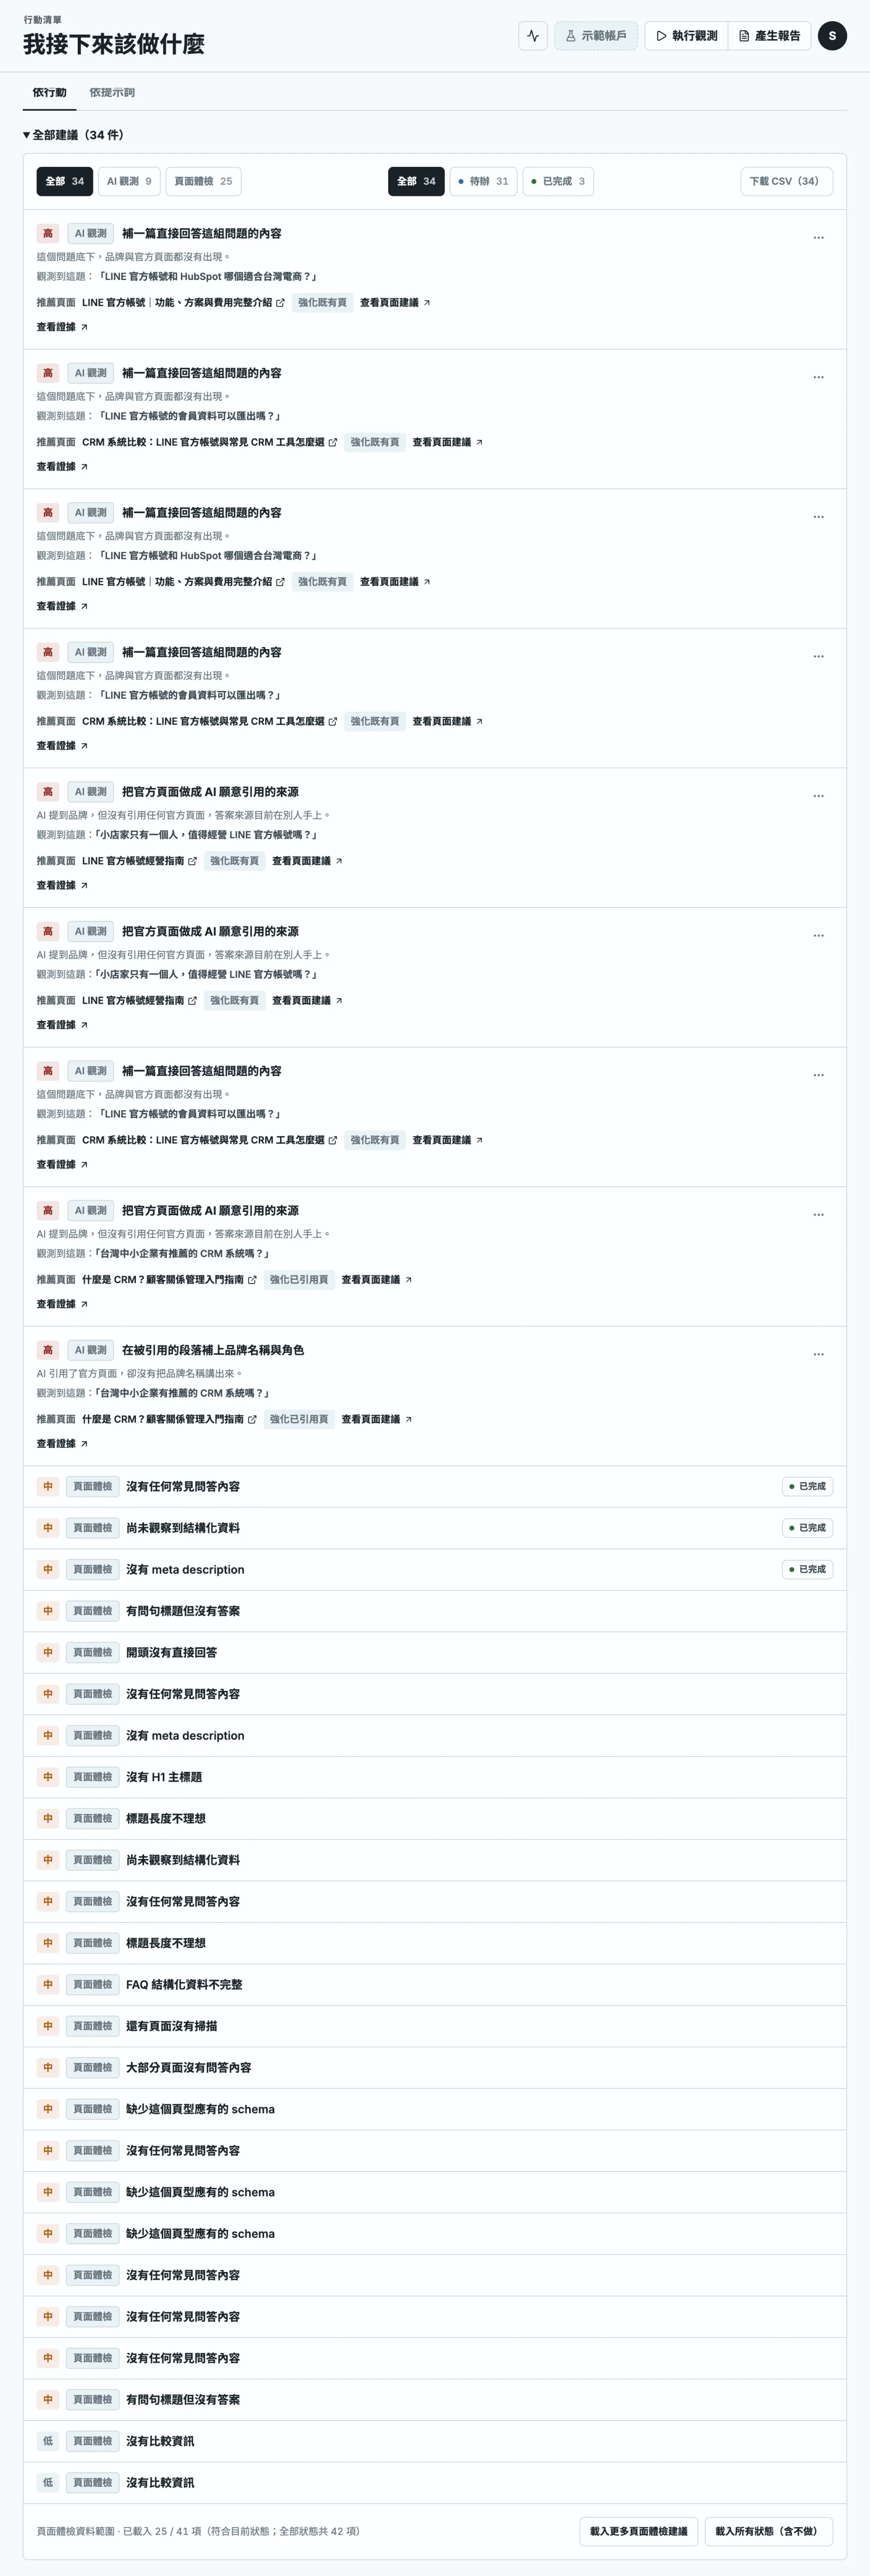 Otlex 示範帳戶的行動清單,示意觀測結果如何接回待辦;畫面資料不代表競品資料或市場排名。
AI 搜尋競品缺口分析:先定義 gap 是什麼
「缺口」不是「你的品牌沒出現」這麼一句。本文把 gap 分成五種,好把觀察對應到後續工作:
| Gap 類型 | 觀測問題 | 內容工作方向 |
|---|---|---|
| Entity gap | 品牌或產品類別描述是否清楚 | 實體名稱、公司關係、產品類別 |
| Answer gap | 回答是否涵蓋題目要點 | 補定義、步驟、條件、限制 |
| Source gap | 自有頁面是否出現在可見來源 | 檢查主題對齊、URL、頁面可讀性 |
| Evidence gap | 主張是否能回到可核對來源 | 補第一手資料、日期與引用關係 |
| Decision gap | 決策題是否有適用條件與取捨 | 補受眾、情境、限制與理由 |
這五種是分析工作的編輯框架,平台沒有以此作為公開分類。它們可以同時出現在同一個回答裡——品牌被提及但類別說錯(Entity),來源是第三方(Source),回答又漏掉導入限制(Answer)。只記一個「競品贏」,這三件事就一起消失了,下一步也無從開始。
比較單位:品牌、回答、來源與頁面
先固定題庫與競品集合
題庫要標記意圖、語言、地區、受眾條件和判讀要點。競品集合也要有版本,寫清楚是預先選定的同類產品、回答裡實際出現的品牌,還是題目指定的候選。集合改變時重新標版本——分母悄悄換掉的比較,是這類報告最常見的失效方式。
回答層看事件,頁面層看證據
回答層記錄品牌提及、推薦判讀、回答涵蓋和可見來源;來源層保存 URL、網域、redirect、canonical 和讀回日期;頁面層檢查那一頁是不是真的交代了產品能力、適用情境、限制或步驟。三層用 id 串起來——頁面存在就自動填入回答 citation,等於把「我們有這一頁」寫成「AI 引用了這一頁」。
不把排序當成主要比較單位
AI 回答中的品牌順序會依問題、時間、模型、搜尋模式和來源組合改變。位置可以保存成上下文,競品 gap 分析的主單位則是「同一題目下哪個要點有證據、哪個來源核對得動」。要理解事件份額,已發布的 AI Visibility 量測方法另有分母說明;本文不把 SOV 和 gap matrix 合併成一個分數。
Evidence Matrix:怎麼記錄缺口證據
每一題先保存共同資料
prompt_set_version    題庫版本
prompt_id             題目編號
intent                認知/比較/決策
engine                引擎
language_region       語言與地區
observed_at           觀測時間
answer_id             回答編號
raw_answer_ref        回答原文位置
brand_events          品牌事件
visible_source_refs   畫面上出現的來源
review_status         人工覆核狀態
這是資料結構示例,不是實測結果。所有品牌都用同一套欄位記錄再比較——只保存自己品牌的缺口、沒有競品回答、來源和題目上下文的話,那張表只證明你查過自己。
再逐一標記回答要點
題目若要求比較「適用團隊、觀測內容、資料保存、導入限制」,就建立四個 point_id。每個品牌或方案標記 complete、partial、absent、misplaced 或尚未判定,並保留回答句子和來源 URL。要點覆蓋的分層可先對照已發布的 AI 可見度量測方法,再依本文的 Evidence Matrix 保存競品差異。
Evidence Matrix 範例
| 題目要點 | 自有品牌回答 | 競品 A 回答 | 競品 B 回答 | 可讀來源 | 缺口分類 |
|---|---|---|---|---|---|
| 適用團隊 | 待核對 | 有條件 | 只列名稱 | URL 或未取得 | Decision gap |
| 核心觀測內容 | Answer gap | ||||
| 資料保存 | Evidence gap | ||||
| 導入限制 | Source gap |
表格中的空白是示意,任何品牌的實際結果都不長這樣。正式分析要把每個空白區分成未觀測、未提及、部分、來源不可讀或尚未判定——五種狀態壓成一格空白,「沒有資料」就會在下一次會議被讀成「競品沒有能力」。
把品牌敘述和來源證據分開
競品回答說「適合大型團隊」,那是一個回答主張;來源頁若沒有團隊條件、或引用的是別的內容,Evidence Matrix 就保留支撐狀態。你自己的品牌回答一樣處理——來源在自有網域,不會讓它自動變成完整證據。OpenAI ChatGPT Search 說明提醒 citations 可能不完整、過時或錯誤,重要內容要打開原始來源核對。
優先排序:哪些 gap 先處理
先依讀者任務,而不是依競品數量
缺口若位在高意圖決策題、而且會影響使用者理解產品適用條件,通常值得先核對;只是低意圖背景句的話,先放觀察清單。這是依題目任務和證據可用性提出的排序建議,不是市場共識或固定優先級。
用四個欄位做排序
| 欄位 | 問題 | 可填狀態 |
|---|---|---|
| User impact | 缺口是否妨礙題目決策 | high / medium / low |
| Evidence strength | 是否有可核對回答與來源 | strong / partial / weak |
| Ownership | 哪個頁面或內容可以處理 | page、entity、new-content |
| Change effort | 需要一段補充或整頁重構 | small / medium / large |
優先級別只用「競品有、我們沒有」來排。競品回答本身沒有可讀來源、或來源沒有支持主張的時候,把它列成需要核對的訊號——直接當成內容標準,等於照抄一個你還沒查證的東西。
建立工作假設
一筆行動清單可以寫成:「決策題中,多次看到競品 A 對適用團隊有具體條件,而自有頁沒有可引用段落,因此假設服務頁的受眾條件表達不足,先補一段可核對內容,再用固定題庫重測。」
這句話把觀測、推論和行動分成三段——誰在哪一段出錯,之後都找得到。頁面改完之後,回答會不會替換仍要經觀測窗口核對。
不用競品複製清單取代差異化
Google 生成式 AI 指南鼓勵建立對讀者有用且非同質化的內容,也提醒不要為每一個可能 query 大量建立重複頁面來操弄結果。競品 gap 的用途是找讀者問題與證據缺口——逐字複製競品段落、或把所有題型擴成大量薄頁,是往反方向走。
實作步驟:從題庫到行動清單
第一步,定義同一個比較問題
先選一個使用者任務,例如「台灣 B2B 團隊如何比較 AI 搜尋優化平台」,再決定題目條件、候選集合與必答要點。不同任務分開建表——認知題、故障題和推薦題混成一張 gap score,那個分數誰也解釋不了。
第二步,固定觀測條件
保存 prompt version、引擎或模式、語言、地區、裝置、時間、登入狀態與答案保存方式。Google AI Overviews 和 AI Mode 可能使用不同模型與技術,回答及連結集合會變動;跨引擎比較時把條件留在圖表裡。
第三步,按同一規則讀回答
先看回答是否有效,再標品牌提及和回答要點;接著讀可見來源,最後核對自有或競品頁面。來源 URL 的呈現與事件分層,可以先參考已發布的 Citation Tracking。每一筆判讀留一句短註記,另一位審核者才回得到原文。
第四步,建立 gap matrix 和 action list
每個 gap 連到:題目、回答、來源、頁面、分類、推論、建議動作、負責角色與重測條件。只留建議、沒有證據位置的話,下一輪分不出是原缺口還在,還是資料取得範圍變了。
第五步,修訂後回到同一題目
內容修改後用相同題庫與判讀規則重測。Prompt version 或 runtime 改變就另外標版本、分開比較。前後測試可以先參考已發布的 ChatGPT 品牌監測;本文的重點是把競品差異變成可執行缺口,而不是預先宣稱成效。
限制:競品 Gap 不能直接推出市場結論
Google Search Central 目前說明,AI features 仍與可抓取、可索引和 Search snippet 資格有關,符合要求仍可能遇到抓取、索引或提供差異。這支持網站維持基礎技術與內容品質;至於由某次回答的 competitor gap 推出市場排名或長期偏好,中間缺了太多層。
Google 生成式 AI 指南提供 Search Console 的 Generative AI performance report,讓網站團隊了解內容如何透過 Google 生成式 AI 功能被發現。那是 Google 搜尋端的官方報告入口,和跨七個引擎逐題比對競品回答的 gap matrix 不同;兩者可以並列參考,互相代替不了。
OpenAI ChatGPT Search 說明提醒 citations 可能不完整、過時或錯誤。競品來源頁也會更新、重新導向或只支持一部分主張,所以報告要保留讀回日期、URL 層級與來源支撐狀態。
Otlex 是 EthorX(伊索斯科技有限公司)開發的 AI 搜尋優化平台,觀測 ChatGPT、Google AI Overview、Google AI Mode、Gemini、Grok、Perplexity、Claude 等七個 AI 引擎回答中的提及、引用與推薦,協助整理內容缺口與後續觀測。產品能力說明的是觀測範圍;完整資料與固定結果仍需逐筆驗證。
相關概念與產品連結
若要先理解回答、提及、引用和推薦的事件分類,讀已發布的 品牌提及和引用 FAQ;要定義指標分母,讀 AI 可見度量測方法。想把 gap 觀察做成固定窗口,再讀 重複 AI 觀測 FAQ。
Otlex可觀測七個 AI 引擎的品牌提及、引用與推薦,協助把回答、來源與內容缺口整理在同一個觀測範圍。若要討論頁面調整與後續重測,可以從 EthorX GEO 服務了解服務方式,再依題庫和證據範圍評估。
常見問題
競品在回答中出現,我們沒有,就一定是內容缺口嗎?
先檢查題目、回答狀態、品牌別名、來源與判讀規則。競品出現可能只是一次回答事件;自有品牌沒出現也可能和題目條件、引擎、時間或資料取得有關。同樣條件下重複看到同類缺口,才適合提出內容假設。
競品被引用,代表它的頁面一定比較好嗎?
先核對來源 URL、頁面內容和回答相鄰主張——citation 可能只支援其中一段資訊,剩下的句子仍然沒有來源。Google 與 OpenAI 的官方文件都提醒搜尋和來源結果有變動或不完整的邊界,分析要保留日期和讀回狀態。
Gap Analysis 可以用一個總分排序品牌嗎?
內部設計摘要沒問題,前提是公開各類 gap 的權重、分母和資料狀態。本文建議先用 matrix 和 action list——一個「缺口分數」很容易把來源不可讀、未觀測和回答未提及混成同一格。
競品頁面要全部逐頁抄完嗎?
先按題庫中真正觀察到的來源與主張核對,記錄它們支持哪些要點,再依 User impact 和 Evidence strength 排序。沒出現在回答或來源裡的頁面,為了湊比較表而推測內容,那一欄就變成你自己寫的。
多久做一次 AI 競品缺口分析?
看題庫規模、內容更新速度、引擎可取得性和保存成本。固定條件的短窗口有助於追蹤修改,較長期間可以觀察題型和來源替換;兩者目的不同,報告裡分開寫。
查證邊界
本文外部文件查閱日期為 2026-09-21,使用 Google Search Central AI features、生成式 AI 搜尋指南,以及 OpenAI ChatGPT Search 說明。Gap 類型、Evidence Matrix、優先排序和 action list 是本文方法建議,不是平台公布的競品排名或市場標準。文中的「8 次對 3 次」、競品 A/B 都是說明用的假設情境。本文沒有使用未授權的競爭資料、客戶結果或單次回答推出市場結論;讀不到的來源保留待核對。