假設一個品牌固定測 40 題,報表顯示提及 14 題、官網引用 8 題、決策題推薦 5 題。這三個數字不能合成一句「AI Visibility 35%」就結束,因為它們的事件定義與分母不同。讀者真正需要知道的是哪一種可見度變了,以及能不能回到原始回答。
把 AI Visibility 當成單一總分,就像把體檢裡的血壓、視力和體重平均成一個健康分數,數字看起來整齊,判斷卻更模糊。
要把「被引用」拆成可回查的來源事件,可參考Citation Tracking;回答是否處理問題要點,則可看Answer Coverage。
準備讓不同團隊共用報表時,先用 AI 可見度資料契約 定義去重鍵、題目版本與分母;接著看 AI 搜尋監測 dashboard,把摘要卡接回原始回答、引用來源與待辦。
這跟健檢報告是同一個道理:一張只寫「健康指數 78」的報告,你不知道要看肝還是看血壓。問 ChatGPT 一題再截圖也一樣——那張圖證明了那一次回答發生什麼事,代表不了整體 AI 能見度。
一個 35% 的 AI Visibility,其實可能代表完全不同的事情
假設你固定測 40 題,得到:
- 14 題提到品牌
- 8 題引用自有網域
- 20 題屬於有選擇意圖的決策題,其中 5 題推薦品牌
更清楚的寫法不是「AI Visibility 35%」,而是:
| 指標 | 結果 | 代表什麼 |
|---|---|---|
| Mention Rate | 14 / 40 | 品牌出現在多少有效回答中 |
| Citation Rate | 8 / 40 | 自有網域被多少回答引用 |
| Recommendation Rate | 5 / 20 | 在決策題中被列為選項的比例 |
三個比例都和「可見」有關,各自回答的問題卻不同。14/40 說的是「品牌出現得多不多」,8/40 說的是「我的頁面被拿去當來源了沒」,5/20 說的是「有人要做選擇的時候,AI 把我算進去了嗎」——同一批回答,三種完全不同的診斷。
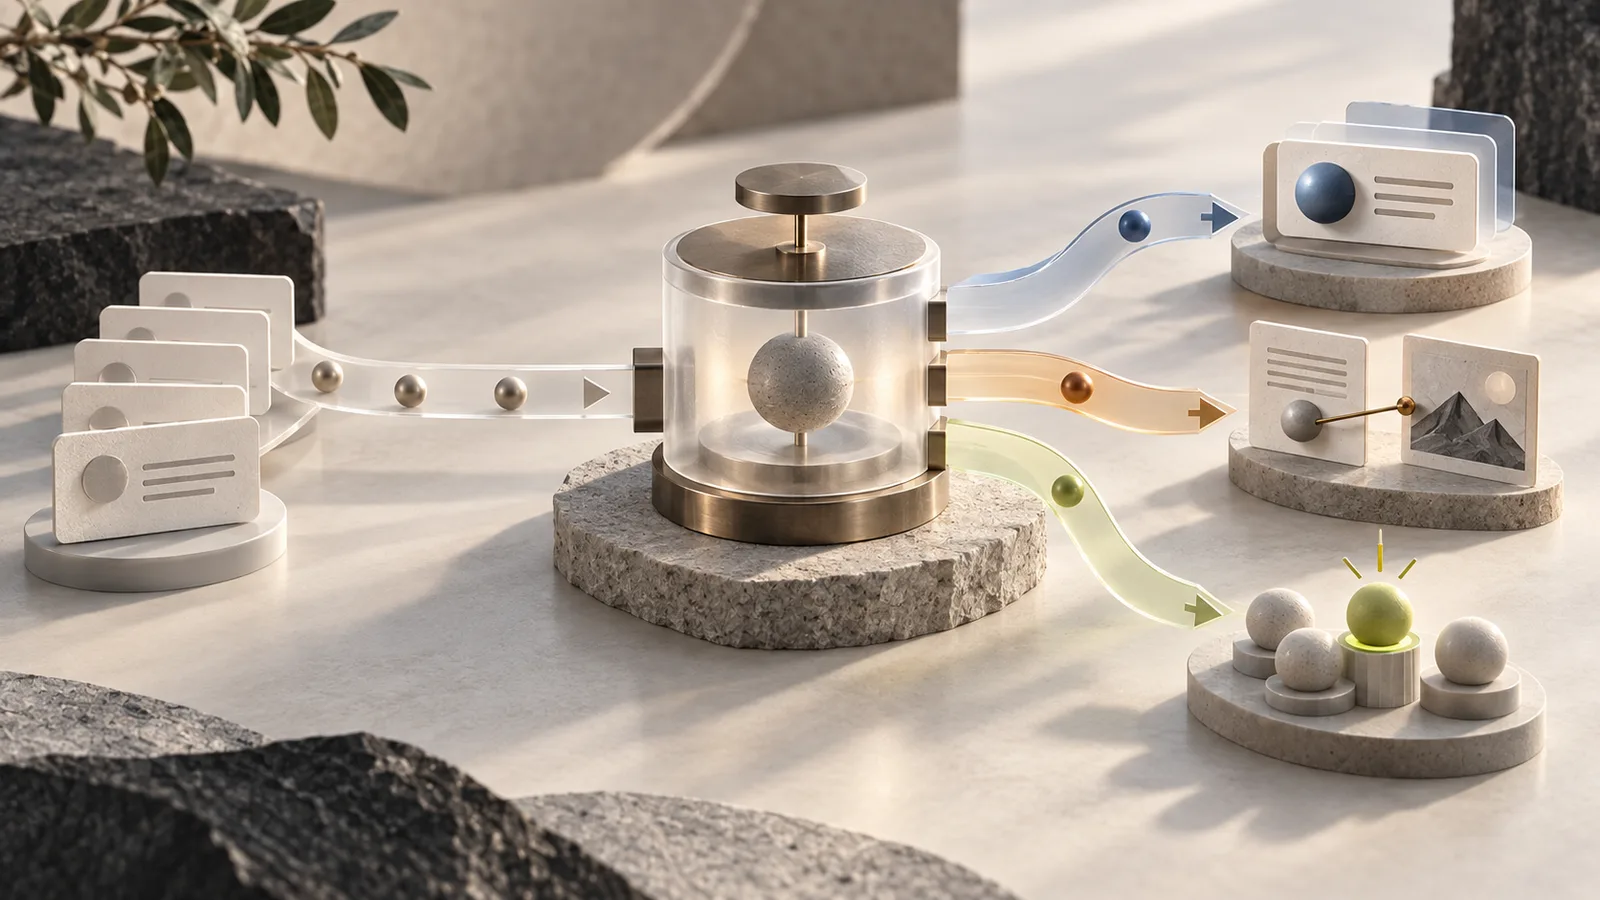
 概念示意圖:提及、引用與推薦各自計數、各自有分母,圖表才對得回原始回答。
如果你不知道分子與分母,一個精確到小數點的 Visibility Score 也很難判斷好壞。
分母比公式更重要
今天拿 10 題品牌題測、明天改成 100 題類別題,兩天的百分比沒有比較價值——就像昨天量體溫、今天量血壓,兩個數字都對,放進同一條折線圖就沒有意義。
因此,要做趨勢至少要固定:
- prompt 文字
- AI 引擎
- 語言或地區
- 觀測時間
- 有效回答規則
如果產品還能切換模型或搜尋模式,也應一併記錄。
題庫要調整時開新版本,別默默把舊題換掉。悄悄換掉一題之後看到的上升或下降,最有可能的解釋是題目變了——而那通常是最後才有人想到的解釋。
「有效回答」也要先講清楚
例如 40 次執行裡,有 2 次服務錯誤、1 次空回答。你的分母到底是 40,還是 37?
沒有唯一標準,但規則必須一致。
一個實用做法是另外保存 Answer Coverage:
| 指標 | 最小定義 | 範例 |
|---|---|---|
| Answer Coverage | 成功取得有效回答的觀測 / 預定觀測 | 38 / 40 |
| Mention Rate | 提到品牌的有效回答 / 有效回答 | 14 / 38 |
| Citation Rate | 引用自有網域的有效回答 / 有效回答 | 8 / 38 |
| Recommendation Rate | 決策題中推薦品牌 / 有效決策回答 | 5 / 20 |
這樣至少不會把「那天服務掛了」算成「品牌沒被提到」。兩者在報表上長得一模一樣,意義差很遠。
品牌題很容易把分數做漂亮
如果題庫全部都是:
- 「EthorX 是什麼?」
- 「Otlex 是做什麼的?」
- 「EthorX 有哪些服務?」
品牌被提到的比例當然可能很高。
但真正能看出市場可見性的,通常是不帶品牌名的題目,例如「台灣有哪些 GEO 顧問公司?」、「怎麼監測 ChatGPT 推薦?」、「B2B 公司怎麼做 GEO?」。
因此我會把題庫至少分成品牌、類別、比較、問題、決策幾種,再分開看結果。
你很可能會看到品牌題 mention 很高、類別題幾乎是零。這比一個總分有診斷價值得多:AI 知道你是誰——別人指名問起的時候答得出來——但在「這個問題該找誰」的場合還沒想到你。這兩件事要補的內容完全不同。
Google Search Console 能告訴你什麼,不能告訴你什麼
Google Search Central 目前說明,AI Overviews 與 AI Mode 會呈現 relevant links,符合資格的 supporting page 要先被 Google 索引;相關網站流量也會納入 Search Console 整體搜尋資料。
這些資料可以幫你看搜尋端的曝光與流量基礎。
但 Google 並沒有在這份文件提供逐題的品牌 mention rate 或 recommendation rate。所以如果你要回答「20 個問題裡有幾題提到我」,仍需要自己保存 prompt 與回答。
第一版 AI Visibility 儀表,試算表就能做
每一列可以是一個「題目 × 引擎 × 日期」的觀測單位,至少保存:
| 欄位 | 用途 |
|---|---|
| prompt_id | 固定題目版本 |
| engine | 回答平台或引擎 |
| observed_at | 觀測時間 |
| valid_answer | 是否為有效回答 |
| mention | 是否提到品牌 |
| citation | 是否引用自有網域 |
| recommendation | 決策題中是否推薦品牌 |
| source_url | 實際引用來源 |
如果同一題要跑三個引擎,就產生三筆觀測,不要把結果混在同一格。
當資料累積後,再看題型、競品、來源分布與時間變化。
Citation 高,和 Recommendation 高,是兩回事
研究文章可能很常被引用,但產品不一定因此成為推薦選項。
反過來,品牌可能被推薦,AI 的引用來源卻是媒體、論壇或第三方評論。
這兩種情況的內容策略不同:
- citation 高、recommendation 低:你可能是資訊來源,但產品與決策情境的連結不足
- recommendation 高、citation 低:品牌進入選擇,但 AI 沒有把官網當主要來源
這就是為什麼 mention、citation、recommendation 不該被壓成一個無法回查的單一分數。
AI Visibility 應該看趨勢,不要看一次答案
AI 回答本身會變動。同一題隔一天、換模型或搜尋模式,可能出現不同來源與不同品牌順序。
比較合理的做法,是保持題庫和條件穩定,持續重跑,再看一段時間內的分布。
如果要比較競品,也應讓所有品牌共享同一套題庫。否則每個品牌各自挑對自己有利的題目,Share of Voice 或 Visibility 都會失去比較意義。
Citation Tracking 與 AI Visibility 怎麼搭配
AI Visibility 告訴你「有沒有出現」;Citation Tracking 則把來源往下拆到網域與 URL。
例如 AI Visibility 顯示 citation rate 從 30% 掉到 15%,Citation Tracking 才能進一步回答:掉的是哪一批題目、哪幾個 URL,以及來源被誰取代。
如果你還在決定要量哪些平台,可先看 GEO 工具頁 與 EthorX GEO 服務 的工作範圍。
Otlex 如何處理 AI Visibility
Otlex 是由 EthorX 開發的 AI 搜尋優化平台。我們觀測品牌在 ChatGPT、Google AI Overview、Google AI Mode、Gemini、Grok、Perplexity、Claude 等引擎回答中的提及、引用與推薦,並保留可回看的結果。
它的重點不是只留下總分,而是讓結果能回到「哪一題、哪一天、哪個引擎、哪個來源」。當網站內容修改後,也能用相同問題重新觀測。
常見問題
AI Visibility 越高就代表流量越高嗎?
AI 回答中的出現和網站點擊是兩種事件,中間還隔著介面、引用方式與使用者行為——有時候回答講得夠完整,使用者反而不需要點進來。要評估商業效果,另外接網站流量與轉換資料。
AI Visibility 應該每天量還是每週量?
看題庫規模、內容更新頻率和你想看到的變化速度。比頻率更重要的是題庫與執行條件保持一致——每天量、但每次題目都不一樣,累積出來的是一堆互相矛盾的點。
同一題要測幾個 AI 引擎?
先依客群實際的使用情境選。挑幾個主要平台建立穩定基準,之後再擴充——一次鋪滿七個引擎、每個只跑一輪,得到的是七份都還不能比較的資料。
Mention 和 Citation 哪一個比較重要?
兩者回答不同問題。Mention 代表品牌進入回答內容;Citation 代表來源連到你的網站。品牌認知、內容來源、導流與後續優化可能各自需要不同指標。
可以把不同工具的 Visibility Score 直接比較嗎?
題庫、引擎、地區、時間、有效回答規則與公式六項全都相同時才可以——實務上很少發生。先看方法,再看分數;方法對不上的話,那兩個數字只是剛好都用百分比表示。