你在一家賣兒童汽車安全座椅的品牌負責行銷,九月中花了兩個星期,把主力款的產品頁重寫了一次,補上適用年齡、體重範圍,以及 ISOFIX(車上預留給安全座椅扣住的固定扣環)的安裝方式,九月底上線。
你們每個月一號會固定把同一批題目拿去問 AI 一輪。所以十月二號一早,你打開 AI 搜尋監測的儀表板,想看看這次改寫有沒有用,結果看到兩個方向相反的數字。第一個是品牌提及率,也就是 AI 回答裡有提到你們品牌的比例,從 40% 升到了 50%。第二個是引用率,也就是 AI 回答裡附上你們官網連結的比例,卻從 20% 掉到了大約 15%。
如果畫面上就只有這兩個數字,加上一綠一紅兩個箭頭,你根本沒辦法判斷產品頁到底改得好不好,也不知道接下來該繼續改其他產品頁,還是先停下來。因為引用變少,可能是改寫出了問題,也可能是 AI 換了別的網站當來源,甚至可能只是這個月有幾題沒跑成功,算比例的分母變了而已。
這篇我會一直拿這份十月的報表當例子,一路讀到你知道下一步該改哪一頁為止。
AI 搜尋監測儀表板長什麼樣子
我會建議把畫面由上到下分成三區,而看的人也照這個順序讀。在講三區之前先說明一個詞:題庫,指的是你固定拿來問 AI 的那一組問題,每個月都用同一批題目去問,前後的數字才比得起來。
- 範圍摘要:這份數字涵蓋哪段日期、問了哪幾個 AI 引擎(例如 ChatGPT、Google 搜尋裡的 AI 摘要)、用的是哪一版題庫,以及這一輪預定要問的 120 次裡,有幾次拿到了有效回答、有幾次失敗。有效回答指的是 AI 正常回答完、可以拿來判斷有沒有提到品牌的那幾次。
- 指標摘要:提及率、引用率這些比例,每張卡片都寫出分子、分母,以及這個比例是用什麼來算的,例如「提及率(以有效回答計)57/114」,意思就是分母用的是有效回答的次數。
- 證據清單:每一筆回答各佔一行,寫出題目、引擎、引用了哪些網址、你的判斷和下一步要做什麼,點進去還能看到 AI 當天的原始回答。
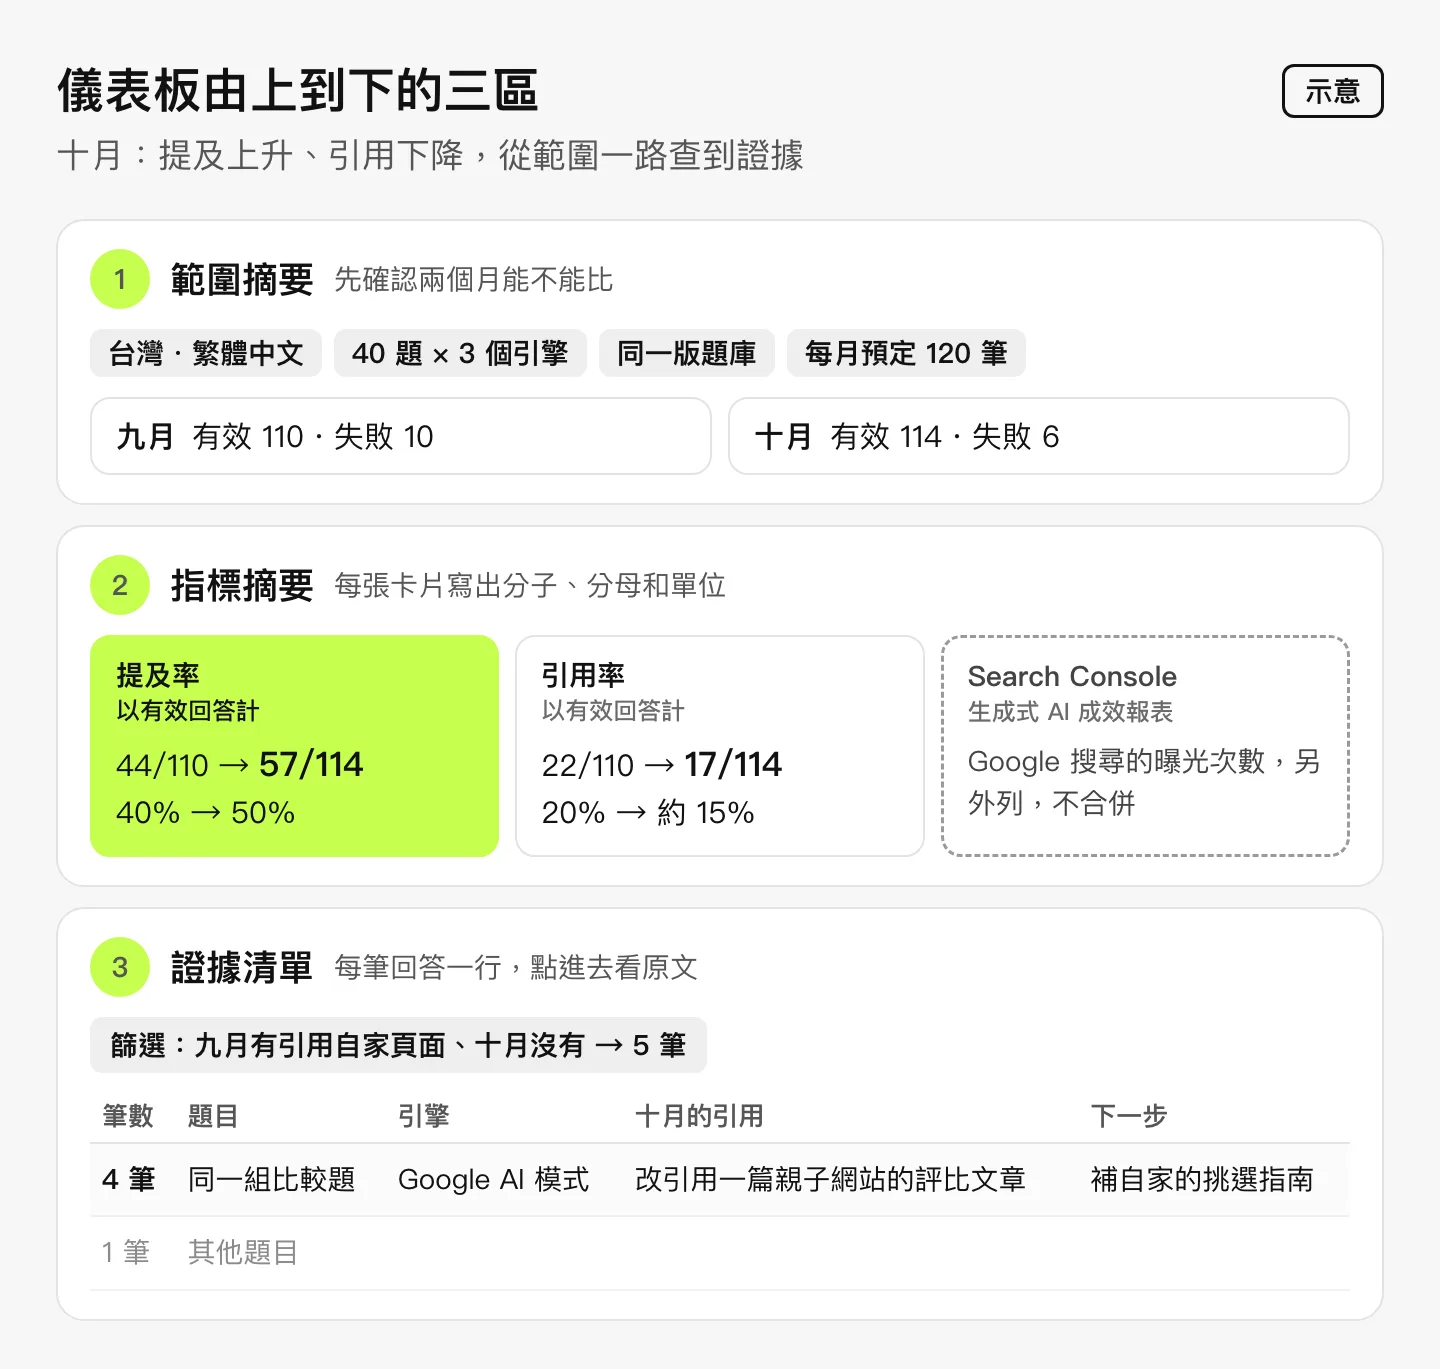 把十月的報表填進三區:先確認兩個月的條件相同,再看指標,最後從證據清單找出是哪幾筆回答換了來源。
先看範圍、再看指標、最後抽查證據,你才有辦法從一個往下掉的數字,一路查到是哪幾筆回答出了變化。下面就照這個順序,把十月這份報表從頭讀一次。
第一區:範圍摘要,先確認兩個月能不能比
這家安全座椅品牌的題庫有 40 題,每個月一號由監測工具自動把每一題拿去問三個 AI 引擎:ChatGPT、Google AI 摘要(AI Overview,Google 搜尋結果最上方由 AI 寫的那段摘要),以及 Google AI 模式(AI Mode,可以在 Google 搜尋裡接著追問的 AI 對話)。所以每一輪預定要問 120 次,每問一次就是一筆觀測。九月一號那一輪是在產品頁改寫之前跑的,剛好可以當比較的起點。
九月一號那一輪拿到 110 次有效回答,另外 10 次是 ChatGPT 那天連線出錯,監測工具沒有拿到回答。十月一號那一輪則拿到 114 次有效回答,失敗 6 次,而這 6 次剛好都是九月也失敗過的題目。
這些數字一定要寫在畫面最上面,因為它決定了下面的比例能不能拿來比。九月的 40% 是 44 除以 110,十月的 50% 是 57 除以 114,兩個月的分母本來就不一樣。如果範圍摘要沒有寫出來,看的人就會以為兩個月都是用 120 次在算,也不會知道九月其實少了 10 次。
那 10 次失敗,要在畫面上照實顯示成失敗,並寫出原因。如果你把失敗的那幾次也算成「沒有提到品牌」,九月就會變成 44/120,大約 36.7%,比實際少了 3.3 個百分點;十月變成 57/120,大約 47.5%,少了 2.5 個百分點。哪個月失敗得比較多,那個月的提及率算出來就比較低,這跟你的內容寫得好不好完全沒有關係。
所以我會讓每一筆觀測都標上一種狀態。十月只用到其中兩種,但另外三種,你在自己的資料裡遲早會遇到:
| 狀態 | 畫面上怎麼顯示 | 接下來要做什麼 | 十月的筆數 |
|---|---|---|---|
| 完成,原始回答也存下來了 | 顯示回答、引用網址和日期 | 判斷有沒有提到品牌、引用了哪一頁 | 114 |
| 只完成一部分 | 顯示少了哪些資料,例如有回答但沒存到引用網址 | 決定要不要重跑這一題 | 無 |
| 執行失敗 | 顯示錯誤訊息和發生時間 | 查監測工具的設定、帳號權限,或 AI 服務當天有沒有出問題 | 6 |
| 資料到了,還沒判斷 | 顯示「待判斷」 | 有人讀過原始回答、判斷完才算進比例 | 無 |
| 題目或引擎換過 | 顯示新舊版本差在哪裡 | 新舊兩段分開算比例,趨勢圖也分成兩段畫 | 無 |
最後一種最容易被忽略。比如說,如果你為了配合挑選指南改版,把題庫裡某一題的問法改了,那一題下個月的回答就要記成新版本,舊的資料照原樣保留,這樣你才知道哪幾題的條件已經不一樣了。題庫改版要怎麼管理,可以接著看題庫版本管理。以這家品牌來說,十月和九月用的是同一版題庫、同樣三個引擎,所以兩個月可以比,接下來才往下看中間的數字。
第二區:指標摘要,每個比例都寫出分子和分母
指標卡上的名字,要和它的算法寫在一起。十月有 114 次有效回答,其中 57 次提到了品牌,所以卡片上寫的是「提及率(以有效回答計)57/114,50%」。這個 50% 只代表這 40 題、這三個引擎的結果。
引用率最容易出問題,因為它有兩種常見的算法。AI 的一則回答通常會附好幾個來源連結,所以你可以用「回答」來算,也可以用「連結」來算:
- 以有效回答計:只要一則回答裡有任何一個連結指向你們官網,就算一次。十月 114 次有效回答裡,有 17 次是這樣,所以是 17/114,大約 15%。
- 以引用筆數計:把十月所有回答附的來源連結一個一個數,一共 380 個。那 17 次引用官網的回答裡,有 4 次同時附了官網的兩頁,所以指向官網的連結是 17 加 4,共 21 個,算出來是 21/380,大約 5.5%。
兩種算法都可以叫引用率,但數字差了將近三倍。所以卡片標題要寫出「以有效回答計」或「以引用筆數計」,看的人才知道 15% 和 5.5% 講的是兩件事。好幾組數字要合併成一份報表時分母怎麼算,可以看多組數字合併時的計算規則。
另外要記得,這家品牌一輪只有一百多次回答,所以只要差個五次,比例就會跳好幾個百分點,5 除以 114 大約就是 4.4 個百分點。引用從九月的 22 次變成十月的 17 次,差的也就是 5 次。所以箭頭變色的時候,我會先到證據清單,看這幾次變化是不是集中在同一組題目。
最後,Google Search Console 的數字我會在指標區另外放一張卡。Search Console 是 Google 給網站管理者看搜尋成效的免費工具,裡面有一份生成式 AI 成效報表,記的是 Google 搜尋的 AI 摘要和 AI 模式顯示你網站連結的次數。
這份報表的單位是曝光次數,跟你自己去問 AI 得到的提及率、引用率不一樣,所以做成獨立的一張卡,卡片上寫明「Google 搜尋,曝光次數」。
第三區:證據清單,從數字回到原始回答
證據清單是一張每筆回答各佔一行的表,每一行至少要有日期、題目、引擎、有沒有提到品牌、引用了哪些網址、你的判斷和下一步。重點是每一行都要點得到 AI 當天的原始回答,因為三個月後如果有人問「這一筆為什麼算成有提到品牌」,你要拿得出原文給他看。
篩選之前,有一個規則要先講好:只拿兩個月都拿到有效回答的題目來比。比如某一題九月有引用你,十月剛好連線失敗,它就沒有十月的回答可以比,不能算成「十月沒有引用」。
回到十月的報表。你在證據清單篩出「九月有引用官網、十月沒有」的回答,一共有 5 筆,而反過來篩「九月沒有、十月有」,是 0 筆。九月失敗、十月才拿到回答的那 4 次,也都沒有引用官網。所以引用從 22 次變成 17 次,就是少了這 5 筆:
- 4 筆是同一組比較題,全部發生在 Google AI 模式。九月這幾題引用的是你們官網的「安全座椅怎麼挑」指南,十月改成引用一個親子網站的安全座椅評比文章。
- 另外 1 筆是其他題目,ChatGPT 這次有正常回答,只是沒附任何來源連結。
這裡的比較題,是題庫裡請 AI 比較幾個品牌或產品的題目。題庫裡的題目要寫成顧客帶著自己處境去問 AI 的樣子,因為 AI 推薦的品牌和引用的網站,會跟著這些條件改變。這家品牌的題庫分成三種題型,下表最後一題的 R129,是聯合國歐洲經濟委員會訂的兒童汽車安全座椅規範,歐洲現在通用,家長比較產品時常會問到:
| 題型 | 關鍵字寫法 | 顧客實際會問 AI 的方式 |
|---|---|---|
| 推薦題 | 安全座椅 推薦 | 小孩一歲半、十二公斤,車子是轎車,有沒有可以一路用到四歲的安全座椅? |
| 比較題 | 安全座椅 比較 | 預算一萬元以內,常常要在兩台車之間拆裝,哪一款安全座椅比較適合? |
| 品牌題 | 品牌名稱 | 剛生第二胎,想再買一張給老大用,〇〇牌的安全座椅有通過 R129 嗎?保固怎麼算? |
十月被換掉來源的那 4 筆,就是第二列這種帶著預算和拆裝條件的比較題。題庫要分哪些題型、怎麼避免同一題換字重複,可以看 AI 搜尋題庫怎麼設計。
你九月重寫的那個產品頁,不在這 5 筆裡面,所以引用下降不是那次改寫造成的,真正被換掉的是那篇挑選指南。下一步也就很具體了:比對那篇評比文章寫了哪些你們指南沒寫的東西,例如依年齡和體重分段的建議、常見車款能不能裝,再把指南補齊。引用下降時,先在證據清單找出是哪幾筆換了來源,再去改那幾筆原本引用的頁面。
至於提及率為什麼上升,是另一件事,要用同樣的規則另外篩。在兩個月都有效的題目裡,「九月沒提到、十月有提到」的有 12 筆,「九月有提到、十月沒有」的有 2 筆。再加上九月失敗、十月才拿到回答的那 4 次裡,有 3 次提到了品牌。所以 44 加 12、減 2、再加 3,剛好是 57。
這 12 筆裡有 9 筆是 ChatGPT 的推薦題,也就是請 AI 推薦品牌的題目,回答裡寫到了適用年齡和 ISOFIX 安裝方式,正好是你九月在產品頁補上的內容;另外 3 筆分散在幾題比較題。不過這 9 筆回答都沒有附上你的產品頁連結,而適用年齡和 ISOFIX 也是安全座椅常見的資訊,所以還不能說 AI 是讀了你的產品頁,只能說方向對得上,值得下一輪再看一次。
儀表板背後要記哪些資料
要在試算表裡做出這三區,每一筆觀測至少要記六類資料。下表最右邊是十月這份報表用到它們的地方:
| 資料類別 | 至少要記的項目 | 十月報表用到的地方 |
|---|---|---|
| 範圍 | 市場、語言、引擎 | 確認九月和十月都是台灣、繁體中文、同樣三個引擎 |
| 題目 | 題目原文、題目編號、版本、題型 | 確認兩個月是同一版題庫,比較題沒被改過 |
| 執行 | 執行時間、狀態、錯誤訊息 | 找出九月那 10 次是 ChatGPT 連線失敗 |
| 回答 | 原始回答、原文怎麼保存、有沒有提到品牌 | 讀到 ChatGPT 推薦題寫了適用年齡和 ISOFIX |
| 引用 | 完整網址、頁面標題、取得日期 | 看出被換掉的是挑選指南,換成親子網站的評比文章 |
| 後續 | 要改的頁面、負責人、下一步 | 記下補挑選指南、由你負責、下一輪再看那 4 題 |
引用要記完整的網址,十月那 4 筆你才查得出被換掉的是挑選指南,而產品頁一直都在。「原文怎麼保存」就寫「全文」「截圖」或「只有摘要」,之後看的人才知道哪幾筆沒辦法重新判斷。這六類資料和 AI 能見度(你的品牌在 AI 回答裡被提到、被引用的整體情況)的定義怎麼對應,在 AI 能見度量測方法有完整說明。
用試算表和 Data Studio 做第一版
這個三區版面,用 Google 試算表加上 Data Studio 就做得出來。Data Studio 是 Google 的報表工具,可以把試算表裡的資料畫成卡片、表格和趨勢圖。它以前叫 Looker Studio,現在繁體中文介面上顯示的名稱是「數據分析」,你在介面上找這個名字就對了。我會這樣分工:
- 試算表放資料:開三張工作表,分別是觀測紀錄(每筆觀測一行,並給一個編號)、引用紀錄(每個來源連結一行,寫上它屬於哪個觀測編號)和後續工作(每件要改的事一行)。
- Data Studio 做畫面:在 Data Studio 裡,每接上一張工作表就要建一個「資料來源」,一個資料來源對應一張工作表,所以三張工作表要各建一個。建立資料來源的設定畫面上,記得勾選「將第一列做為標題使用」,欄位名稱才會是你寫的中文,而不是 A、B、C。Data Studio 預設每 15 分鐘重新抓一次試算表的資料;如果你是報表的編輯者,剛改完想馬上看,也可以在報表上按「重新整理資料」。
接好之後,三區分別這樣做:
- 範圍摘要:用觀測紀錄的「狀態」分別計數,十月會顯示有效 114、失敗 6,旁邊用文字寫上日期、引擎和題庫版本。
- 指標摘要:提及率卡片的分子是「有沒有提到品牌」等於「有」的筆數,分母是有效回答的筆數;引用率卡片照同樣的方式,用「有沒有引用官網」來算,卡片標題寫上「以有效回答計」。
- 證據清單:用表格接觀測紀錄,再加一個下拉式的篩選器(Data Studio 叫它「控制項」),依月份和「有沒有引用官網」篩選,就能篩出十月那 5 筆。
Search Console 那張卡,我會把生成式 AI 成效報表的匯出檔貼在第四張工作表。這份報表可以依網頁、國家/地區、日期和裝置分開看,但只有曝光次數,沒有點擊,也看不到使用者問了什麼。卡片說明裡要寫兩件事:
- 日期以太平洋時區為準:報表的日期一律用美國太平洋時間切,台灣時間早上的資料,可能被算在前一天。
- 沒有資料會變成 0:報表上顯示「~」或「-」的地方,下載下來會變成 0,看到 0 不一定代表那幾天完全沒有曝光。
等題目和引擎變多,每個月要新增上千行觀測紀錄的時候,試算表就會開始難用:跨月配對要靠一堆公式,篩選也會變慢,很容易算錯。那時候再考慮資料庫或現成的監測工具,這篇的六類資料和三區版面一樣用得上,只是改成由工具來產生資料。
我們開發的 Otlex 就是做這件事的:它每天用同一批題目去問 ChatGPT、Google AI Overview、Google AI Mode、Gemini、Grok、Perplexity、Claude,記下回答有沒有提到你、有沒有引用你的官網,並且把原始回答保存下來。如果你正在比較不同的工具,可以把這篇的六類資料帶去對照 AI 搜尋監測工具採購清單。
回到十月那份報表
一開始你只看到提及上升、引用下降兩個箭頭,不知道產品頁改得好不好。照三區讀完之後,你知道了四件事:
- 兩個月可以比:題庫和引擎都沒變,只是九月失敗的次數比較多,所以兩個月的分母不一樣。
- 引用下降不是產品頁改寫造成的:少掉的 5 次引用裡,有 4 次是挑選指南在 Google AI 模式被一篇親子網站的評比文章取代。
- 提及上升可能和改寫有關:多出來的提及裡,有 9 筆寫到了你在產品頁補上的內容,但還要再看一輪才能確定。
- 下一步要改的是挑選指南:補上依年齡和體重分段的建議,以及常見車款的安裝相容資訊。
所以你不用停下產品頁的改寫,而是把接下來兩週先花在挑選指南上。十一月一號那一輪跑完,用同一版題庫、同樣三個引擎再看一次那 4 題比較題,就知道 Google AI 模式有沒有改回引用你們的指南;同時也看那 9 題推薦題,提及是不是穩定下來了。
之後每次看到引用掉了,都可以照同樣的順序查:
- 先看範圍摘要,確認是不是失敗次數或題庫變了,讓分母不一樣。
- 分母沒問題,就到證據清單,看被換掉的是哪一頁,然後改那一頁。
- 被換掉的正好是你剛改過的頁面,才回頭檢查那次改寫。
改之前先記下哪些數字當比較的起點,可以看改版前怎麼記下第一份基準數字。
常見問題
AI 搜尋監測儀表板最重要的是哪一張圖?
我會先放範圍摘要,再放指標卡,因為少了範圍和分母,任何一張圖都很難讀懂。像十月的報表,如果沒有先看到九月失敗了 10 次,40% 到 50% 這個上升看起來就會比實際更像內容的功勞。至於下面要放什麼圖,就看團隊最常問什麼:最常問「是哪一頁被換掉」,證據清單的表格最重要;最常問「這半年有沒有變好」,才需要畫趨勢圖。
可以把品牌提及率叫成聲量占比(SOV)嗎?
聲量占比(Share of Voice,SOV)是拿你和競爭品牌比,看在同一批回答裡誰被提到的份量比較多,所以要先有一份固定的比較名單,例如這家品牌固定拿另外三個常被一起比較的安全座椅品牌來算,並寫清楚每次怎麼算、看哪些引擎、分母是什麼。只算自己的品牌在有效回答中出現的比例時,叫它「提及率(以有效回答計)」比較準確。聲量占比的算法可以看聲量占比的計算方法。
Search Console 的生成式 AI 成效報表可以和工具數字放在一起嗎?
可以放在同一個畫面上,但要分開列,並標明資料來源。Search Console 那份是 Google 搜尋顯示你網站連結的次數,而你自己的觀測是逐題的回答和提及,兩者的單位和範圍都不一樣,所以要各自一張卡片。
沒有原始回答,只剩摘要,儀表板還能用嗎?
可以當暫時的線索,但要在畫面上標明「只有摘要」和取得日期。少了原始回答,判斷就沒辦法重做,三個月後如果有人問「這一筆為什麼算成有提到品牌」,就沒有東西可以回頭查。
Otlex 的儀表板一定包含這篇所有的資料嗎?
不一定。Otlex 是由 EthorX 開發的 AI 搜尋優化平台,觀測品牌在 ChatGPT、Google AI Overview、Google AI Mode、Gemini、Grok、Perplexity、Claude 等 AI 引擎回答中的提及、引用與推薦;實際方案有哪些欄位、資料保存多久、能不能匯出,要以當下的產品說明為準,訂閱前可以直接問清楚。各家工具公開寫了哪些功能,可以先看 GEO 工具比較。
參考來源
以下依官方文件整理,Search Console 報表的開放範圍與 Data Studio 的功能名稱、更新頻率以官方說明當下為準。