先講一個很容易忽略的事實:內容改完、回答變了,中間可能什麼關係都沒有。引擎更新、題目版本、地區、時間、其他頁面變動,任何一個都可能在同一週發生。醫生不會因為病人吃藥後第二天好轉就寫下藥效證明,他會問這幾天還發生了什麼。
舉個例子。團隊同一週改了文章首段、首頁 FAQ 和產品頁標題,兩週後 AI 回答出現了新的引用。這個變化值得記錄,但功勞算不到其中任何一頁頭上;先列出同期間的所有變更,再決定這次只能做前後並列,還是有條件做更強的比較。Before After Test 像比賽錄影,兩場比賽要用相近規則、場地與計分方式,否則最後比較到的可能只是賽制。
這篇給你可以直接建檔的東西:測試問題的四個欄位、基線要保存什麼與三種品質狀態、change record 格式、觀測窗口與對照題的安排、前後事件表,以及哪些差異只能寫成假設。同一組問題怎麼固定下來,看重複 AI 觀測流程。
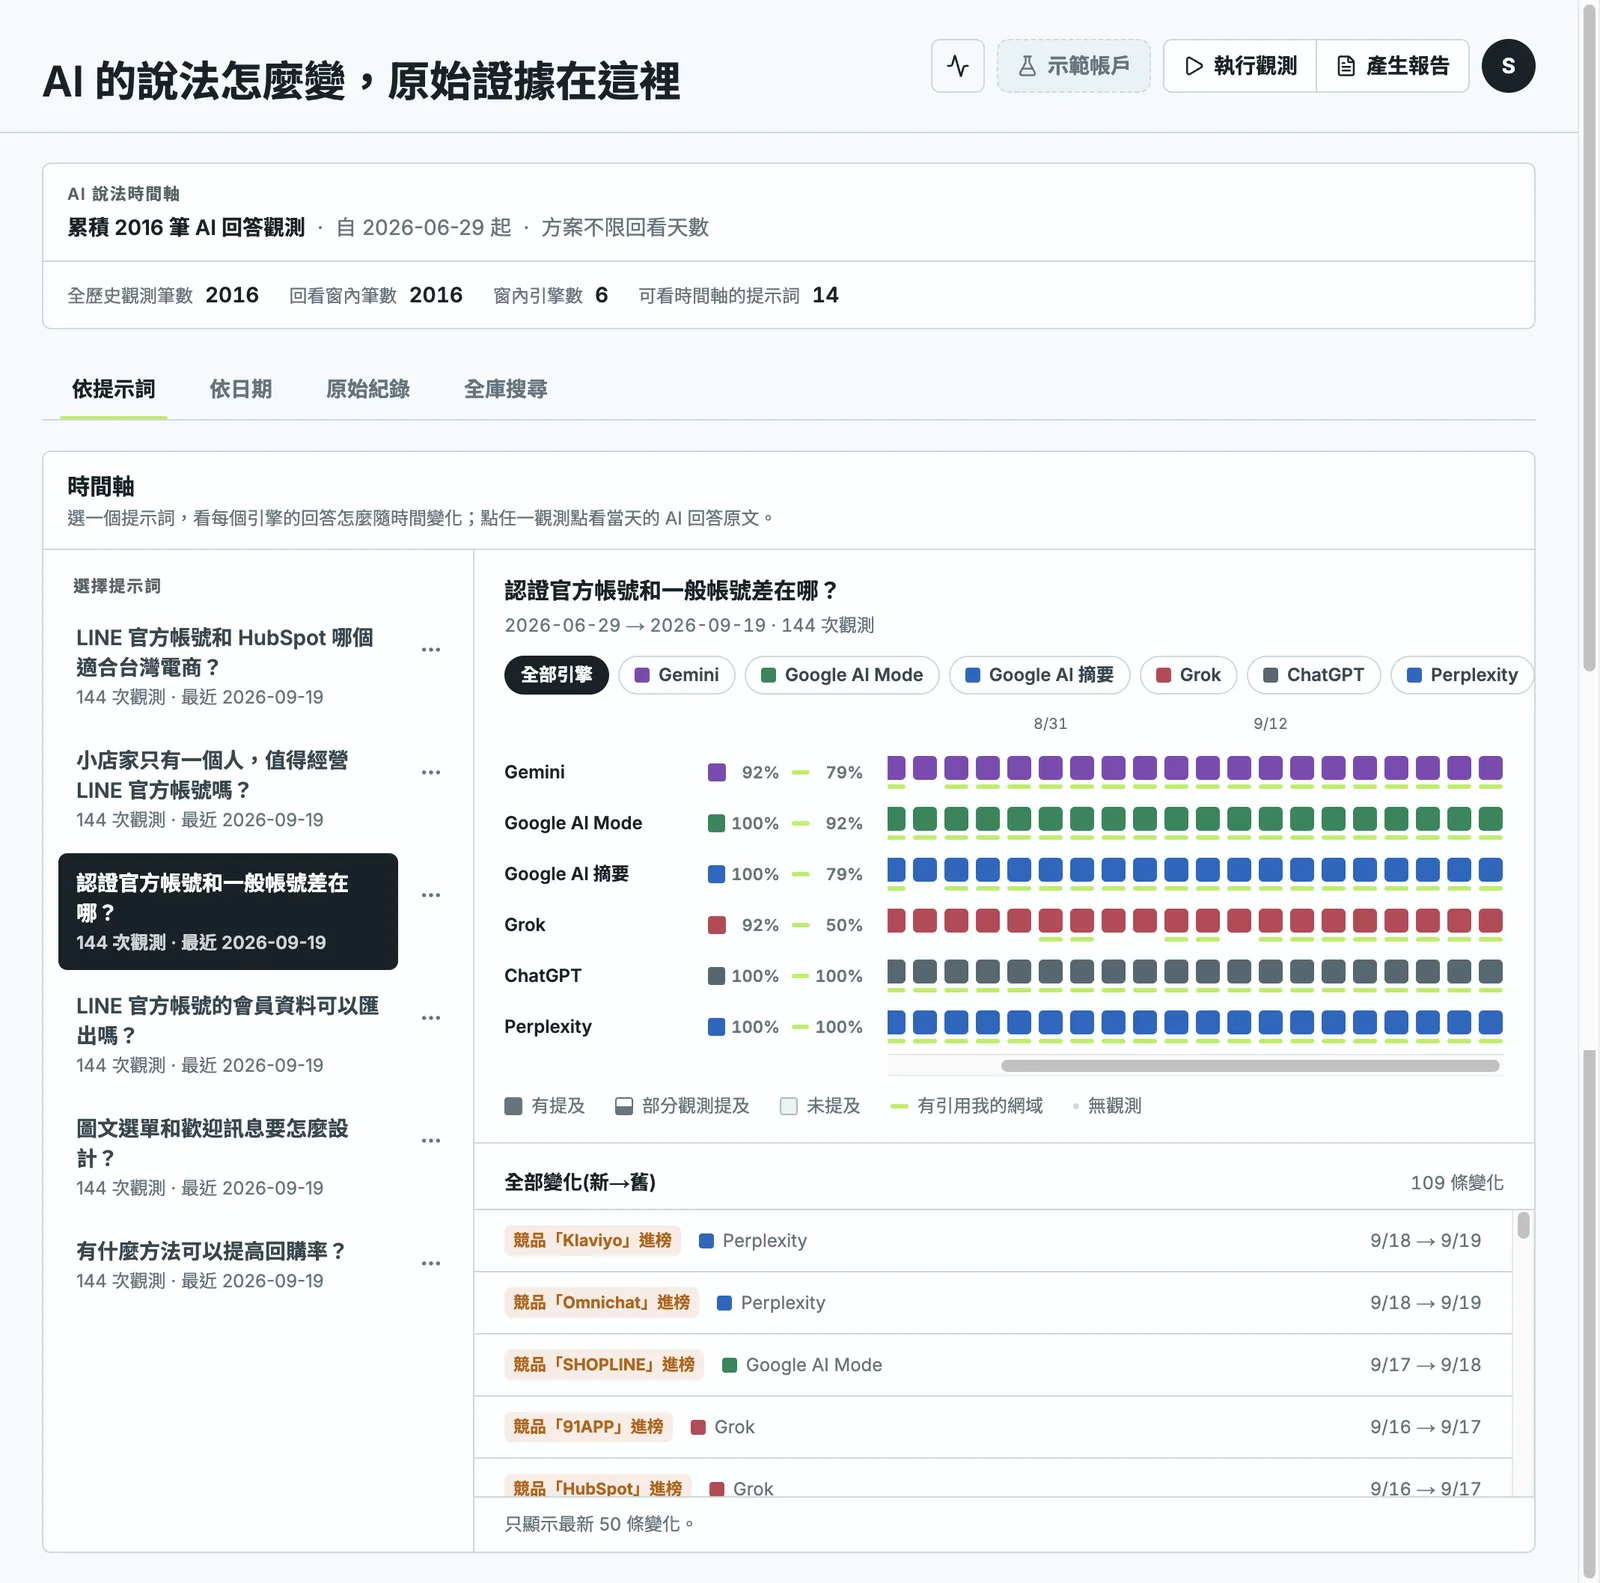 Otlex 示範帳戶的回答時間線,示意前後測要保存哪些欄位;畫面資料不代表修改造成結果或因果關係。
AI 內容修改前後怎麼測:先寫測試問題
測試要先有明確問題。比較這兩種寫法:
- 「改完內容後 AI 有沒有變好」:沒有對象、沒有題型、沒有事件,測完也不知道該看哪一欄。
- 「修改服務頁的適用情境段落後,固定決策題中的品牌提及、來源 URL 和回答要點是否出現差異?」:修改對象、題型和事件都在句子裡。
測試問題可以拆成四個欄位:
| 欄位 | 要寫清楚什麼 | 例子 |
|---|---|---|
| Change | 哪一頁、哪一段、什麼版本 | 服務頁適用情境段落 |
| Prompt | 哪組問題會受影響 | 固定決策題與問題題 |
| Event | 比較哪些回答事件 | mention、citation、coverage |
| Window | 何時測 before、何時測 after | 修改前 snapshot、後測窗口 |
不知道哪些問題可能受改動影響時,先用內容主題和使用者任務列出固定的一組問題,再把受影響的題型標成主要觀察集。
Before:如何建立修改前基線
保存基線回答,而不是只抄摘要
修改前要保存 prompt 文字、問題清單版本、引擎或模式、語言、地區、裝置、執行時間、回答原文、可見來源與判讀狀態。摘要可以放報表,原文才是後續核對差異的依據。後測發現「回答變了」的時候,你要比對的是句子,不是自己三週前寫的一行結論。
基線要記錄頁面狀態
除了回答事件,也保存修改前頁面的 URL、HTTP 狀態、title、主標題、相關段落摘要、canonical 和內容版本。頁面若還有同步變更,內鏈、圖片、schema、redirect,記在同一個 change scope。
只寫「文章已更新」的紀錄,兩個月後沒有人知道當初改了什麼,那一輪的資料就等於作廢。
基線品質分開標記
可用以下狀態:
| 基線狀態 | 條件 | 解讀 |
|---|---|---|
| ready | 回答、來源、題目和頁面版本完整 | 可進行前後比較 |
| partial | 部分回答或來源可讀 | 只能作背景,需註明缺口 |
| invalid | 題目或條件缺失 | 先修資料,再決定是否重跑 |
invalid 的意思是這一筆不適合當嚴格基線,和「內容表現為零」無關。基線只有一張截圖、看不到完整 prompt 或來源時,標 partial,別在報告裡把缺少的欄位補成看起來完整的樣子。
Change:怎麼記錄內容改動
把改動寫成可核對摘要
每個 change record 至少有:
change_id                 這次改動的編號
page_url                  改了哪一頁
content_version_before    改之前的版本
content_version_after     改之後的版本
changed_sections          新增、刪除、重寫、內鏈或結構變化
change_reason             為什麼改(假設就寫成假設)
changed_at                改動時間
other_changes_in_window   同一窗口內的其他變動
review_status             人工覆核狀態
change_reason 若是依回答缺口提出的工作假設,就明寫成假設。在這一欄寫成「已證明的原因」,之後整份報告都會沿著它偏掉。
把主要變因和同時變化分開
改了服務頁的產品描述,同週又改了首頁、FAQ、canonical 或網站語言版本的話,後測差異會受多個頁面影響。把主要改動列成 primary change,其餘列 concurrent changes。
報告不必因此停下,解讀要保守,並考慮另外開一個只改一個範圍的測試。other_changes_in_window 那一欄如果常常是滿的,通常代表測試設計該再收窄。
內容修改不等於一定會進入回答
Google Search Central 的 AI features 文件指出,頁面要先符合一般 Search 的索引和 snippet 技術要求,才具備成為 AI features supporting link 的資格;同時符合要求也不保證一定被抓取、索引或提供。內容改動記錄成一項待觀察變因;預先寫成「這次會帶來引用」,測試就變成在驗證一個已經下好的結論。
舉例:一筆文案修改怎麼記
假設你有一篇 SEO 工具比較文,原本寫「傳統 SEO 工具都看不到 AI 回答」,後來發現 Ahrefs、Semrush 都已經有 AI 觀測模組,決定改成按具體模組比較。這筆改動記下來大概長這樣:
| 欄位 | 填法 |
|---|---|
| 頁面 | 工具比較文的網址 |
| 段落 | AI 回答觀測那一節 |
| 改前 | 「傳統 SEO 工具都看不到 AI 回答」 |
| 改後 | 按 Brand Radar、AI Visibility 等具體模組比較題目、原始回答與引用網址 |
| 修改原因 | 原說法和產品現況不符 |
| 要觀察的問題 | 工具選型題的回答,是否還說傳統 SEO 產品沒有 AI 模組;來源有沒有指到這篇 |
| 同期其他變更 | 同一週調整的導覽與內鏈 |
改前改後的文字對照,只能證明說法改了。AI 有沒有採用新說法、有沒有引用這篇,要靠前後保存的回答與來源;搜尋點擊和詢價又是另外兩份資料。修改紀錄先寫清楚,後測才知道要比較哪一句。
想直接開始,可以下載五題繁中題組 CSV和空白觀測紀錄 CSV。題組有工具選型題、品牌描述題和一題 GEO 基礎對照題,拿到之後先換成自己的問題,再固定版本。
After:如何安排重測與對照
固定可比較條件
After 執行沿用同一 prompt version、問題清單版本、引擎或模式、語言、地區、裝置、判讀規則與來源保存方式。OpenAI Help Center 也提醒 ChatGPT Search citations 可能不完整、過時或錯誤,所以前後都保留來源核對狀態,別只看品牌有沒有出現。
設定觀測窗口
內容改完的第一個回答,不是長期結果。先依內容更新速度、平台可取得性和資料成本設定窗口,例如修改當天存一次、幾天後再存一次,或固定在指定日期重跑。
窗口越長,同時發生的變化越多。這是一個取捨,報告裡寫清楚就好。
保留對照題
問題可以分成主要觀察題、相關但未直接改動的對照題,和資料品質題。
要說清楚的是:對照題不是內容實驗設計裡的完整控制組,它消不掉外部變因。它的用途是看同一時間段有沒有更廣泛的回答變化;如果對照題也一起動了,那多半不是你那一段內容的功勞。題目分組在測試前決定,看完結果才挑一組當對照,等於自己選了一個對自己有利的基準。
前後事件表
| prompt_id | 題型 | Before answer | After answer | source change | coverage change | 判讀 |
|---|---|---|---|---|---|---|
| P-01 | 決策 | 保存 answer_id | 保存 answer_id | 待核對 | ||
| P-02 | 問題 | 保存 answer_id | 保存 answer_id | 待核對 | ||
| P-03 | 對照 | 保存 answer_id | 保存 answer_id | 背景 |
正式資料要把 answer_id 連到回答原文、來源 URL、觀測時間和內容版本。差異欄位留空代表還沒完成比對,意思不是「沒有變化」。
判讀:哪些差異可以寫,哪些只能列為假設
可以描述觀測到的差異
同一題、同一條件下,Before 的回答沒有自有來源、After 顯示一個自有來源 URL,那就可以寫:「After 觀測到自有來源呈現,來源 URL 為 X,需另核對頁面內容。」品牌提及出現時,寫明出現的句子和回答時間。
這些是事件描述,它們說的是「發生了什麼」,而且每一句都回得到原始資料。
需要保留的推論
「內容改寫使引用增加」是因果推論,需要更多控制與觀測才撐得住。就算測試只改了一頁,平台模型、來源集合、索引狀態或其他頁面都可能同時變動。
比較穩妥的寫法是:「在內容版本變更後的觀測窗口,出現 X 差異;內容改動是可能原因之一,仍需固定條件重測。」這句話交出去,下一個人知道要做什麼。
差異不只看總分
把回答拆成品牌提及、來源 URL、推薦條件和要點 Coverage。某一層變了、另一層沒動,可能代表回答改寫但來源仍未替換。這個資訊很有用,而它在總分裡會完全消失。事件層的定義看 AI 可見度量測方法;要點層用 Answer Coverage 的表保存狀態與分母。
寫出分母和失敗數
前後有效回答數不同時,先比較共同有效題組,再展示整體比例。執行錯誤、空回答、截斷或來源讀不回的資料另列;讓它們默默混進「未提及」,是這類測試最常見的失真來源。
Before After 證明不了因果
前後測能描述觀測窗口裡的差異,如此而已。Google 說 AI Overviews 與 AI Mode 可能用不同的模型與技術,回答和連結會變動;頁面符合技術要求,仍可能遇到抓取、索引或提供上的差異。OpenAI 也提醒 ChatGPT Search 的 citations 可能不完整、過時或錯誤,所以 After 出現 URL 也要打開原始來源核對。平台之後會不會持續同樣輸出、流量和轉換會怎麼動,都不在這份資料的範圍內。
Search Console 的生成式 AI 成效報表能看到內容怎麼被 Google 的 AI 功能發現,但它和逐題的前後事件表是不同資料層,一個替代不了另一個。
我們的 Otlex 是 EthorX 開發的 AI 搜尋優化平台,觀測 ChatGPT、Google AI Overview、Google AI Mode、Gemini、Grok、Perplexity、Claude 七個引擎回答中的提及、引用與推薦,並整理內容缺口,可以把內容修改和後續觀測放在同一份證據裡。要測哪些問題、改哪些頁、怎麼解讀差異,還是要按你的專案條件決定。
接下來可以看什麼
要先固定問題與 prompt,讀 AI 監測 prompt 選擇 FAQ;要管理比較版本與 baseline,看為什麼要重複 AI 觀測。要把執行和來源保存做成固定程序,接著看 ChatGPT 品牌監測。需要討論內容策略和頁面調整的範圍,EthorX GEO 服務有服務內容的說明。
常見問題
修改完內容後馬上重問,就能判斷是否有效嗎?
一次差異可以當事件記錄,離「有效」還很遠。先保存 Before、修改範圍、After 的回答和條件,再按預先決定的窗口重測。預先決定這四個字很重要,事後才挑一個時間點看,挑到的通常是好看的那一天。
Before 和 After 的題目可以略微改寫嗎?
目標是比較內容版本的話,prompt 維持相同。題目非改不可時,開新的 prompt version,兩組結果分開放。把新題目的回答當成舊題目的 After,等於同時換了兩個變因。
可以只比較品牌提及,不看來源 URL 嗎?
mention 可以當成一個獨立事件,只是它代表不了 citation 或回答完整度。內容改動的目標若是讓自有來源被採用,就要另存來源 URL、redirect、canonical 和主張支撐狀態。
對照題沒有變化,是否就能證明改頁面造成結果?
對照題提供的是同期間的背景,它不是完整控制組;引擎、索引、來源或其他頁面仍可能變動。可以把它當輔助證據,因果推論的限制照樣保留。
內容修改前後要觀測幾個引擎?
先選一組能穩定取得、也重跑得動的引擎,依市場和讀者使用情境決定,再記錄每個引擎的回答格式差異。Otlex 的產品範圍涵蓋七個 AI 引擎;問題和觀測資源要不要全涵蓋,是專案決策。