「AF-40 打樣要幾天?」業務在群組裡問了這週第三次。業務助理翻了兩份文件,找到兩個答案:2024 年那份業務常見問題寫 10 個工作天,9 月剛更新的交期表寫 7 個工作天。
這是一家做鋁合金零件的工廠。老闆希望業務能自己問 AI、不用每次在群組等人回,就把型錄、交期表、常見問題和包裝規範四份文件交給 IT 同仁,要他做成一個問答助手。他在 AI agent 平台比較時看過幾個平台,查文件回答問題正是 Dify 內建知識庫在做的事。
下面照他會走的順序寫,每一步我們都在 2026 年 10 月實際做過:在一台 Mac 上用 Docker 自架 Dify 1.17.1,放進四份文件(內容是我們寫的範例),做一個「業務查詢小幫手」,再拿業務最常問的六個問題測它。第一輪有三題答錯或答不完整,另外一題數字對了、出處卻講錯。
先決定用雲端版還是自己架
Dify 是一個做 AI 應用的開源平台,模型管理、知識庫(讓 AI 能查公司文件的資料庫)、提示詞和發佈都在同一個介面裡。它有兩種用法:
- 雲端版:到 Dify 官網註冊就能用。免費的 Sandbox 方案有 200 個 message credits(試用 Dify 提供模型的額度,用完要接自己申請的模型帳號)、5 個應用、50 份知識庫文件,每次只能上傳 1 個檔案。付費的 Professional 方案年繳每年 590 美元。
- 自己架:社群版免費,用 Docker(把程式連同它需要的執行環境打包好、在自己電腦上啟動的工具)跑在自己的電腦或主機上。Mac 和 Windows 用 Docker Desktop,Linux 用 Docker Engine;Windows 要先開啟 WSL 2(Windows 內建、能跑 Linux 指令的功能)。官方列的最低需求是 2 核心 CPU、4 GB 記憶體,還沒算本機模型;我們用的是 24 GB 記憶體的 Mac。
IT 同仁在比較時就說過,正式的流程要用雲端服務,因為公司沒有人能顧主機。只是交期表算內部資料,能不能放上雲端要老闆點頭,所以他先在自己的筆電上架一套試做,有了結果再去問。
步驟一:用 Docker 把 Dify 跑起來
電腦上要先裝好 Docker Desktop(Linux 是 Docker Engine),以及 git、curl 和 jq 三個在終端機裡打指令用的小工具。接著打開終端機(Mac 是「終端機」App,Windows 要在 WSL 裡打),照官方文件跑四行指令:
git clone --branch "$(curl -s https://api.github.com/repos/langgenius/dify/releases/latest | jq -r .tag_name)" https://github.com/langgenius/dify.git
cd dify/docker
cp .env.example .env
docker compose up -d
四行依序是:下載最新正式版的原始碼(我們當時是 1.17.1)、進到 docker 資料夾、複製一份預設設定檔 .env、把 Dify 需要的程式全部啟動。
我們跑起來的是 15 個容器(Docker 裡各自獨立執行的程式),包括 Dify 自己的服務、資料庫和向量資料庫。用 docker compose ps 確認它們都是 Up 或 healthy,就可以打開瀏覽器。
第一次要先開 http://localhost/install(localhost 指這台電腦自己)建立管理員帳號,之後用這組帳號登入。
Dify 預設用電腦的 80 號連接埠(電腦上給每個程式收發資料的編號),被別的程式占用時會啟動失敗。這時打開 .env,把 EXPOSE_NGINX_PORT 改成例如 8080,網址也跟著改成 http://localhost:8080。
步驟二:接上模型
Dify 本身不附模型。各家模型都是外掛,所以第一件事是到左側選單的「集成」,在「模型供應商」裡安裝外掛;外掛從 Dify Marketplace 下載,這台機器要能上網。
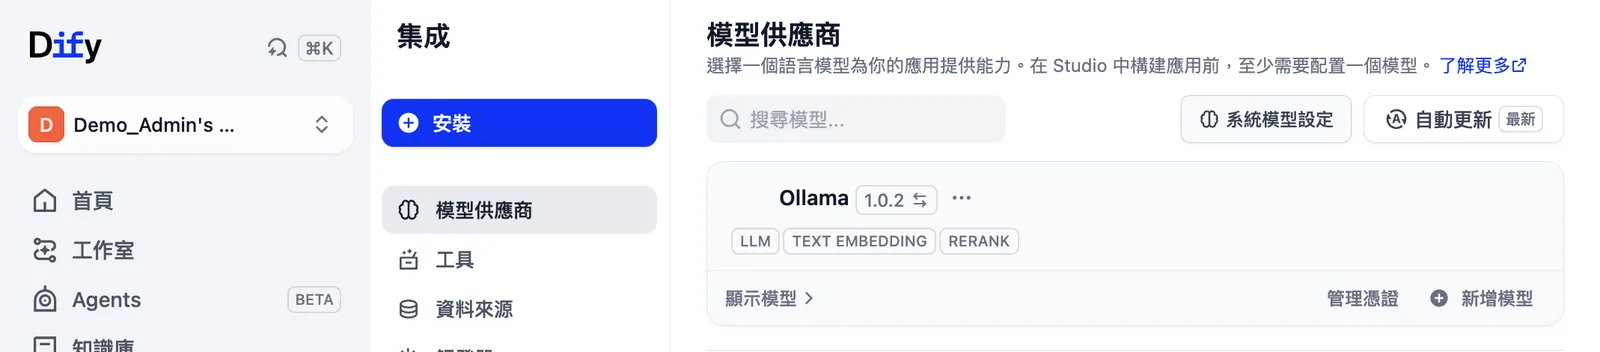
我們用的是同一台電腦上的 Ollama,一套在自己電腦上跑開源模型的免費軟體(安裝在 Ollama 教學)。在 Ollama 外掛裡新增兩個模型,Base URL(連線網址)都填 http://host.docker.internal:11434,讓容器裡的 Dify 連到本機的 Ollama(這個名稱由 Docker Desktop 自動提供,Linux 的 Docker Engine 要自己加上 host.docker.internal=host-gateway 的對應)。
- 回答用的模型:類型選 LLM(大型語言模型,負責讀資料、寫回答),我們用 gemma4:12b(12b 指約 120 億個參數,數字越大越吃記憶體),授權是 Apache 2.0,可以商用。
- Embedding 模型:類型選 Text Embedding。它把一段文字換成一串數字,Dify 用這串數字比對問題和文件哪幾段意思最接近。我們用 embeddinggemma(約 620 MB),授權是 Google 的 Gemma 使用條款。
加好後到「系統模型設定」確認兩個模型都選上了。
要改用 OpenAI、Anthropic、Gemini 等雲端模型,就是安裝那一家的外掛,填入那家發給你的 API 金鑰。API 是讓程式直接跟服務溝通的接口,金鑰是用來辨識身分和計費的一串密碼。換成雲端模型,差別在資料會送到哪裡:Embedding 模型用雲端,建知識庫時每一段文件都會送過去;回答用的模型用雲端,每次提問會送出找到的段落和問題。
步驟三:上傳文件建知識庫
到左側的「知識庫」建立一個新的知識庫,把文件拖進去。自架版的上傳頁寫明支援 PDF、Word(DOCX)、Excel(XLSX、XLS)、CSV、Markdown、TXT、HTML 等格式,每批最多 5 個檔案,每個不超過 15 MB。
我們放了這家工廠的四份文件:
- 產品型錄-2026.pdf:AF-40、AF-60、LB-25、LB-40 四個型號的尺寸、鎖附孔、材質寫成表格,後面是表面處理要多加的天數,例如黑色陽極處理加 3 個工作天、噴砂加陽極處理本色加 4 個工作天。
- 交期與起訂量-2026-09.xlsx:一個品項一行,寫起訂量、打樣天數、量產天數。AF-40 是起訂 200 件、打樣 7 個工作天、量產 15 個工作天。
- 業務常見問題-2024.docx:2024 年寫的問答集,裡面「打樣約 10 個工作天」已經過時。
- 出貨包裝規範-掃描.pdf:倉管課的紙本規範掃描檔,寫 AF-40 每箱裝 100 件。
下一步是「分段設定」。Dify 不會把整份文件交給模型,而是先把文件切成一段一段,每次提問只拿最相關的幾段去回答。預設是「常規」模式,用換行(分段識別符號 \n)切開,每段最長 1,024 個字元,相鄰兩段重疊 50 個字元。另一種「父子」模式切成大小兩層,用小段比對、回傳整個大段,適合長文件。索引方式選「高品質」,就是用剛才那個 Embedding 模型比對意思;「經濟」則只比對關鍵字。
有兩個設定建好之後就改不了:分段模式(「常規」或「父子」)不能換,選了「高品質」之後也不能改回「經濟」。這次文件都不長,用「常規」就好。
動手之前,先按「預覽資料塊(Preview Chunk)」看文件被切成什麼樣子。我們的型錄是這樣:
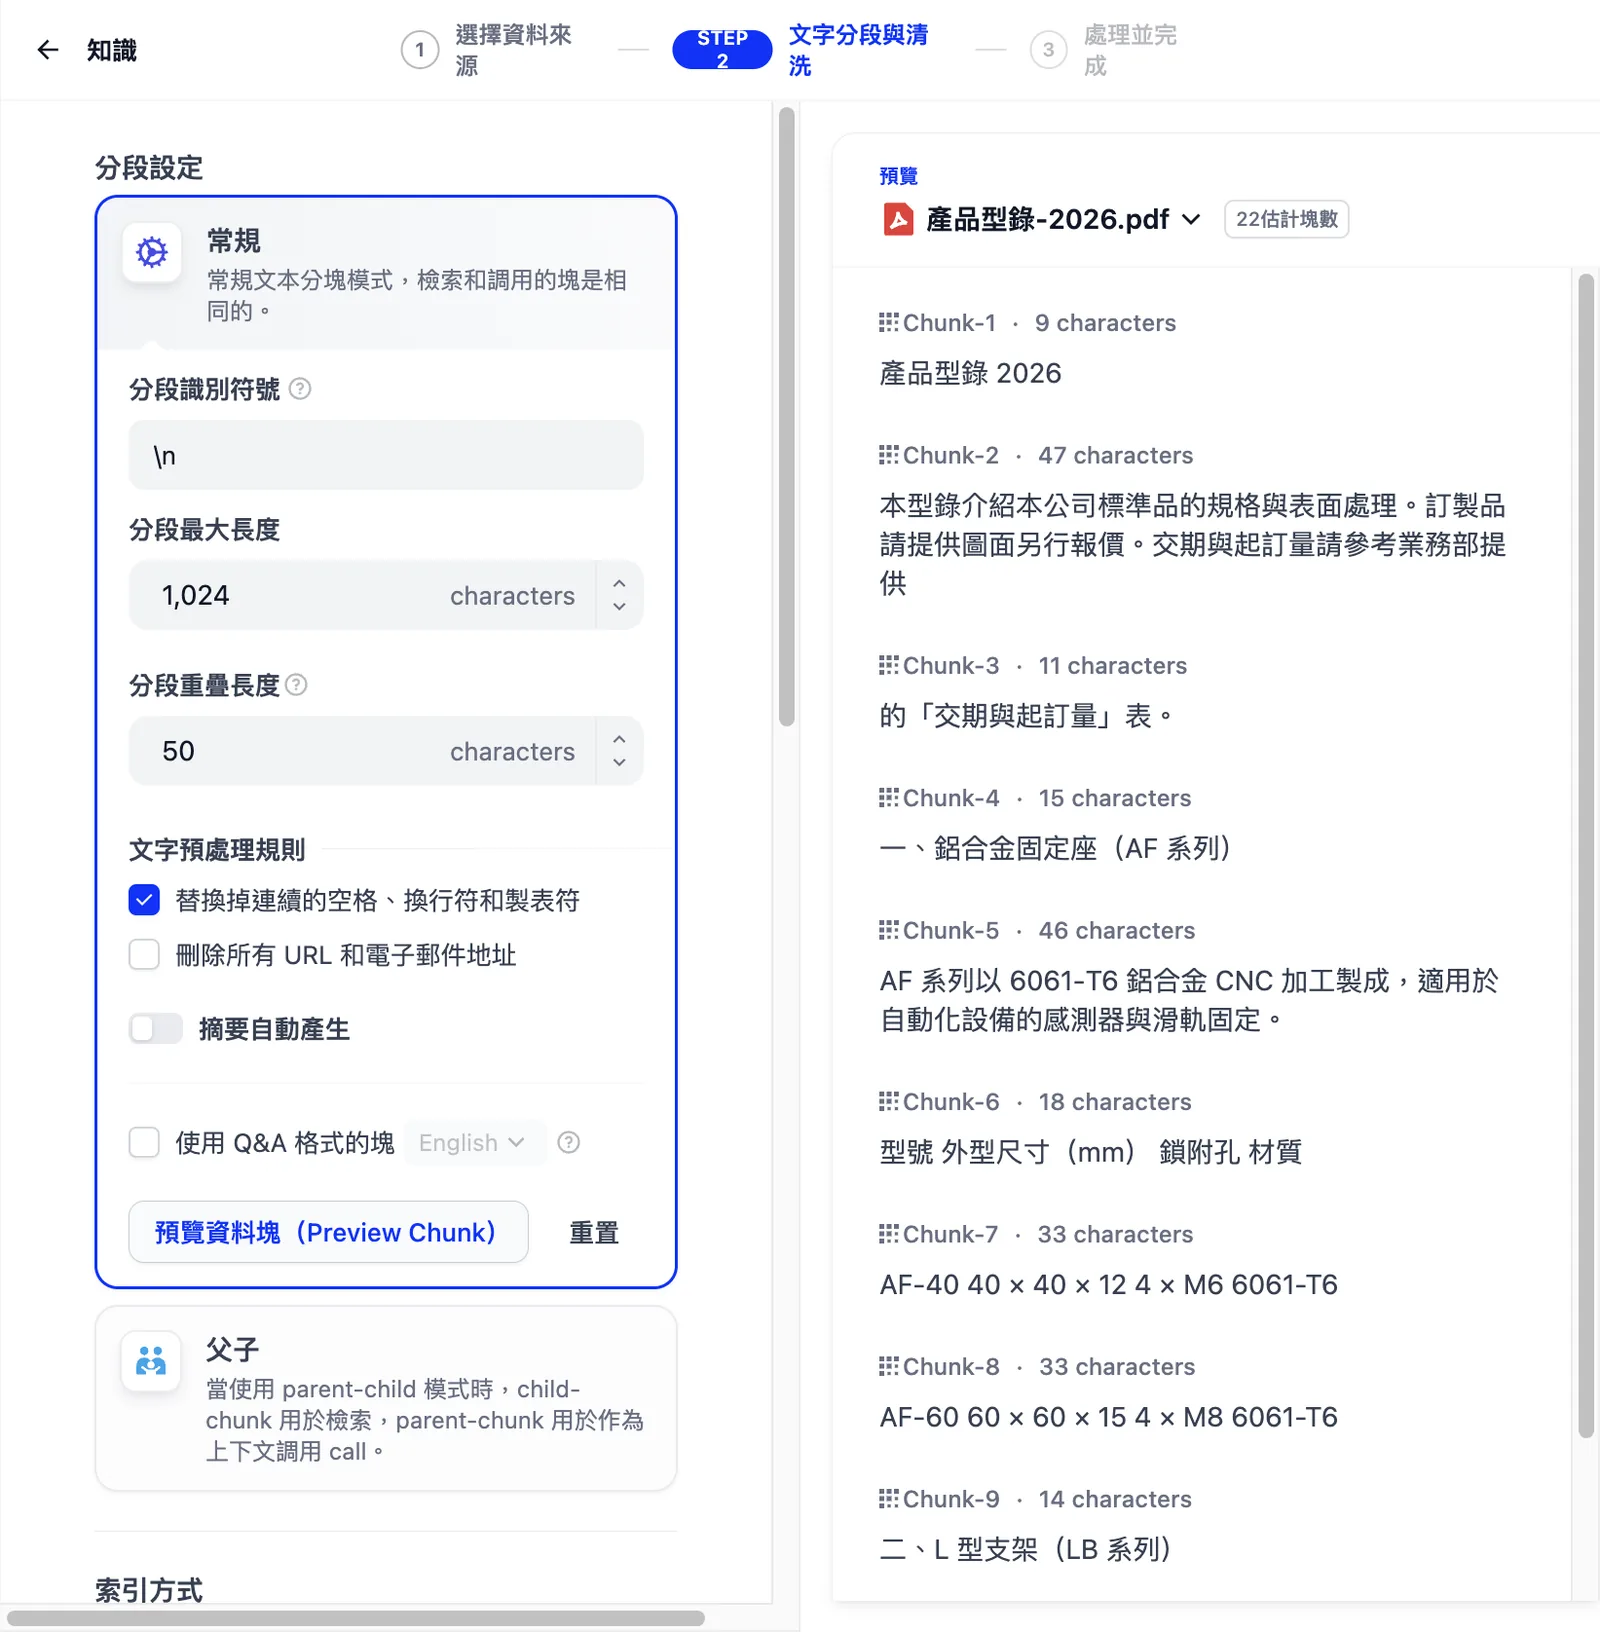
型錄被切成 22 段,表頭自己一段,每個型號只剩一串數字,一句話也在換行處被切斷。這次問鎖附孔時表頭剛好一起被找出來,型號一多就難說了;最穩的是像交期表那樣,每一行都帶著欄名。另外三份文件的結果整理成下面這張圖:
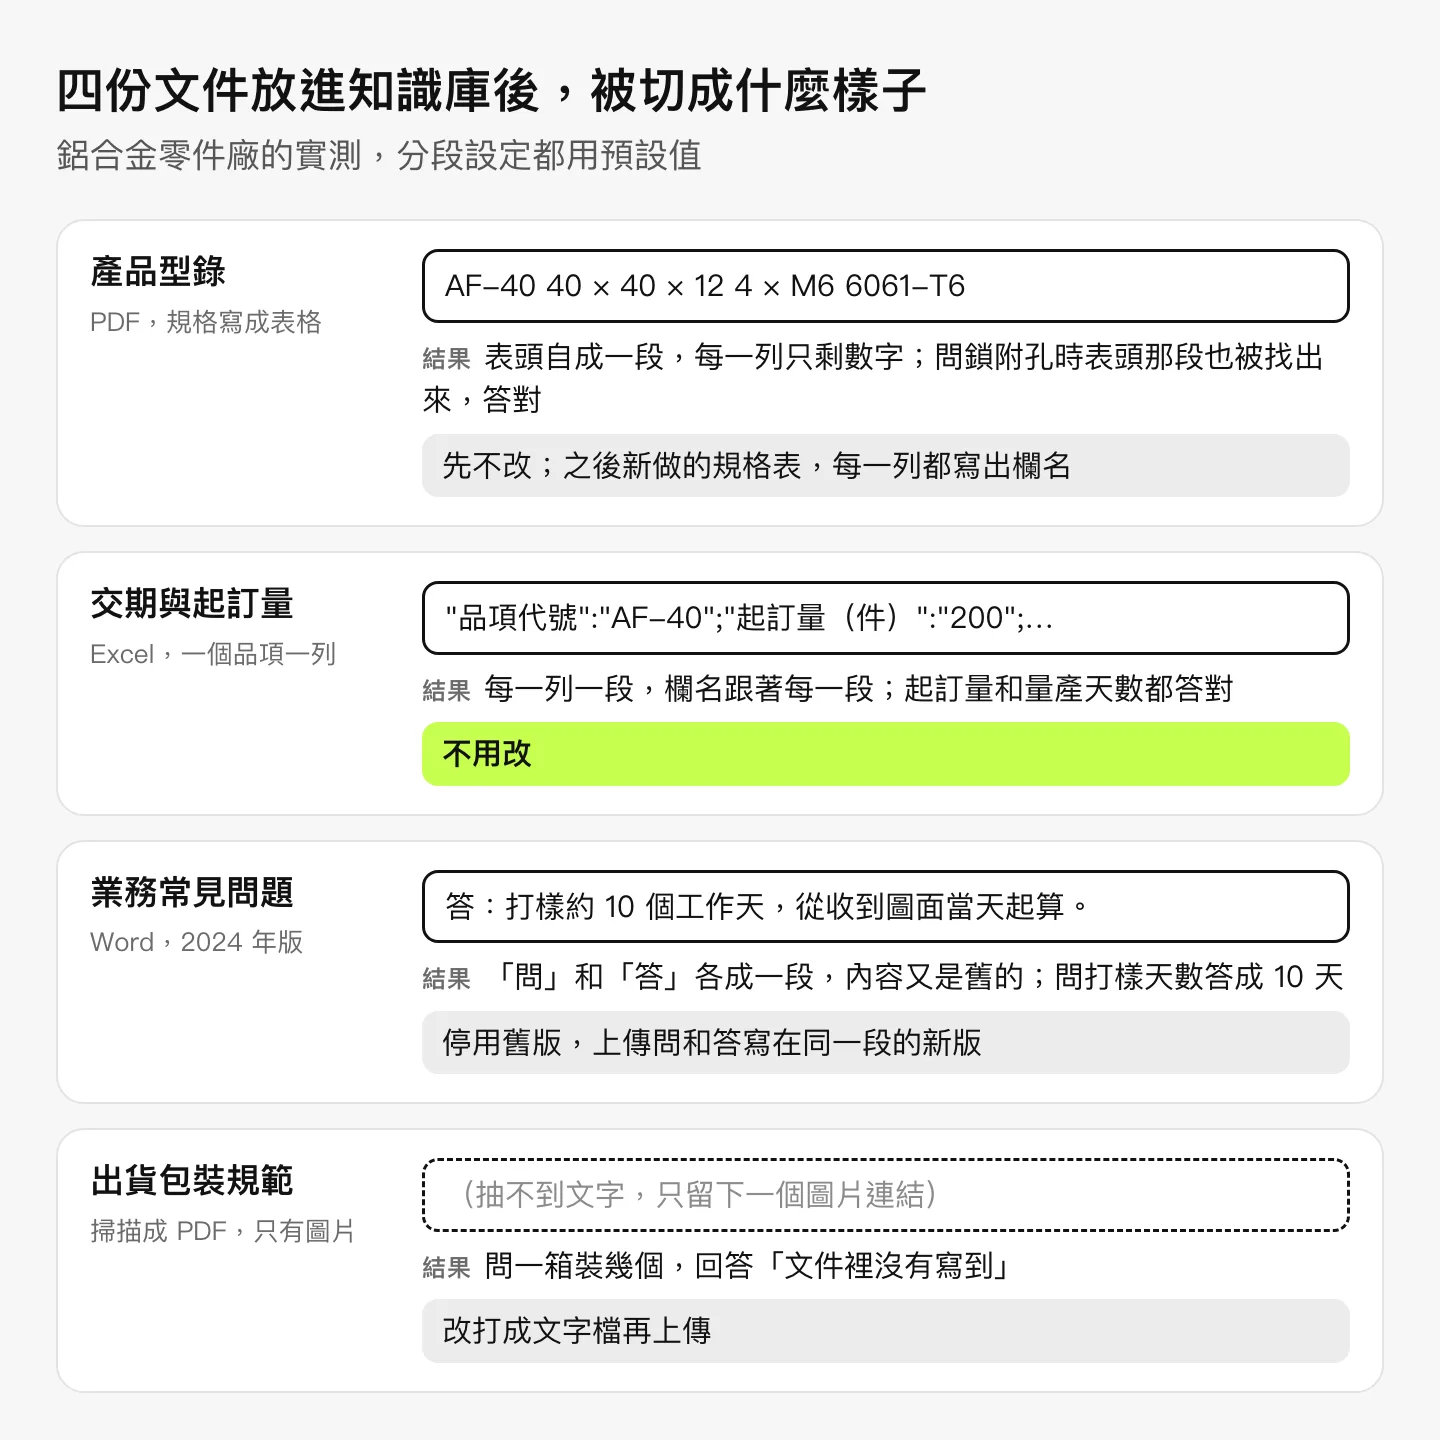
最麻煩的是最後兩份。常見問題的「問」和「答」寫在不同行,切完就分成兩段;掃描檔只有圖片,預設處理抽不到任何文字,整份只剩 66 個字元的圖片連結。文件要先整理成什麼樣子才好查,在企業 AI 知識庫那篇有完整的準備清單。
步驟四:用檢索測試看它找到哪幾段
知識庫建好後,先別急著做聊天助手。左側有一個「檢索測試」,輸入一個問題,它會列出 Dify 找到的段落和相似度分數。這就是整個問答的第一步:先找出最像的幾段,再把這幾段連同問題交給模型回答,也就是常聽到的 RAG。每次找幾段由 Top K 決定,知識庫預設是 3。
我們先輸入「打樣要幾天」:
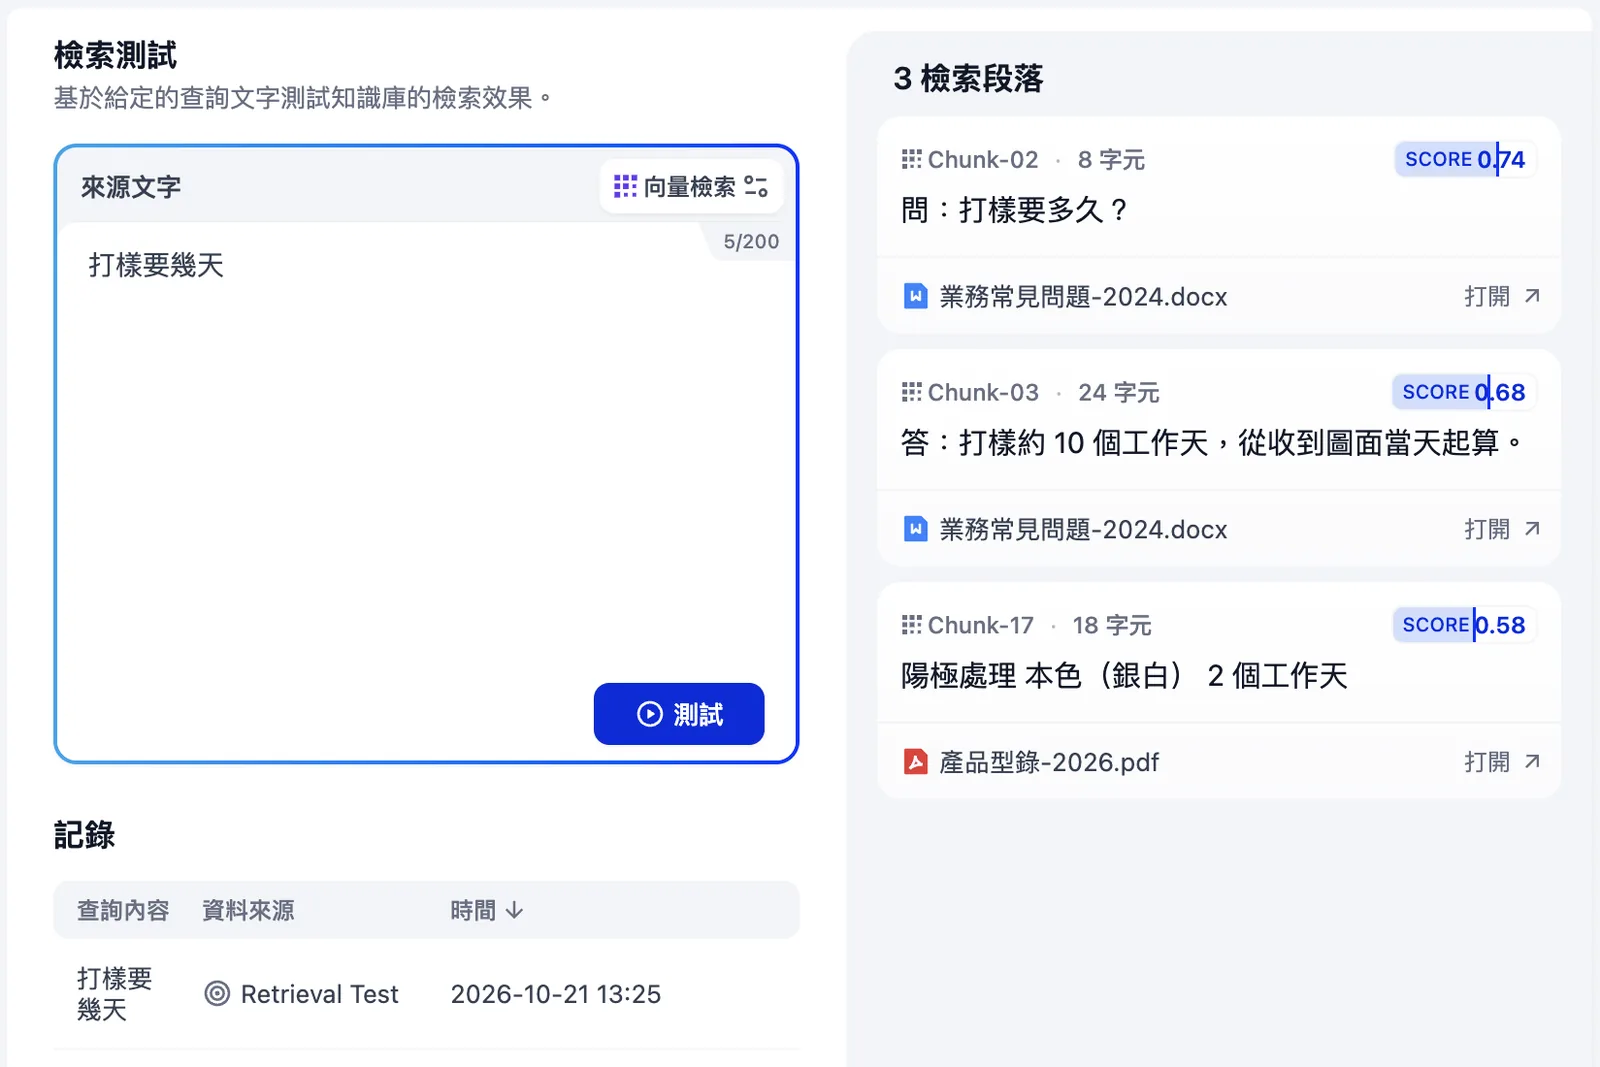
前兩名都是舊版常見問題,第三名是陽極處理的天數;交期表裡寫 7 天和 5 天的段落沒進前三名。再問「AF-40 一箱裝幾個」,找出來的是型錄和交期表的段落,包裝規範一段都沒有,因為它沒有文字可以比對。
檢索測試找不到對的段落,後面換模型、改提示詞都救不回來。所以先看檢索測試找到哪幾段,再看回答,問題出在哪一步會清楚很多。
步驟五:建一個聊天助手
到「工作室」選「建立空白應用」,類型選「聊天助手」;只是要查文件回答問題,選它最省事,不用像「工作流」那樣自己一步步拉出流程。
建好後會進到它的設定畫面,Dify 叫「編排」。在這裡做三件事:
- 寫提示詞:告訴模型它是誰、能根據什麼回答、找不到時怎麼說。
- 接上知識庫:「上下文」指每次提問時交給模型參考的段落,在這裡按「新增」,選剛才建的知識庫。
- 確認引用:「功能」裡的「引用和歸屬」要開著,回答下方才會列出用到哪幾段、出自哪份文件。
我們第一版的提示詞是這樣:
你是鋁合金零件廠的業務查詢小幫手,回答業務同事關於產品規格、交期、起訂量和包裝的問題。 只根據上下文裡的公司文件回答,不要自己推測。 文件裡找不到答案時,直接回答「文件裡沒有寫到這件事,請找負責的同事確認」。 數字照文件寫,並說出是哪一份文件。
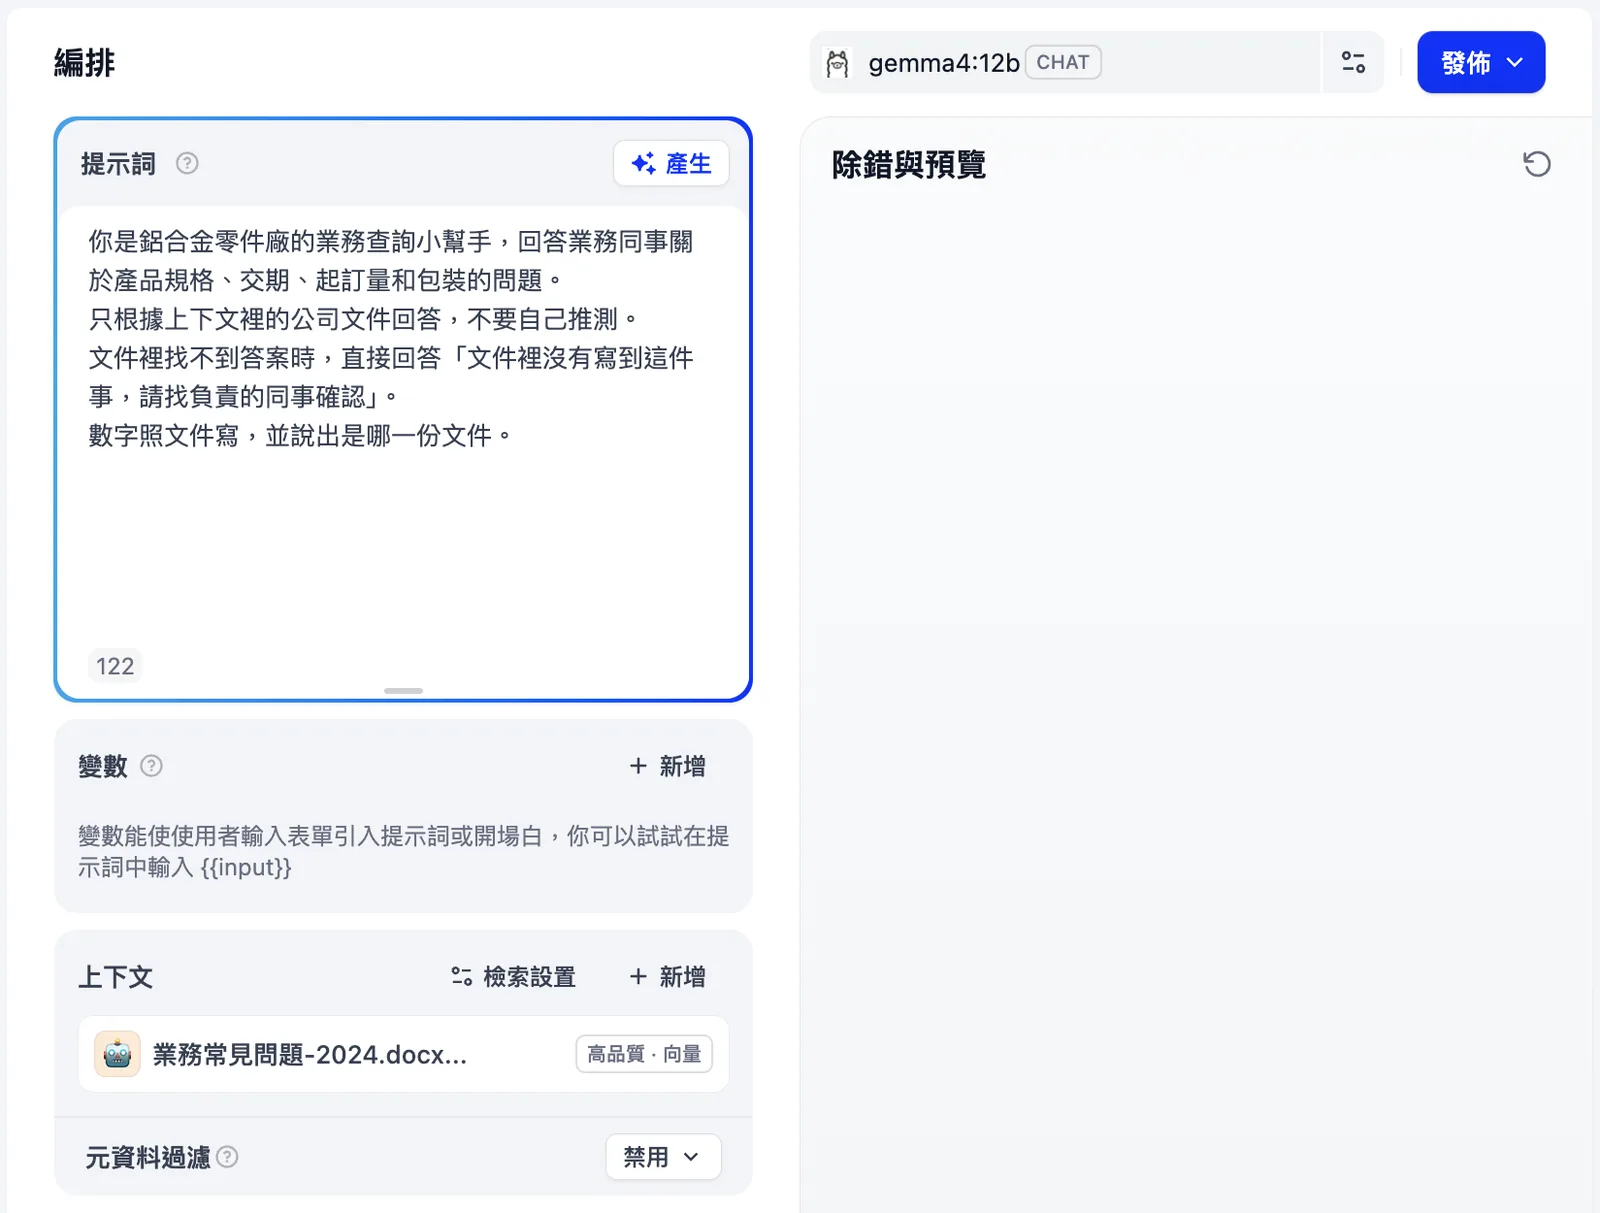
右側的「除錯與預覽」可以直接問。第一題花了 55 秒才答,因為 gemma4 預設會先「思考」一輪。點模型名稱右邊的設定圖示,找到 Think:先打開它左邊的開關(表示要自己設定這個參數),再把值選成 False,也就是不先思考,同一題就變成 11 秒。
步驟六:發佈,拿到網址和 API
在編排頁右上角按「發佈」,再到左側「存取點」,常用的有兩種:
- 網頁應用程式:一個聊天網址,業務打開就能問。誰打得開,留到上線前再決定。
- 後端服務 API:讓程式代替人送出問題、拿回答案。每個應用要各自建立 API 金鑰,官方提醒只能從公司自己的伺服器呼叫,金鑰放在網頁或 App 的程式碼裡會被拿走。
接下來的六題測試,我們用的就是 API。下面是送一個問題的寫法,app-xxxx 換成你自己的金鑰;如果改過連接埠,網址也要跟著加上 :8080:
curl -X POST http://localhost/v1/chat-messages \
  -H "Authorization: Bearer app-xxxx" \
  -H "Content-Type: application/json" \
  -d '{"inputs": {}, "query": "AF-40 一箱裝幾個?", "response_mode": "blocking", "user": "sales-01"}'
query 是問題,user 是自己取的提問者代號,blocking 表示等答完才一次傳回。傳回的 answer 是回答,metadata.retriever_resources 列出用到的每一段、檔名和分數,拿來自動比對答案和出處。
用六個問題測它
在畫面上一題一題問很難比較,所以我們先寫好六個問題和正確答案,用 API 每題問兩次,涵蓋跨文件加總、新舊文件矛盾、答案只在掃描檔、文件根本沒寫這幾種狀況。
| 問題 | 文件裡的正確答案 | 第一輪結果 |
|---|---|---|
| AF-40 最少要訂幾件?量產要多久? | 200 件、15 個工作天(交期表) | 兩次都對;但其中一次說「根據產品規格文件」,實際出自交期表 |
| AF-40 要做黑色陽極,量產總共要幾個工作天? | 15+3=18 個工作天(交期表+型錄) | 一次算出 18 天;另一次只列出 15 天和 3 天,沒有加起來 |
| 打樣要幾天? | AF 系列 7 天、LB 系列 5 天(交期表) | 兩次都答「約 10 個工作天」,來自舊版常見問題 |
| AF-40 一箱裝幾個? | 100 件(包裝規範) | 兩次都答「文件裡沒有寫到這件事」 |
| 你們有 ISO 9001 認證嗎? | 文件沒寫 | 兩次都答「文件裡沒有寫到這件事,請找負責的同事確認」 |
| AF-40 的鎖附孔是什麼規格? | 4 × M6(型錄) | 答對,表頭那段也被找出來了(這題是後來補的,只問了一次) |
這六題暴露了三件事:
- 數字對了,出處卻講錯:第一題有一次把交期表說成產品規格文件,正確的檔名卻記在引用裡。出處要看引用,不要叫模型自己說。
- 同一題兩次結果不同:跨文件加總那題,一次算對、一次沒算。只問一次,看到的可能剛好是比較好的那次。
- 「文件裡沒有寫」不一定是真的沒寫:包裝那題的答案就在掃描檔裡,只是 Dify 讀不到;業務看到的卻和 ISO 那題一模一樣。
先改文件,再重測一次
六題裡有三題的原因在文件,所以先從文件改:
- 停用舊版常見問題:在知識庫的文件清單裡,把 2024 年版的開關關掉,狀態變成「已禁用」,它就不會再被找出來,檔案還留著。舊版裡還有圖面審查這些仍要用的問答,所以另外上傳改寫過的 2026 年 10 月版:問和答寫在同一段,打樣天數和交期表一致。
- 掃描檔改成文字檔:把包裝規範重新打成一份 Markdown 文字檔(一種純文字格式,用記事本就能寫),每一行都寫出型號,例如「AF-40 鋁合金固定座 40:單件用氣泡袋包裝,每箱裝 100 件。」,再停用原本的掃描檔。
- 提示詞拿掉「說出是哪一份文件」:出處交給引用,最後一行改成:
數字照文件寫。問到交期時,如果文件同時寫了量產天數和表面處理天數,把兩個加起來,並寫出算式。
改完先回到檢索測試,輸入「打樣要幾天?」,新版常見問題排到第一:
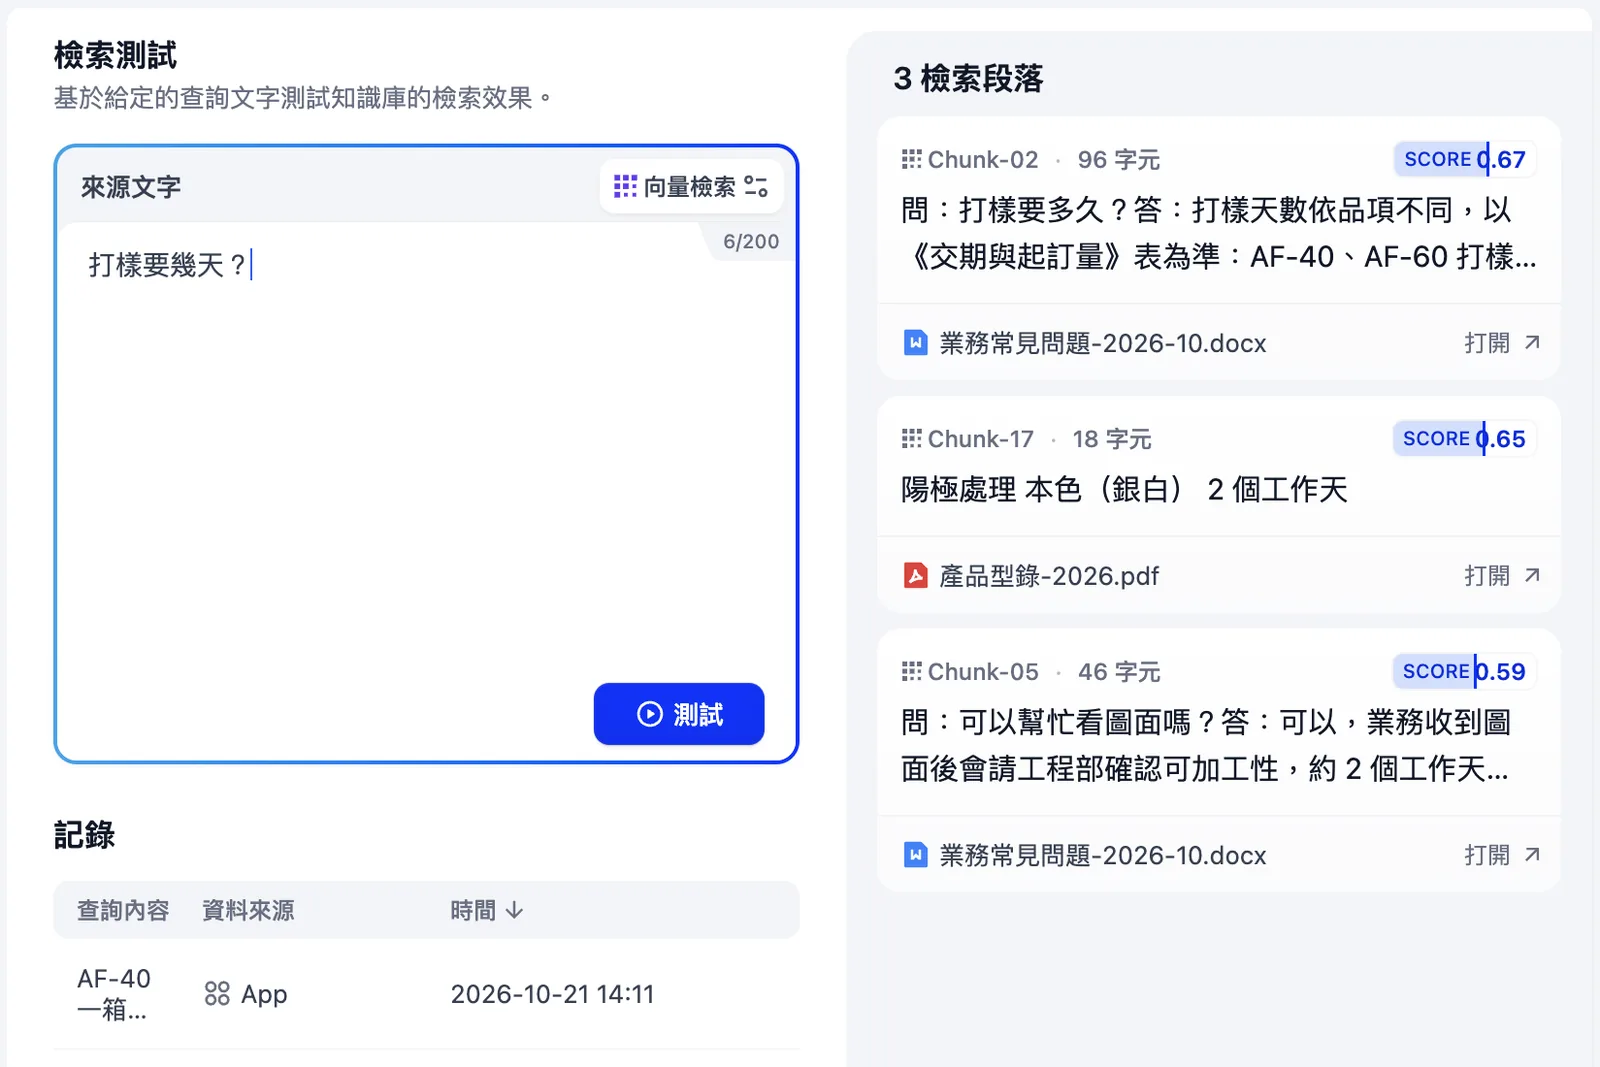
這裡有個意外:同樣改完之後,像第一次那樣輸入不帶問號的「打樣要幾天」,新版常見問題就擠不進前三名。六題測試用的是有問號的寫法,所以只能說有問號的問法修好了。業務打字有人加問號、有人不加,所以測試問題要用同事實際會打的寫法,同一題換兩三種說法都試。
第二輪六題的結果:打樣那題兩次都答出 AF 系列 7 天、LB 系列 5 天;包裝那題兩次都答出 100 件;起訂量、ISO、鎖附孔三題維持正確。只有黑色陽極那題反而變差,兩次都答:
AF-40 的量產總共需要 19 個工作天。計算方式為:15(量產交期)+ 4(噴砂+陽極處理 本色)= 19 個工作天。
看引用就知道為什麼。找到的三段依序是:新版常見問題的「打樣天數依品項不同,以《交期與起訂量》表為準:AF-40、AF-60 打樣 7 個工作天……」、交期表的 AF-40 那一列、型錄的「噴砂+陽極處理本色 4 個工作天」。第一段只因為也寫了 AF-40 和交期,就占掉一個名額,「黑色 3 個工作天」那段被擠出去,模型只好拿 4 天來算。好在提示詞要它寫出算式,業務一眼就看得出它用錯了天數;沒有算式的話,19 天看起來就和真的一樣。
兩個地方都有 Top K
要多找幾段,直覺是把 Top K 調高。Dify 裡有兩個地方可以調:知識庫自己的「檢索設定」,以及聊天助手「上下文」旁邊的「檢索設置」。
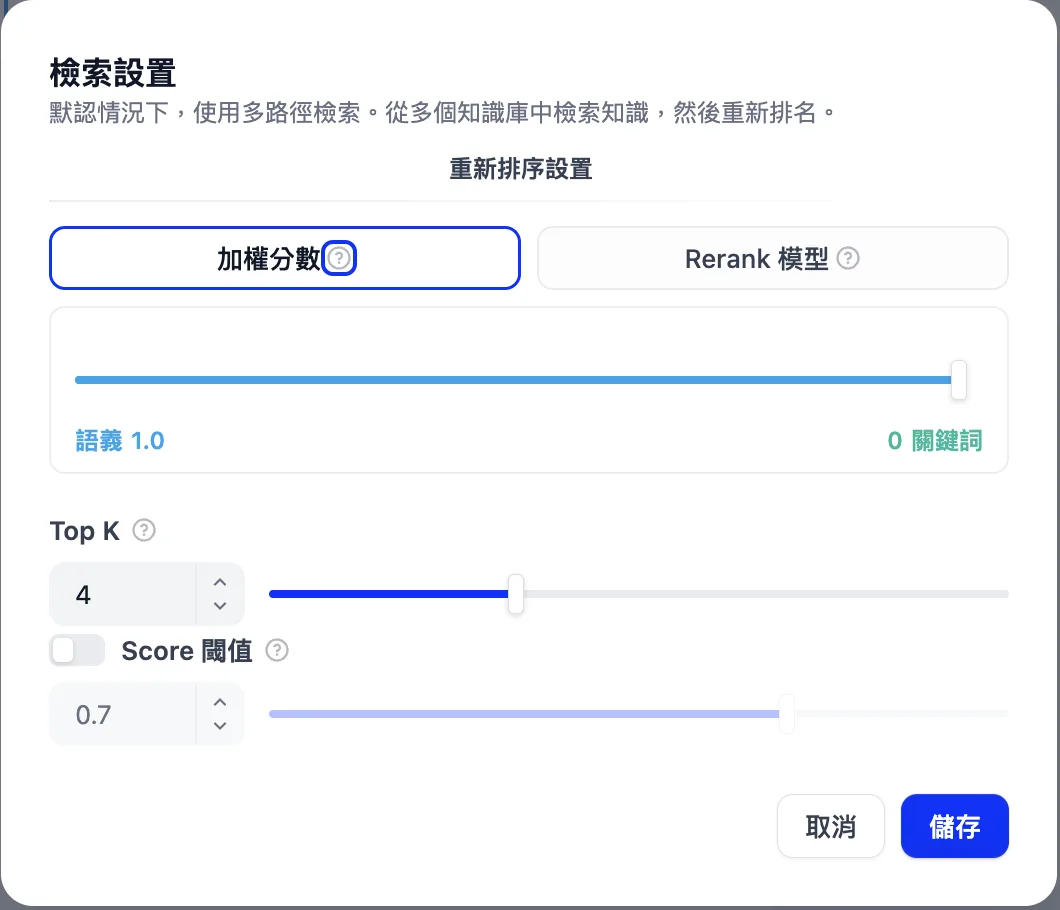
我們的聊天助手這邊顯示 4,知識庫那邊是預設的 3,其他選項都沒動,結果每次只用到 3 段。翻 Dify 1.17.1 的原始碼可以看到原因:用「高品質」索引時,每個知識庫先照自己的 Top K 找段落,之後才套用聊天助手的 Top K。官方文件寫 Top K 只在重新排序時作用,和原始碼不同,這裡照原始碼寫。
所以只接一個知識庫時,最多拿到兩邊比較小的那個數字,開了 Score 閾值還會更少:只調高聊天助手,還是 3 段;只把知識庫調到 5,會被聊天助手的 4 卡住。接好幾個知識庫時,是各自找完合起來,再照聊天助手的 Top K 取前幾名。
所以下一步是把兩邊都調到 5,再把六題全部重跑。段數變多,黑色陽極那段比較有機會被找回來,代價是可能變慢或混進不相關的段落,一樣看重跑結果再決定。
上線前要有一組固定問題和正確答案,每改一次文件或設定,就全部重跑一次。這次改文件修好兩題、卻弄壞另一題,只重測改過的兩題看不出來。
正式上線前要決定的事
試做到這裡,文件和題目要先準備好兩樣:
- 文件:舊版停用;掃描檔轉成文字,指定倉管課有改就同步;問和答寫在同一段;表格每一列都寫出型號和欄名。
- 題目:涵蓋跨文件加總、新舊矛盾、只在掃描檔、文件沒寫四種狀況,每題換兩三種問法、各問兩次,連引用的檔名一起核對。
另外還有四件事要決定:
- 雲端還是自架:自架要有人顧主機和升級,每一版的升級步驟可能不同,要先讀那一版的升級說明。雲端版連不到筆電上的 Ollama,要接自己 API 金鑰的雲端模型、重建知識庫,六題也要在雲端重跑;Sandbox 方案的知識庫總容量只有 50 MB。
- 網址誰打得開:網頁應用程式預設是公開的,拿到網址的人都能用。自架的話,讓這台機器只在公司內網或 VPN 連得到;用雲端版,網址只發給要用的人。
- 文件誰更新:交期表改了,知識庫不會自己跟著變,要指定一個人負責。
- 模型能不能商用:gemma4 是 Apache 2.0;embeddinggemma 要照 Gemma 使用條款;雲端模型看那家的服務條款。
回到那家工廠。老闆看過六題的結果和交期表的內容,同意放上雲端,正式版就用 Dify 雲端版。開給業務之前的門檻是:換好雲端模型、兩處 Top K 調到 5 之後,六題各問兩次,答案和引用的檔名都對,才把網址貼進業務群組;這一輪還沒跑。之後交期表每次更新,由業務助理重新上傳、停用舊版,再重跑六題。如果之後要讓它直接查 ERP 裡的交期,或由外部工程師接手架設和維護,企業 AI agent 導入服務寫了從需求診斷到持續維護的四個步驟,可以先看要準備什麼。
Dify 做得出查公司文件的助手,但答得準不準,大半取決於你放進去的文件。
常見問題
Dify 免費嗎?
自己架的社群版免費,但授權有兩個附加條件:沒有書面同意,不能拿它經營多租戶環境(Dify 把一個工作空間算一個租戶);用到 Dify 前端時,不能移除或修改介面上的 Dify 標誌和版權資訊。細節以 LICENSE 原文為準。雲端版有免費的 Sandbox,付費方案的價格見第一節。
Dify 可以讀掃描的 PDF 嗎?
用預設的上傳方式時,我們的掃描檔抽不到任何文字,問到裡面的內容就答「文件裡沒有寫到」。比較穩的做法是先轉成文字或重新打成文字檔再上傳,並按「預覽資料塊」確認看得到文字。
Dify 可以改接 OpenAI、Anthropic 或 Google 的模型嗎?
可以,裝外掛、填金鑰的步驟同步驟二。要注意的是 Embedding 模型:在知識庫的設定裡換掉之後,所有段落都會重新計算。
上傳到 Dify 的文件,會被拿去訓練模型嗎?
Dify 是每次提問時找出相關段落交給模型參考,模型本身不會因此被重新訓練。自架加上本機的 Ollama,文件和問題都留在這台電腦;接雲端模型時,送出去的資料見步驟二,那家會不會拿來訓練,看它的 API 資料使用條款。
參考來源
以下依 Dify 1.17.1 與官方文件整理;雲端方案的額度與價格、模型外掛版本和介面名稱以 Dify 官方頁面當下為準。
- Dify:Deploy with Docker Compose
- Dify 方案與價格
- Dify 授權:LICENSE
- Dify 1.17.1:docker/.env.example(EXPOSE_NGINX_PORT)
- Dify:Import Text Data(雲端版上傳限制)
- Dify:Chunking and Cleaning Text
- Dify:Setting Indexing Methods
- Dify:Manage Knowledge(知識庫設定與更換 Embedding 模型)
- Dify:Test Retrieval
- Dify:Integrate Knowledge Within Application
- Dify:Additional Features(引用和歸屬)
- Dify:Web App Settings
- Dify API 文件:Get Started
- Dify 1.17.1 原始碼:dataset_retrieval.py
- Docker 文件:Docker Desktop networking how-tos(host.docker.internal)
- Docker 文件:docker container run(—add-host 與 host-gateway)
- Ollama 模型庫:gemma4
- Ollama 模型庫:embeddinggemma
- Google:Gemma 4 license(Apache 2.0)
- Google:Gemma Terms of Use