你是一家冷氣品牌的客服組長,那天線上忙不過來,你自己接了一通客人打進來的電話。客人說:「我家冷氣一直滴水,滴到地板都濕了。」你在內部知識庫打「冷氣 滴水」,搜出來的是一篇講滴水保固範圍的說明。客人在電話那頭等了兩分鐘,你只好說稍後回電。
掛掉之後,資深同事告訴你,處理步驟其實寫在一篇叫「室內機排水異常處理方式」的文件裡。只是那篇文件裡一個「滴水」都沒有。
這個知識庫有三百多篇文件。你把這件事報上去,主管決定導入 AI 客服助理,用 RAG 的方式回答。RAG 的意思是先從公司文件裡找出相關段落,再交給 AI 寫成回答。廠商的提案裡寫著「需建置向量資料庫」。
主管把提案交給你一起看,所以你想知道向量資料庫是什麼、為什麼找得到那篇文件,還有是不是一定要另外買一套。
這篇就拿這個知識庫從頭走一次,而我的結論是:要不要另外買,主要看你的資料量和手上已經有哪些系統。三百多篇文件這種規模,我會先用平台內建的檔案檢索。公司已經在用 PostgreSQL(常見的開源資料庫),就在裡面加向量功能。資料量和查詢量大到前兩條路不夠用,才輪到專門的向量資料庫。
向量資料庫是什麼:依「意思」找資料的資料庫
向量資料庫是一種可以儲存、建立索引並查詢向量嵌入(vector embedding,以下用 embedding)的資料庫。embedding 是把一段文字、一張圖片或一段錄音轉成一長串數字的結果(Google Cloud:什麼是向量資料庫)。
一般資料庫和關鍵字搜尋擅長的是「完全符合」。像是訂單編號等於多少、日期落在哪個區間、標題包含哪幾個字。你搜「冷氣 滴水」,它就去找有這幾個字的文件,所以「室內機排水異常」那篇很可能找不到。
而向量資料庫擅長的是「意思相近」。就算問題和文件用了不同的字,只要講的是同一件事,它也有機會把那篇文件找出來。
可以把向量資料庫想成一間按「用途」擺貨的大賣場。
你要找烏醋,不知道它放在哪一排也沒關係。只要記得它是調味料,走到醬油和白醋那一區,通常就找得到。因為用途相近的東西會被擺在一起。
- embedding 是每段文字的貨架位置:模型替每段文字算出一個位置,意思相近的放得很近。「冷氣一直滴水」和「室內機排水異常」會落在同一區。
- 查詢就是走到同一區去找:客人的問題也算出一個位置。系統拿附近的幾段文字回來,用詞不同也找得到。
- 索引就是天花板上的分區看板:不用每一排貨架都走過一遍,先看看板走到大概的區域,就能很快找到最接近的幾樣東西。代價是偶爾會錯過被擺到別區的那一瓶。
比喻對不上的地方有兩個。賣場的位置用前後左右兩個數字就標得出來,embedding 卻要用上千個數字。而且位置是模型算出來的,不是店員排的,所以偶爾會把不相干的東西擺得很近。
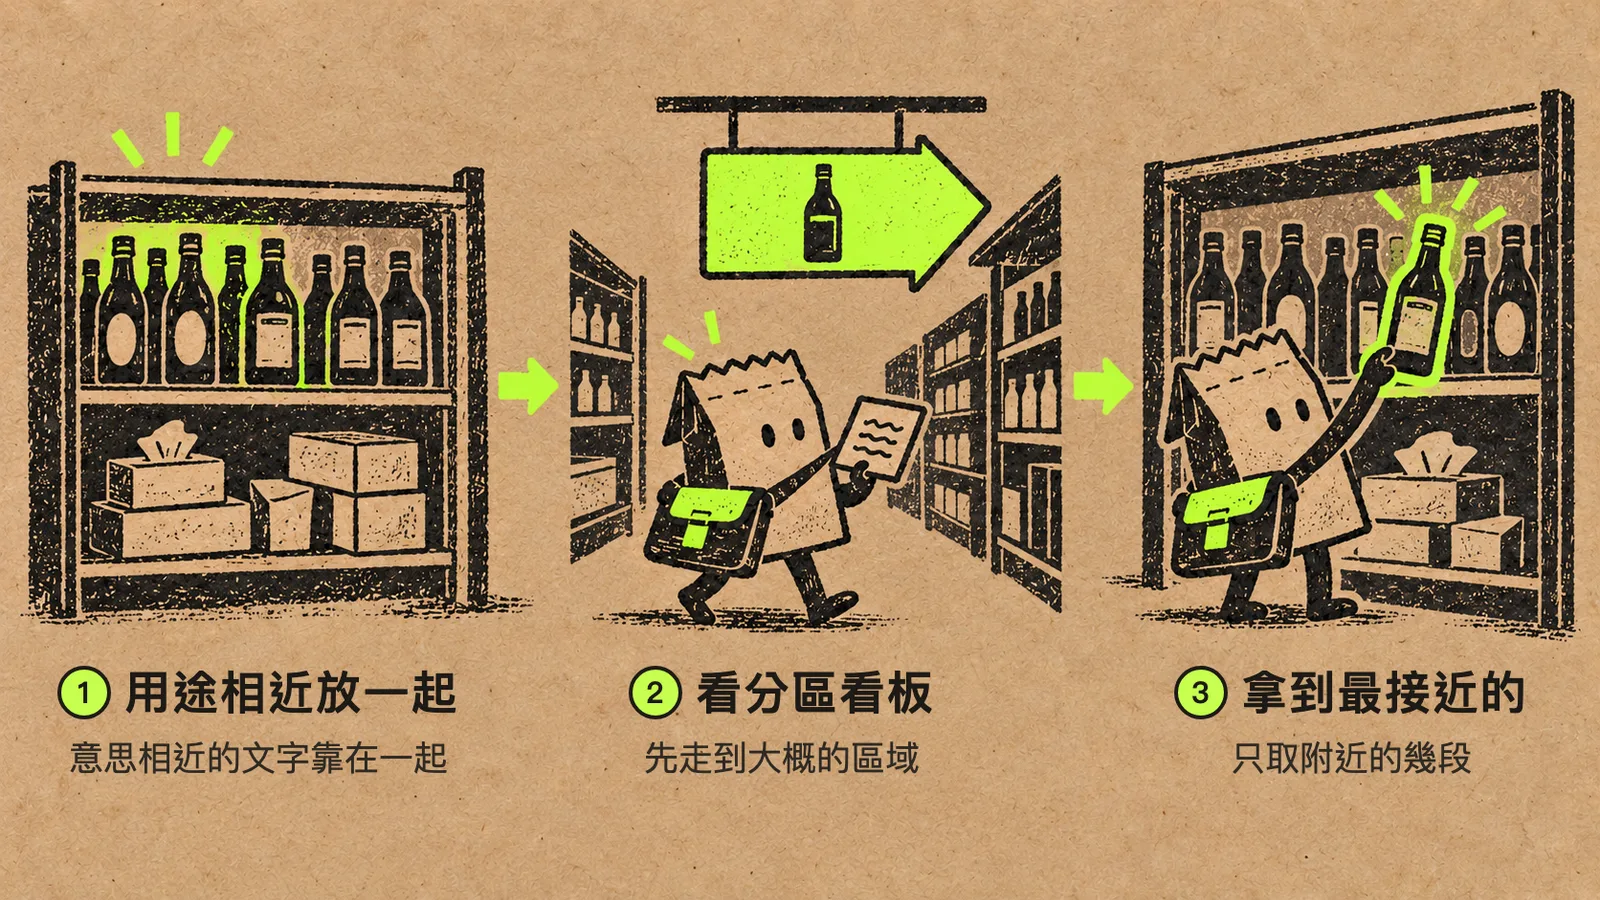 賣場把用途相近的東西擺在一起,向量資料庫把意思相近的文字放在一起;分區看板讓你不用走遍每一排。
OpenAI 的說明文件裡有一個例子,很適合拿來看兩種找法的差別。問題是「我們什麼時候登上月球?」,三段候選文字的比對結果如下(OpenAI:Retrieval):
| 候選文字 | 關鍵字相似度 | 語意相似度 |
|---|---|---|
| 人類第一次登陸月球是在 1969 年 7 月。 | 0% | 65% |
| 第一位登上月球的人是阿姆斯壯。 | 27% | 43% |
| 我吃了月餅,很好吃。 | 40% | 28% |
(原文是英文,分數用英文原文算,這裡把句子翻成中文。語意相似度是把句子轉成 embedding 後,算兩串數字有多接近。)
只看字詞重疊,最相關的反而是月餅那一句。改用 embedding 來比,真正回答問題的第一句就排到了最前面,雖然在英文原句裡,它和問題連一個共同的詞都沒有。這跟你搜「冷氣 滴水」卻跑出保固說明是同一個問題,所以向量搜尋補上的,就是「用詞不同、意思相同」的那一塊。
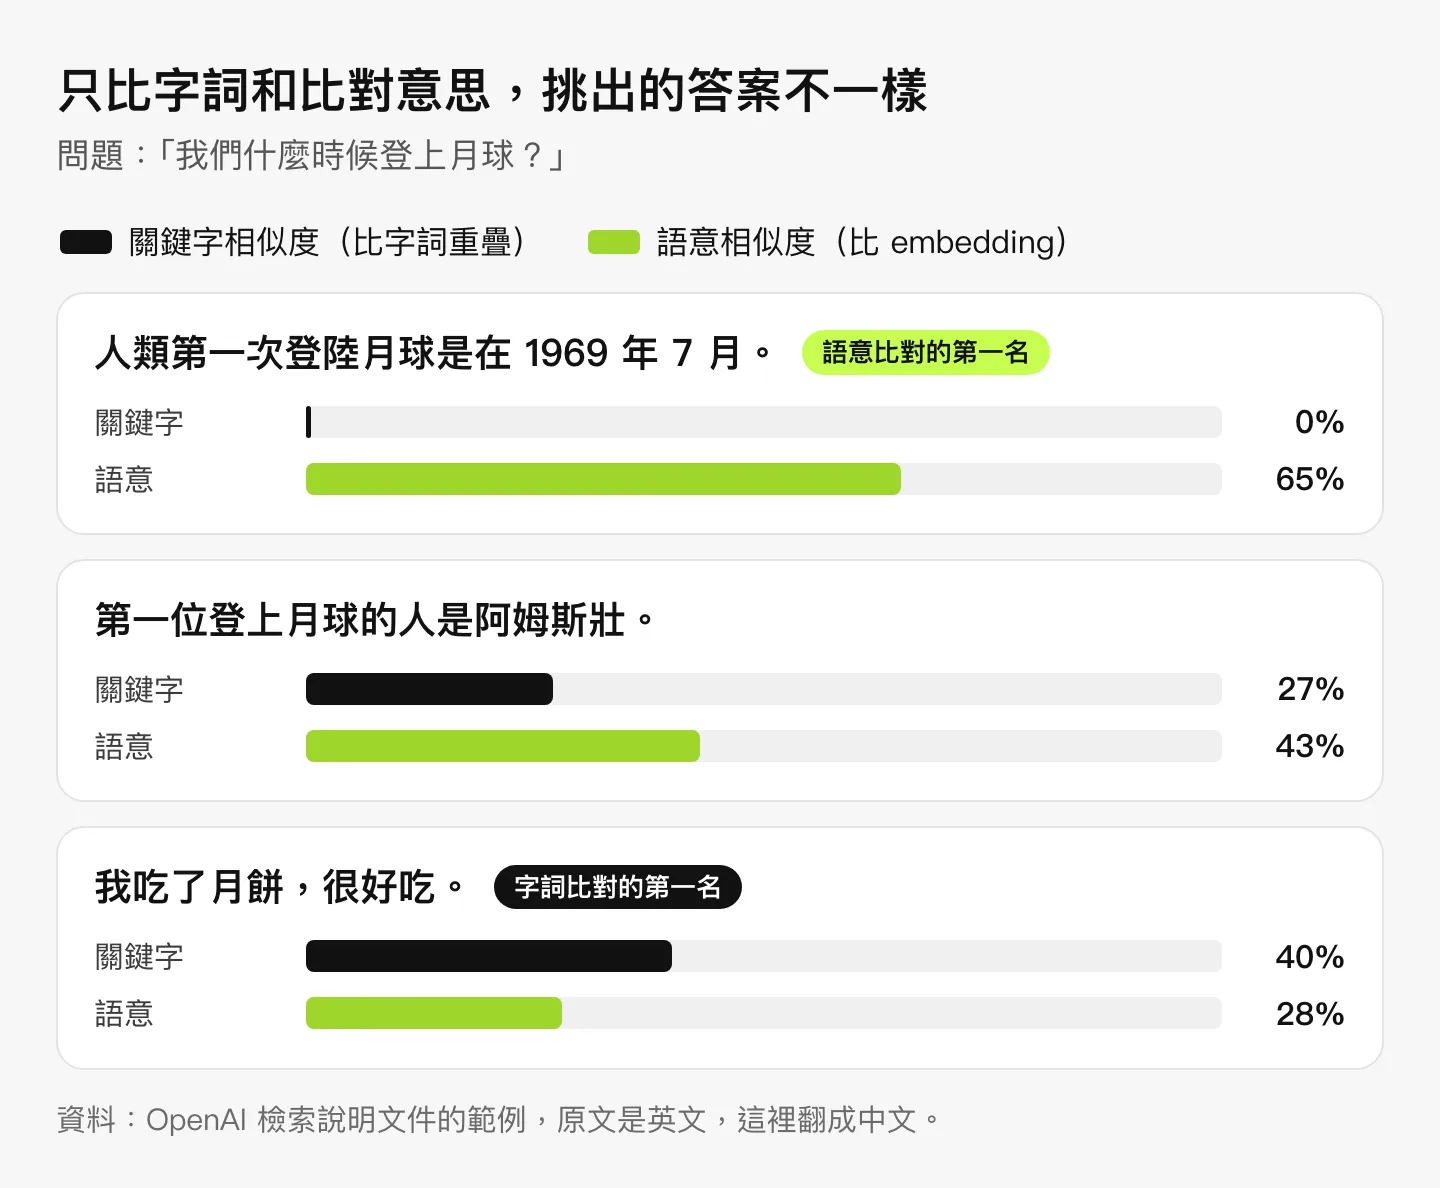 黑色長條是比字詞重疊的分數,綠色長條是比 embedding 的分數;兩種比法挑出的第一名,剛好是不同的兩句。
換成你的知識庫來看。我用站內一支只比對字詞的檢查程式,算了客人幾種說法和兩篇文件標題的相似分數。分數是 0 到 1,只看兩句話共用了多少相同的詞,越接近 1 越像:
| 客人說的 | 文件標題 | 分數(越接近 1 越像) |
|---|---|---|
| 冷氣一直滴水怎麼辦 | 冷氣滴水的保固範圍說明 | 約 0.23 |
| 冷氣一直滴水怎麼辦 | 室內機排水異常處理方式 | 0 |
| 冷氣漏水怎麼處理 | 室內機排水異常處理方式 | 約 0.09 |
| 冷氣冒水 | 室內機排水異常處理方式 | 0 |
分數最高的是保固說明,因為它和問題共用了「冷氣」「滴水」;真正有處理步驟的那篇,三種說法都只拿到 0 或接近 0。這跟開場你遇到的情況一模一樣,也就是說,只比對字詞的搜尋,認得兩句話有沒有用到相同的字,卻認不出意思一樣、用字不同的句子。
Embedding 是什麼:把一段文字變成一串數字
embedding 中文常翻成「嵌入」或「向量嵌入」,是 embedding 模型把一段文字轉成的一長串小數。
以 OpenAI 的模型為例,text-embedding-3-small 預設輸出 1,536 個數字。text-embedding-3-large 則是 3,072 個(OpenAI:Vector embeddings)。其他廠商和開放模型也有自己的 embedding 模型:
- Google:Gemini API 最新的
gemini-embedding-2能處理文字、圖片、影片、音訊和 PDF,只處理文字的gemini-embedding-001仍可使用。兩個模型預設都輸出 3,072 個數字(Google:Gemini API embeddings)。 - Cohere:Embed 的多語言模型(例如
embed-multilingual-v3.0)支援 100 多種語言,包含中文,也有只支援英文的版本(Cohere:Embed)。 - BAAI 的 BGE-M3:MIT 授權的開放模型,可以下載到自己的機器上跑,輸出 1,024 個數字(Hugging Face:BAAI/bge-m3)。
每一個數字單獨看都沒有意義,要整串放在一起,才代表這段文字落在比喻裡的哪個貨架位置。意思越接近的兩段文字,這串數字也越接近。
客服知識庫導入之後,流程是這樣。三百多篇文件先切成幾千段,也就是把每篇文件拆成一小段一小段,讓每段只講一件事,找回來的內容才不會夾帶不相干的部分。每段都轉成一串數字存進資料庫。客人說「冷氣一直滴水」時,系統把這句話也用同一個模型轉成一串數字,再找出和它距離最近的幾段。
「排水異常」「排水管阻塞」「冷凝水」這些段落,會因為意思接近而被一起找回來。距離有好幾種算法,最常見的是餘弦相似度,算出來的分數越高,代表兩段文字的意思越像。OpenAI 的說明文件建議用餘弦相似度,也寫到選哪一種通常影響不大。
把文字轉成 embedding 的費用通常不高。OpenAI 的說明頁以每頁約 800 個 token(模型計算文字量的單位)來估算。依這個估算,text-embedding-3-small 每 1 美元大約可以處理 62,500 頁文字。
三百多篇客服文件轉一次的費用不太會是決策重點。真正要算的是後面的儲存、維運,以及換模型時的重算。
比起只比對字詞,用 embedding 比較容易找到換句話說的段落,但也會多出幾件事要處理:
- 每次查詢都要呼叫 embedding 模型。費用很低,但流程裡多了一個依賴外部服務的步驟。除非把模型架在公司內部,否則網路斷了就查不了。
- 相似度門檻要重新試。「滴水」和「冒水」要多像才算同一件事,要多少分才把那段交給 AI,要拿客服真實的問法試一輪才知道。
- 會多出新的誤判。「冷氣不冷」和「冷氣太冷」的位置可能很近,處理方式卻完全不同。
- 換模型就要全部重算。不同模型產出的數字長度和排列方式都不一樣,所以那幾千段文字要全部重新轉一次,舊資料不能直接沿用。
所以向量搜尋解決的是「換句話說」的問題。這個問題要夠困擾你,才值得付後面的維運成本。客服每天被「滴水」「漏水」「冒水」各種說法考倒,就是夠困擾的情況。
向量資料庫怎麼運作、和一般資料庫差在哪
一般資料庫本來就能篩選條件,差別在於向量資料庫可以同時「比意思」和「篩條件」,資料量大時還能用索引加快比對。
用冷氣知識庫走一次就清楚。客人問「冷氣一直滴水」,系統先把這句話轉成數字,再在同一次查詢裡,從 RX 系列、現行版本、客服人員有權限看的段落中,找出意思最接近的十段。多撈幾段是為了不漏掉相關的內容,這十段會一起交給模型寫回答。資料量再大一些時,系統就不會逐一比對,而是靠索引先縮小範圍。
| 功能 | 在做什麼 | 在客服知識庫裡 |
|---|---|---|
| 比意思(近似搜尋,又稱近似最近鄰,ANN) | 不和每一段逐一比對,只找出「大概最接近」的幾段,用一點準確度換取速度 | 從幾千段文件裡,很快挑出和「一直滴水」最接近的十段 |
| 向量索引(常見的有 HNSW、IVFFlat) | 事先替資料建好查找的捷徑,例如把相近的資料分群(IVFFlat)或串成多層的連結圖(HNSW),查詢時只看其中一小部分,就像比喻裡的分區看板 | 排水、冷房、噪音相關的段落各自成群,問滴水時只在排水那群裡找;文件改版後要跟著更新 |
| 篩條件(中繼資料篩選,也叫 metadata 篩選) | 比對意思的同時,再用附在每段文字上的型號、日期、權限這類欄位篩選 | 只找 RX 系列、現行版本、客服人員能看的文件 |
第一項有一個取捨你要先知道。PostgreSQL(很多公司拿來存訂單、會員資料的開源資料庫)有一個向量擴充套件叫 pgvector,它預設用的是精確搜尋。精確搜尋會把每一段都比過一次,所以一定會回傳真正距離最近的段落。放到冷氣知識庫裡,就是客人問滴水時,系統把幾千段全部比一遍。
加上近似索引之後,系統只比其中一部分,速度會變快,但「室內機排水異常」那一段有機會剛好被漏掉。
同一個問題查出來的結果,也可能和加索引前不一樣(pgvector)。所以幾千段這種量,可以先用精確搜尋,等到真的覺得查詢變慢,再建近似索引。
第三項在企業裡最常被低估。只比對意思的話,系統會把舊型號的排水說明、已經作廢的維修流程、只給工程師看的內部規格一起找回來。
權限為什麼要在檢索這一步處理,我在 RAG 是什麼寫過。這裡只提醒一件事:選向量資料庫時,先確認它能不能在同一次查詢裡,同時比對意思和篩選條件。
一定要另外買一套嗎:三種做法
不一定要另外買,企業大致上有三條路可以走。
第一條是雲端平台把整套檢索包好的內建功能。後兩條對應 Microsoft 在 Azure Cosmos DB 說明裡講的兩種向量資料庫。一種是在原有的資料庫裡加上向量功能,讓向量和原始資料存在一起。另一種是獨立的「純向量資料庫」(Microsoft Learn:整合向量資料庫)。
| 做法 | 適合的情況 | 要注意的地方 |
|---|---|---|
| 平台內建的檔案檢索 | 文件量不大,想先把第一個流程做起來 | 切段與檢索方式能調整的空間有限;檔案要放到平台上 |
| 現有資料庫加向量功能 | 公司已經在用這些資料庫,向量要和訂單、客戶資料一起查 | 每串數字的長度(維度)和索引都有上限;資料量很大時要調整效能 |
| 專門的向量資料庫 | 文件量非常大、查詢量很高,或要做細部的檢索調整 | 多一套系統要同步資料、管理權限、付費與維運 |
第一條路最省事。OpenAI 的檔案搜尋會同時用語意和關鍵字去找,也能依檔案的中繼資料篩選結果(OpenAI:File search)。你把檔案放進去時,系統會自動切段、轉成向量並建好索引。屬性要自己訂,像是型號、版本,查詢時就能拿來篩選(OpenAI:Retrieval)。
存放檔案的空間在 1 GB 以內免費,超過的部分按容量逐日計費(OpenAI:API Pricing)。平台替你存向量、管索引,所以你不用自己架資料庫,三百多篇客服文件很快就能做起來。
第二條路很常被忽略。pgvector 主打的就是把向量和其他資料存在一起,所以你同時保有 PostgreSQL 原本的好處。
舉例來說,保固登記寫到一半當機,資料不會只存進一半。資料庫出問題時,也能還原到出事前的某個時間點。你還能把訂單、客戶、保固這幾份資料連起來查。
如果客人的購買型號本來就存在 PostgreSQL 裡,在原本的資料旁邊多存一份向量,就能在同一次查詢裡比對意思、篩選型號。你不必把資料複製到另一套系統。
第三條路適合規模真的很大的時候。這類產品有哪些,我整理在下一節的表格裡。但對多數中小企業的第一個知識庫問答來說,通常還用不到這一步。
我的建議順序是先用平台內建的檢索把流程做起來。已經有 PostgreSQL 這類資料庫,就直接加向量功能。真的遇到規模或效能瓶頸,再評估專門的向量資料庫。
文件量更少的時候,連檢索都可以先不建,直接把整份文件連同問題一起交給 AI 就好,這部分在 RAG 是什麼有說明。
常見的向量資料庫有哪些
常見的向量資料庫有 pgvector、Elasticsearch、Azure Cosmos DB、Milvus、Qdrant、Weaviate、Chroma、Pinecone 這幾個。加上平台內建的 OpenAI 檔案搜尋,可以照前面的三種做法分成三類。採購前以各產品的官方方案頁為準。
表裡的「代管」是指由廠商幫你架好、維運,你依方案付月費或用量費,有些也提供免費方案;「自架」則是自己找主機安裝與維護。
| 分類 | 例子 | 是否開源或有免費方案 | 適合的情況 |
|---|---|---|---|
| 平台內建 | OpenAI 的檔案搜尋 | 不開源;存放空間 1 GB 內免費,查詢另外計費 | 已經在用 OpenAI 的 API |
| 現有資料庫加向量功能 | pgvector(PostgreSQL 的擴充套件,AWS RDS 等雲端 PostgreSQL 服務也能用) | 開源,不用授權費 | 公司本來就用 PostgreSQL |
| 現有資料庫加向量功能 | Elasticsearch、OpenSearch | OpenSearch 是開源;Elasticsearch 原始碼公開,授權有 AGPLv3、SSPL 等幾種 | 已經用它做全文搜尋 |
| 現有資料庫加向量功能 | Azure Cosmos DB(NoSQL 版內建向量索引) | 代管服務,每個 Azure 訂閱可以開一個免費帳戶,超過免費額度才收費 | 資料本來就存在 Azure Cosmos DB |
| 現有資料庫加向量功能 | MongoDB Atlas | 代管服務,有免費叢集可以先試 | 資料本來就存在 MongoDB |
| 專門的向量資料庫(可自架) | Milvus、Qdrant、Weaviate、Chroma | 開源,自架不用授權費(Weaviate 的企業功能另外授權) | 有工程師能自己架設與維護 |
| 專門的向量資料庫(雲端代管) | Pinecone、Zilliz Cloud、Qdrant Cloud、Weaviate Cloud | 四家都有免費方案,額度不同 | 不想自己維運,願意依方案付費 |
FAISS 常和上面這些產品一起被提到,但它是 Meta 研究團隊開發的函式庫(library),用來做相似度搜尋與分群(GitHub:FAISS)。它不是一套現成的資料庫服務,工程師通常是拿它當元件,放進自己寫的系統裡。
向量搜尋找不到什麼?
型號、數量與日期、最新版本、權限這四類問題,向量搜尋容易出錯,要靠其他方式補:
- 精確的型號、序號:相近的型號在語意上可能很接近。例如 RX-36 和 RX-38 的排水管規格有機會被搞混,所以型號要靠關鍵字比對。
- 數量、日期、保固狀態:像「這台冷氣還在保固內嗎?」,答案在保固系統的欄位裡,直接查系統比從文件段落裡找更準確。
- 最新版本:新舊兩版維修流程的內容可能很像,檢索不一定分得出哪一版才是現行的。這要靠版本欄位來處理,可以看企業知識庫要整理到什麼程度,AI agent 才用得上。
- 不該看的內容:向量本身不帶權限,所以權限要在檢索時用條件篩選。
這四類問題的答案取決於「精確的值」,跟意思像不像沒有關係。所以遇到這類需求,我會先把資料放在能精確查詢的地方,再讓 AI 去查它(模型拿到內容之後怎麼處理,見 LLM 是什麼)。
選之前先問的五個問題
不管走哪一條路,在估價或挑選產品之前,我會先問這五個問題:
- 資料有多少、多久更新一次?幾十份文件和幾萬份文件是完全不同的規模。客服文件常常改版,就要確認新增、修改或刪除之後,索引多久會跟上。
- 向量要不要和既有資料一起查?如果要依型號、日期、權限篩選,就優先考慮能和原始資料放在一起的做法。
- 會不會查型號、編號這類精確的字串?客人報出 RX-36 時,就要用同時跑關鍵字和向量查詢的「混合搜尋」,免得找回 RX-38 的說明。Microsoft 的 Azure AI Search 說明寫到,產品編號、專業術語、日期和人名這類查詢,關鍵字搜尋因為能精確比對,表現會比較好。混合搜尋會兩邊同時查,再把結果合併成一份排序(Microsoft Learn:Hybrid search overview)。pgvector 也建議搭配 PostgreSQL 內建的全文檢索(把文字事先建成關鍵字索引,查字詞時不必逐篇掃描)來做混合搜尋。
- 用哪個 embedding 模型、要幾個維度?維度就是「那一串數字有多長」,而資料庫對長度通常有上限。例如 pgvector 一般欄位建索引的上限是 2,000 維,但
text-embedding-3-large預設是 3,072 維,兩者直接搭配就建不了索引。解法有兩個:OpenAI 允許你在產生 embedding 時把長度縮短,說明文件舉的例子是「資料庫只支援 1,024 維,就指定成 1,024」,代價是準確度會降一點。另一個是改用 pgvector 較省空間的halfvec欄位,上限是 4,000 維。 - 換模型時誰負責重算?模型升級或換供應商時,整個知識庫的向量都要重算一次,索引也要重建。這件事要寫進維護範圍,免得第一次換模型時沒人負責。
回到那份提案。如果廠商的回答是這樣:文件三百多篇,每週改幾篇,改完重新上傳,平台會自動重建索引。要依型號篩選,也會查型號。公司的客服系統是外購的,沒有自己的 PostgreSQL。用 OpenAI 的模型,換模型時由廠商重算。
這樣的條件,我會先用平台內建的檔案搜尋,型號查詢另外交給關鍵字比對。接下來你要做的,是先拿一批客人的真實說法來試。
- 收 30 句左右客人真實的說法(數量是我建議的起點),像是「滴水」「漏水」「冒水」各種問法,每句都標好正確答案是哪一篇文件。
- 先替每份檔案標上型號。OpenAI 的屬性篩選要先有型號這個欄位,這份標註是導入前要做完的事。
- 丟進平台內建的檢索,看每句標好的那篇文件有沒有排進前 5 段,例如「冷氣一直滴水」要找到「室內機排水異常處理方式」。前面的例子雖然一次撈十段給模型,但我建議驗收時只看前 5 段,這樣標準比較嚴。算出 30 句裡有幾句命中,這個命中率就是你判斷要不要換做法的數字。
門檻要自己訂。我的建議值是 30 句裡至少 24 句命中,也就是八成,這不是官方標準,客服能接受的程度才是依據。命中率不夠,再回頭評估 pgvector 或專門的向量資料庫。
常見問題
向量資料庫和 RAG 是同一件事嗎?
兩者是整體和元件的關係。RAG 是一整套做法:先找資料,再把資料交給模型回答。而向量資料庫是其中「找資料」那一步常用的元件。
RAG 也可以只用關鍵字搜尋,或在文件很少時把整份文件直接交給模型。反過來,向量資料庫也會用在推薦商品、找相似圖片這類和 AI 問答無關的地方。如果 AI 不只要回答,還要自己進系統把事情做完,那就是 AI agent,向量資料庫頂多是它查資料的工具之一。
換了 embedding 模型,已經存好的向量還能用嗎?
要全部重新處理。不同模型產出的向量長度和排列方式都不同。
換模型時,要用新模型把全部文件重新轉一次、重建索引,查詢端也要改用同一個模型。我會先用一組固定的測試題比較新舊模型,再決定要不要換。測試題怎麼設計,可以參考 AI agent 專案怎麼驗收。
文件轉成向量之後,就等於匿名化了嗎?
向量還是可能被還原成原文。2023 年一篇發表在自然語言處理研討會 EMNLP 的研究(Morris 等人),用程式從 embedding 反推原文。在每段 32 個 token(模型計算文字量的單位)的測試文字裡,有 92% 被一字不差地還原。研究也從臨床紀錄的向量裡還原出病患的全名。
所以存向量的資料庫,要用和原始文件同一個等級的權限與加密來保護。
向量資料庫大概要花多少錢?
要分三塊來算:
- 轉向量的費用:把文件轉成 embedding,通常很低。
- 儲存與查詢:開源軟體本身不用付授權費,但自架要另外算主機和維運人力。平台內建的檢索多半按容量或用量計費,各家免費方案見前面的產品表。
- 重算與維護:換模型、文件改版之後的重算,這是最常被漏掉的一塊。
估價時請廠商把這三塊分開列,你會比較容易看出兩家的差異在哪裡。
參考來源
以下依官方文件整理,免費方案、額度、授權與 embedding 模型的維度以各官方頁面當下為準。
- Google Cloud:什麼是向量資料庫?運作方式為何?
- OpenAI:Vector embeddings
- OpenAI:Retrieval(語意搜尋範例、檔案屬性篩選)
- OpenAI:File search
- OpenAI:API Pricing
- pgvector(GitHub)
- Amazon RDS for PostgreSQL:支援的擴充套件版本
- Microsoft Learn:整合向量資料庫(Azure Cosmos DB)
- Microsoft Learn:Hybrid search overview(Azure AI Search)
- Google:Gemini API embeddings
- Cohere:Embed
- Hugging Face:BAAI/bge-m3
- FAISS(GitHub)
- Milvus(GitHub)
- Qdrant(GitHub)
- Weaviate(GitHub)
- Weaviate Cloud 方案
- Chroma(GitHub)
- Pinecone:Pricing
- Zilliz Cloud:Pricing
- Qdrant Cloud:Pricing
- Microsoft Learn:Azure Cosmos DB 終身免費方案
- MongoDB Atlas Vector Search 概覽
- MongoDB Atlas 免費叢集限制
- Elastic:授權說明
- OpenSearch(GitHub)
- Morris et al.:Text Embeddings Reveal (Almost) As Much As Text(arXiv)