最常見的錯是這樣:團隊想阻止模型訓練,卻仍希望即時搜尋的 crawler 能讀公開頁面,結果把所有 user-agent 寫進同一條 Disallow,目的不同的流量一起被擋。robots.txt 像門口的訪客名單,先確認來的人是誰、要做什麼,再決定讓他進哪一扇門。
各家 AI 爬蟲的整體政策整理在 robots.txt 管理 AI 爬蟲;這篇只談 OpenAI 的三種來訪者怎麼分開設定。
這篇給你可以照著設的東西:三種存取情境的分工表、robots.txt 寫法、HTTP 與伺服器紀錄的檢查順序,以及允許之後仍然推不出來的結論。各 crawler 權限與可取得內容的逐層檢查另見 AI crawler 可存取性檢查表。
這三個名字很像,用途卻像一家公司的三種人來訪:一個是來採訪、之後可能寫進報導(OAI-SearchBot);一個是來蒐集資料、之後可能放進內部資料庫(GPTBot);還有一個是你的客戶自己按下按鈕、請助理來拿一份文件(ChatGPT-User)。你可以只放行第一種,也可以三種都擋,但第三種其實是有人替使用者跑一趟,門禁規則對它未必適用。
允許 crawler 只是取得內容的條件。它和「頁面會被引用」之間,還隔著問題、可取得內容與產品流程。
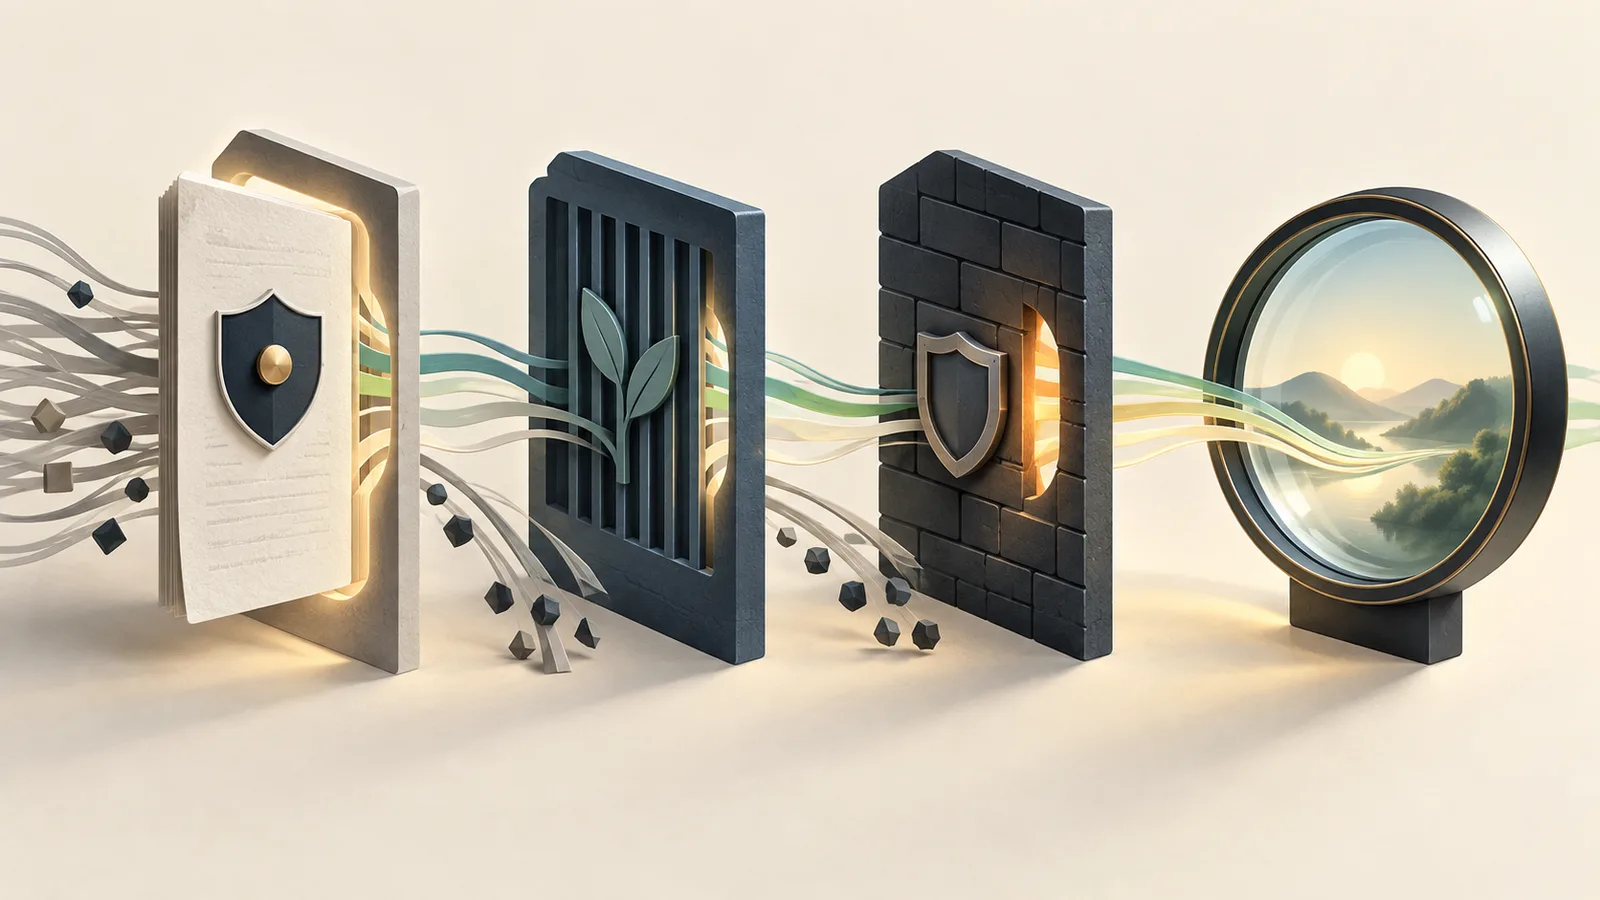 OpenAI crawler 設定的檢查順序:先寫 robots 規則,再看 HTTP 回應,最後回到實際回答觀測。
OAI-SearchBot 與 GPTBot:先分清楚三種 OpenAI 存取情境
OpenAI 現行的 Overview of OpenAI Crawlers 把自動爬取和使用者觸發的存取拆開。名字很像,政策目的完全不同。這一層沒分清楚,後面改的那行 robots.txt 很可能擋錯對象。
| user-agent | 官方用途 | 你正在控制的事情 | 它推不出來的事 |
|---|---|---|---|
OAI-SearchBot | ChatGPT 搜尋功能使用的搜尋 crawler | 網站是否可被 ChatGPT Search 的搜尋流程抓取 | 允許後每一題都會引用網站 |
GPTBot | 抓取可能用於訓練 OpenAI foundation models 的內容 | 內容是否允許進入 OpenAI 訓練資料使用範圍 | 拒絕後 ChatGPT Search 一定不會看見網站 |
ChatGPT-User | 使用者或 Custom GPT 觸發的頁面存取 | 某次使用者要求開啟網址的存取情境 | robots.txt 一定能擋下這次請求 |
OpenAI 官方說明,OAI-SearchBot 和 GPTBot 的設定彼此獨立。ChatGPT-User 是由使用者行動觸發,也不會拿來決定內容能不能出現在 Search;它的 robots.txt 行為可能與自動爬蟲不同。三個名稱合併成一個「OpenAI bot」欄位,就什麼都管不了。
先決定你要控制的目的
同一個網站可能同時有公開文章、付費文件、尚未整理的測試頁和不想納入訓練的內部資料。robots.txt 應該先反映內容政策,再把政策翻成路徑規則。看到一個 user-agent 就貼 Disallow: /,等於把「不想訓練」和「不想出現在搜尋」兩種決定綁在一起。
| 目標 | 優先看的 user-agent | 可以先做的設定 | 驗收重點 |
|---|---|---|---|
| 希望網站有機會出現在 ChatGPT Search | OAI-SearchBot | 保留目標公開路徑的存取權 | 讀 robots、抓頁面、檢查 WAF 與回答來源 |
| 不希望公開文章拿來訓練 foundation model | GPTBot | 對指定路徑寫 Disallow,或按站點政策拒絕 | 讀 robots 與日誌,保留政策版本 |
| 控制使用者要求 ChatGPT 開啟的頁面 | ChatGPT-User | 先看 OpenAI 當下文件與伺服器安全政策 | 自動 crawler 的測試結果套不上來 |
| 讓私人內容真正不公開 | 跟 crawler 名稱無關 | 使用登入、權限或其他伺服器存取控制 | robots.txt 擋不住想看的人 |
Google 的 robots.txt 介紹 也提醒,robots.txt 是爬取管理方法,不是把網頁從搜尋結果隱藏的安全機制。這裡雖然談的是 OpenAI,原則相同。需要真正保護的文件,在 HTTP 存取層處理,一條文字規則保護不了它。
robots.txt 怎麼寫才不會把政策混在一起
先用路徑建立最小範圍
假設公開知識文章可以給 ChatGPT Search 讀取,但 /private-research/ 不希望拿來做 GPTBot 的訓練資料,可以這樣寫:
User-agent: OAI-SearchBot
Allow: /
Disallow: /admin/
Disallow: /preview/

User-agent: GPTBot
Disallow: /private-research/
Disallow: /admin/
Disallow: /preview/

User-agent: *
Disallow: /admin/
Disallow: /preview/
Sitemap: https://www.example.com/sitemap.xml
這份範例的重點有三個。第一,OAI-SearchBot 和 GPTBot 各自有一個群組。第二,/admin/ 和 /preview/ 在兩個特定群組中重複列出,因為 * 群組的限制補不上來。第三,GPTBot 另限制 /private-research/,而 OAI-SearchBot 仍可讀取其他公開路徑。robots.txt 的 user-agent、allow 和 disallow 格式可回看 RFC 9309 Robots Exclusion Protocol 與 Google 對該規格的解讀。
RFC 9309 §2.2.1 的判讀方式是先找符合 crawler product token 的群組,再遵守該群組的規則;只有找不到特定匹配時,才使用 User-agent: *。因此在這個假設例子裡,OAI-SearchBot 請求 /preview/ 會套用自己群組內的 Disallow: /preview/,GPTBot 請求 /private-research/ 會套用 GPTBot 群組的限制;它們不會再從 wildcard 群組繼承規則。沒有特定群組的 ExampleBot 才會套用 * 的 /admin/ 與 /preview/。規則的路徑仍要按最長匹配原則核對。
檔案內容只是第一步
robots.txt 必須放在網站 origin 的 /robots.txt,並且先確認回應能被讀取。CDN 回傳 403、應用程式在登入後才提供不同內容、WAF 依 IP 另外拒絕,這三種情況單看檔案文字都會得到錯誤的安全感。
先用這兩行拿到狀態碼和內容:
curl -i https://www.example.com/robots.txt
curl -I https://www.example.com/geo/example-page
接著從伺服器或 CDN 紀錄核對實際請求。OpenAI 文件提供 OAI-SearchBot、GPTBot 和 ChatGPT-User 的 published IP ranges;可以先依官方公開清單核對來源 IP,再把 user-agent 當成輔助欄位,免得有人改寫字串就被當成官方 crawler。做不做得到,看你的伺服器、CDN 與安全工具支援到哪一層。
更新後怎麼確認
我會拆成「政策有沒有寫對」、「頁面能不能取得」和「產品有沒有真的使用來源」三層。三層各自留下紀錄,才不會把一個 200 回應寫成已經被引用。
1. 核對政策版本
先保存修改前後的 robots.txt、修改時間、變更人和適用範圍。表格至少有 user-agent、path、allow/disallow、政策目的和內容負責人。同一個路徑在多個群組有規則的話,依 OpenAI 文件和站點實際解析方式逐項檢查,肉眼看第一段會漏。
2. 核對 OpenAI crawler 能否取得頁面
選一個公開 URL 和一個應被限制的 URL,各自測試 robots 讀取、HTTP 回應、HTML 內容與 WAF 記錄。公開頁面至少要確認主要正文出現在回應或目標系統可處理的輸出中。被限制頁面則要確認限制只涵蓋原本的政策範圍,沒有意外把整個 / 擋掉。
3. 分開觀測 Search 與訓練政策
目標是 ChatGPT Search 的話,優先核對 OAI-SearchBot。OpenAI 官方寫明,robots.txt 更新後,Search 系統調整可能需要約 24 小時;那是系統調整的時間,跟內容會不會被收錄或引用是兩回事。等完之後,再用固定題目記錄回答是否出現網站、來源 URL 和回答時間。
| 檢查層 | 看到的證據 | 可以寫成什麼 | 還要保留什麼 |
|---|---|---|---|
| robots | /robots.txt 目前內容 | 這個 user-agent 對某路徑有哪條規則 | 讀取時間與回應碼 |
| crawl | 日誌、HTTP、WAF | 請求是否抵達及取得哪個狀態碼 | IP 驗證與頁面 URL |
| answer | ChatGPT Search 回答與來源卡 | 這次回答是否呈現某個來源 | prompt、時間、介面和完整來源文字 |
| policy | 團隊決策文件 | 為何允許或拒絕 | 內容負責人、路徑範圍和下次重查日期 |
從存取紀錄回到內容判讀
允許 OAI-SearchBot 後,最容易出現一個判讀跳躍:網站日誌有抓取,就說頁面會被引用。兩者中間還隔著索引、檢索、題目相關性、回答組裝與介面呈現。OpenAI 的官方說法只講 crawler 用途和設定分工,每個 prompt 選了哪些來源,要自己觀測。
例如你看到 /geo/ 被 OAI-SearchBot 讀取,下一步可以記錄三類問題:品牌題是否正確描述公司、類別題是否把品牌列入答案、決策題是否出現適用條件。這組固定問題的觀測方法在 ChatGPT 品牌監測流程,跟 robots 設定是兩件事,但可以接在同一張證據表裡。要追特定引用 URL,看 Citation Tracking 的欄位設計。
要把 OpenAI 的存取政策和多引擎回答放進同一個觀測流程,我們的 Otlex 就是為此開發的 AI 搜尋優化平台,觀測品牌在 ChatGPT、Google AI Overview、Google AI Mode、Gemini、Grok、Perplexity、Claude 回答中的提及、引用與推薦。
這篇管不到的範圍
這篇的主角是 OpenAI 的 user-agent,其他 AI crawler 各有各的規則。Google Search 使用自己的抓取與 AI features 規則,Anthropic、Perplexity 和 Apple 也有各自的 crawler 名稱與政策。跨平台管理可先看 robots.txt 對 AI 搜尋的控制邊界。
另外,GPTBot 的允許與拒絕只講訓練資料的使用政策,它管不到 Google AI Overviews,也管不到 ChatGPT-User 的使用者觸發請求。頁面能不能在回答裡成為來源,要把內容可讀性、索引狀態、來源品質與實際回答一起觀測。
常見問題
允許 OAI-SearchBot 就一定會被 ChatGPT 引用嗎?
允許它,代表網站沒有在 robots.txt 這一層拒絕 ChatGPT Search 的自動抓取。不一定。回答的來源仍依問題、可取得內容與產品流程決定。同意記者進場採訪,和報導會不會引用你的話,是兩件事。crawler 存取證據和回答中的來源 URL 分開保存。
拒絕 GPTBot 會讓網站離開 ChatGPT Search 嗎?
OpenAI 官方把 GPTBot 和 OAI-SearchBot 分開控制。目標只是避免訓練資料使用的話,看 GPTBot 的政策範圍就好;連 OAI-SearchBot 一起拒絕,才會影響 ChatGPT Search 的搜尋可見性。很多網站是在這一步一次擋掉兩件事,然後才發現其中一件本來想留著。
ChatGPT-User 可以用 robots.txt 完全阻止嗎?
OpenAI 說明 ChatGPT-User 是使用者觸發的請求,不是自動網路爬蟲,robots.txt 規則可能不適用。要保護的資料用登入、授權或伺服器層的存取控制,robots.txt 對它的效力別先假設。
改完 robots.txt 要多久才看得到變化?
OpenAI 現行 crawler 文件寫明,Search 端可能需要約 24 小時調整。那是官方描述的系統調整時間。等滿 24 小時之後,接下來要看的是日誌和固定題目的回答,設定生效與否由那兩樣決定。
只看 user-agent 就能確認是 OpenAI 官方請求嗎?
user-agent 這個欄位任何人都能自己填,所以它只是自稱。OpenAI 文件提供各 crawler 的 published IP ranges,網站可以依官方公開清單核對來源 IP;實際驗證方式取決於你的伺服器、CDN 與安全工具做得到哪一層。
參考來源
以下依官方文件整理,OpenAI 的 user-agent 名稱、IP ranges 與調整時間以官方頁面當下為準。