AI agent 來網站辦事會卡在哪?詢價、預約與表單準備清單
AI agent 開始替使用者查規格、填詢價表、訂位。這篇整理 agent 怎麼看網頁、最常卡住的五個地方、怎麼辨識 agent 流量,以及哪些步驟該交回人確認。
robots.txt、AI crawler、JavaScript 渲染、sitemap、canonical、schema 與 llms.txt 的實作方式與驗收界線。
11 篇文章
AI agent 開始替使用者查規格、填詢價表、訂位。這篇整理 agent 怎麼看網頁、最常卡住的五個地方、怎麼辨識 agent 流量,以及哪些步驟該交回人確認。
AI crawler 讀不讀得到你的頁面,不是打開瀏覽器看到 200 就算數。這篇給你八層檢查表,把連得上、讀得懂、有沒有被引用分開驗。
Article schema 給的是標題、圖片、日期、作者這幾個機器讀得懂的線索,不是 AI 搜尋的排名開關。這篇整理 Google 的要求、欄位證據、JSON-LD 範例與部署前後的檢查。
canonical 是給搜尋引擎的偏好訊號,不是命令 AI 引用哪個網址的開關。這篇教你把宣告、採用、實際引用三個 URL 分開記,並核對四種訊號。
Google 的 FAQ rich results 已於 2026 年 5 月停止顯示。這篇分開講可見 FAQ、FAQ schema、AI 引用三層,以及 schema 現在還要不要留。
瀏覽器看得到的內容,crawler 不一定拿得到。這篇教你分開檢查初始 HTML、渲染後 DOM 和 AI 回答三種狀態,並講 SSR、prerender、hydration 各自要確認什麼。
llms.txt 是給語言模型的內容導覽牌,管不了門禁。這篇講它跟 robots.txt、sitemap 的分工、什麼情況值得維護,以及 Google 目前怎麼看它。
nosnippet 管的是索引卡上印什麼,noindex 管的是書進不進目錄,robots.txt 管的是書架能不能進。這篇把三個指令對 Google 摘要和 AI Overviews 的作用分清楚。
OpenAI 有三種來訪者:來採訪的、來蒐集資料的、替使用者跑腿的。這篇教你在 robots.txt 裡分開對待 OAI-SearchBot、GPTBot 和 ChatGPT-User。
每家 AI crawler 的用途、user-agent 和 robots.txt 行為都不一樣。這篇用一張跨平台矩陣整理 Google、OpenAI、Anthropic、Perplexity、Apple 與 Common Crawl,附設定範例與七步檢查。
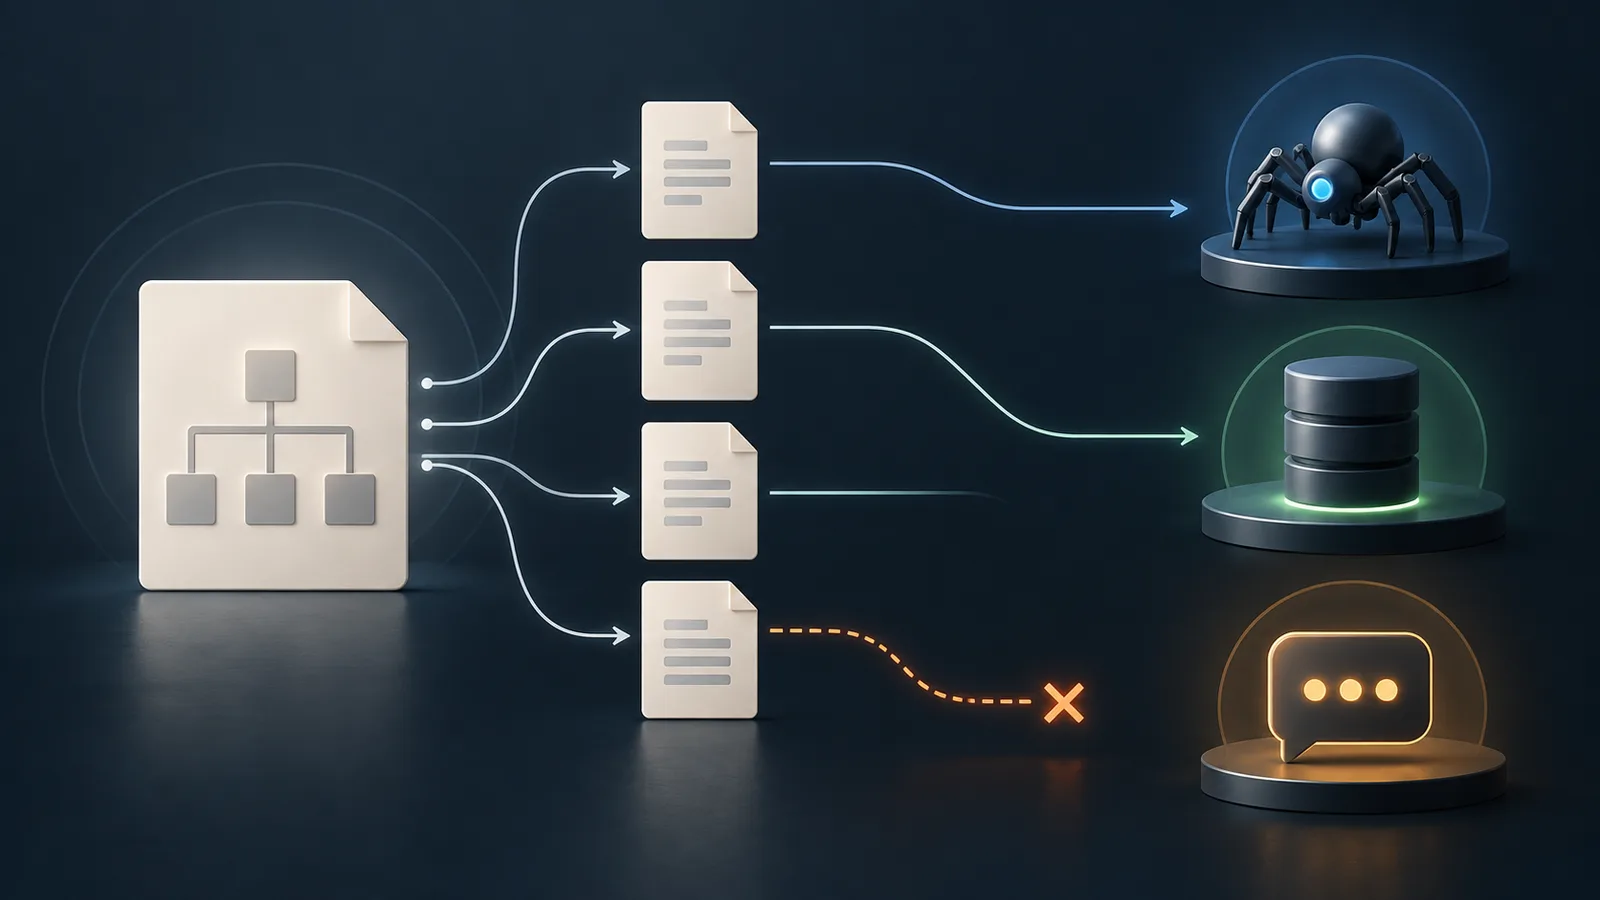
sitemap 是交給搜尋引擎的地址清單,對方會不會照著跑是另一回事。這篇講 sitemap 回答與不回答哪些問題、lastmod 怎麼用、六層檢查怎麼做。