做 source attribution 的方式,是替每個重要主張記下四件事:誰負責、何時更新、依據哪個可查來源、來源支持到哪裡為止。這適用於混了官方規則、專案事實和編輯建議的技術內容;來源只說明 A 產品時,就別把結論寫成所有平台通用。本文提供的是可以逐句套的東西:四類主張標籤、一列 claim ledger 的七個欄位、作者與日期的五種責任、claim-to-source 對照位置、頁面與 schema 的一致性檢查、七步驗收,以及 attribution 和 citation 的分界。
先說清楚這件事的目標:讓讀者查得動,不是讓 AI 引用。Google 的 AI features 文件 把可抓取、可索引與摘要資格列為 AI features 的前提,並把可見文字、內部連結、結構化資料與頁面一致性列為 SEO 基礎;Article 文件說明 markup 可協助理解文章標題、圖片與日期。這些是 Google 列出的資格與最佳實務邊界——Article schema 不是 AI features 的必要條件,其他 AI 產品的引用行為則要另按官方文件與答案觀測確認。
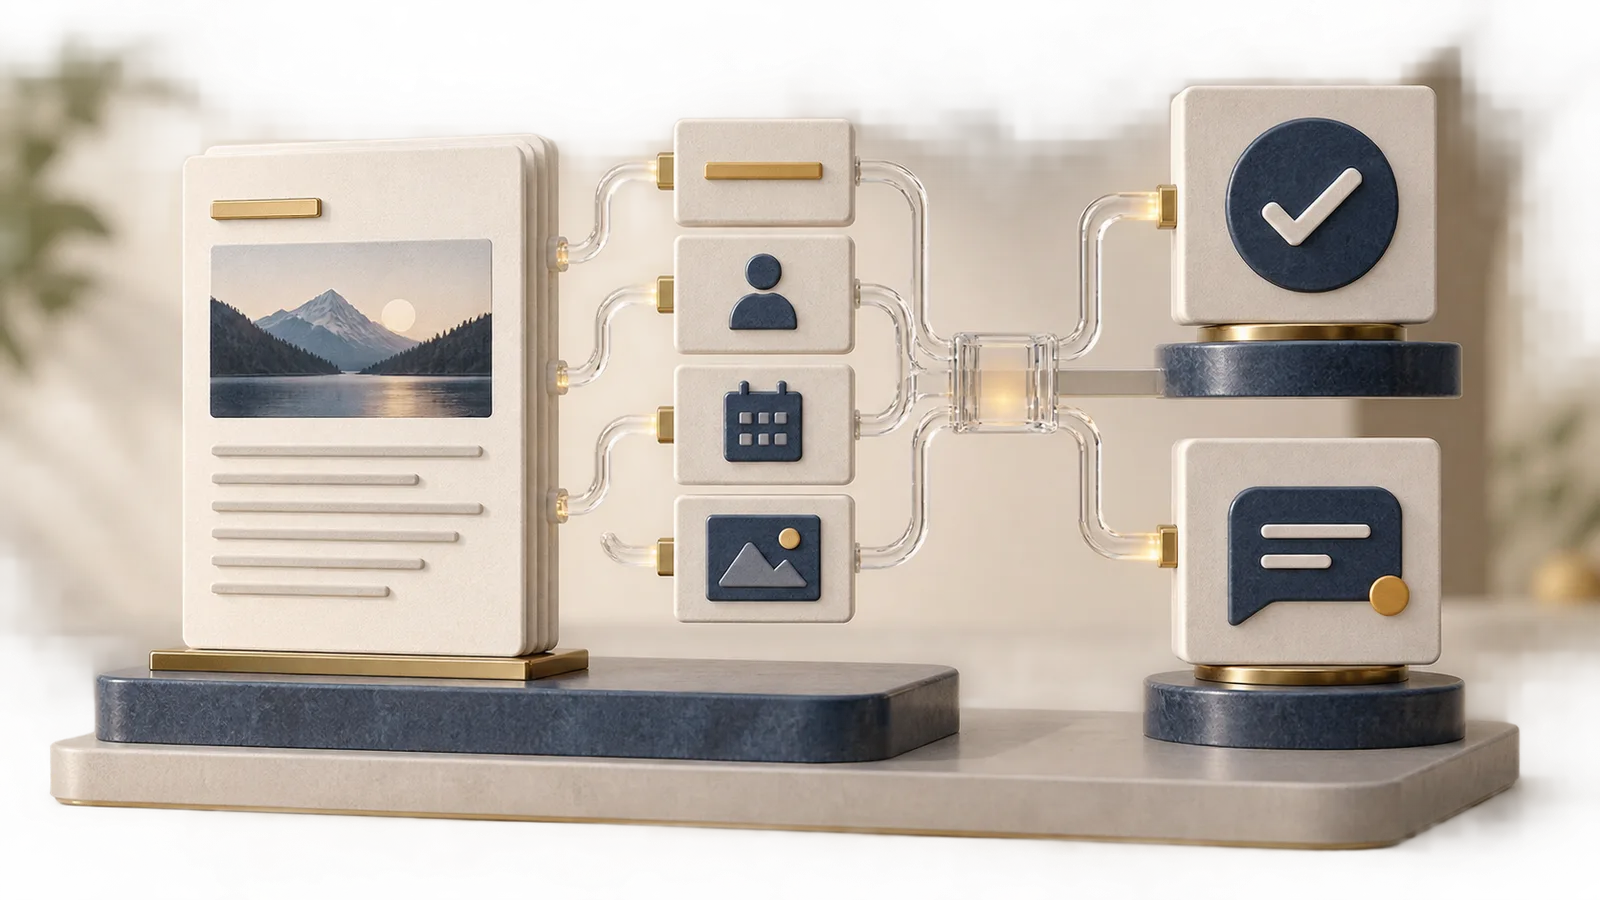 頁面透明度與 AI citation 結果應分開判讀。
先回答 source attribution 是什麼
它不是在文末堆一串連結,而是把主張、責任、時間和證據的關係寫清楚。碰到一個技術或產品主張,讀者至少要答得出三個問題:這是官方規則、專案事實、編輯方法建議,還是待驗證的推論?來源是官方文件、第一手資料、實際測試,還是根本沒有取得?適用日期和產品範圍是什麼?
可以先用四類標籤整理:
| 類別 | 內容例子 | 讀者應看到的 attribution |
|---|---|---|
| 官方事實 | Google 文件對 robots 或 AI features 的描述 | 直接連官方文件與查詢日期 |
| 網站事實 | 網站公開頁面、產品設定或已取得資料 | 連到可公開核對的來源,註明頁面狀態 |
| 編輯建議 | 根據需求設計的檢查步驟、表格或優先順序 | 明確寫「建議」和依據,不冒充官方規則 |
| 推論或未知 | 由條件推導的可能影響、未取得的產品結果 | 標示推論、未確認或無資料 |
這個分類擋住的是兩種常見滑坡:把「Google 說可以協助理解」寫成「Google 一定會引用」,以及把編輯建議寫成普遍適用的規則。source attribution 的價值在可追溯,跟連結數量無關。
一個主張需要哪些來源欄位
每個重要主張都可以用一列 claim ledger 管理:
| 欄位 | 要記錄什麼 | 範例形式 |
|---|---|---|
| claim | 要被讀者相信的具體句子 | nosnippet 對 Google AI Mode 的直接輸入範圍 |
| source | 支持它的 URL 或檔案 | Google robots meta 文件 |
| source type | 官方、第一手、專案、推論 | D、專案事實、推論 |
| date | 來源檢查或資料期間 | 2026-09-21 |
| scope | 適用產品、地區、語言、版本 | Google Search、AI Mode |
| support | 來源直接支持到哪裡 | 摘要控制,不支持排名提升 |
| status | 已驗證、部分、未確認、無資料 | verified、partial、未確認 |
scope 和 support 兩欄是整張表的守門員。舉例:Google 的 AI optimization guide 目前說 Google 忽略 llms.txt,不會改變 Search 曝光或排名——這句話支持的範圍就到 Google Search 為止。寫成「所有 AI 平台都不讀」,是拿一家的文件去管七家。
引用數字時,也要記期間、分母和取樣規則。資料只有少量查詢樣本的話,寫成「指定樣本中的提及率」;命名成所有平台的通用 SOV,那個名字自己就是一個沒有來源的主張。
作者、日期與更新責任
作者與日期不是裝飾欄位,而是讀者判讀責任和新鮮度的入口。頁面可以清楚呈現:
- 作者:誰負責文字和專業判讀,名稱與 frontmatter、頁面和 schema 一致。
- 審核或編輯責任:有不同角色時,說明誰核對來源或技術範圍;沒有這個人就別造一個 reviewer。
- published date:首次公開或草稿狀態依網站治理規則呈現。
- updated date:有實質內容或來源更新時才改,並且回得到變更紀錄。
- 查核日期:時間敏感的官方政策和產品狀態,在來源清單或段落旁標日期。
作者頁不是每個 AI Search 產品的已知必要條件,本篇也不把它寫成必要門檻。更重要的是頁面有沒有清楚交代責任、證據和範圍。團隊若沒有 author notes 或案例素材,就保留未知——填入虛構經驗,是這一層最不該出現的東西。
更新日期也不等於 Google 已重新抓取,或 AI 答案已經更新。網站可以記錄 source changed、page changed、Google indexed、AI observed 四個狀態;其中任何一個沒有第一手資料,日期欄位都補不上去。
claim-to-source 對照表
一篇長文可以在正文附近提供來源,也可以在文末提供完整清單。兩者各有作用:
| 主張位置 | 來源做法 | 讀者得到什麼 |
|---|---|---|
| 直接回答段 | 句末接官方文件 | 快速核對核心結論 |
| 技術表格 | 每列或表頭註明適用來源 | 知道表格不是編輯想像 |
| code example | 說明是語法示意,連官方文件 | 不把範例當已部署結果 |
| 方法與 checklist | 標明編輯建議和依據 | 知道哪些是 recommendation |
| FAQ | 回答內附來源或回到主段 | 不讓 FAQ 變成未溯源的摘要 |
| 文末 source log | 列 URL、日期、scope | 便於後續更新和交接 |
來源連結要直接支持那個句子。Google 的 Article 文件支持的是「Article markup 欄位要和可見內容一致」,撐不起「Article schema 一定提高 AI citation」;OpenAI bot 文件支持 OpenAI crawler 的產品用途,說不到 Google 或其他 AI 平台的行為。修文時逐句檢查這條邊界。
頁面結構與 schema 一致性
頁面 attribution 至少要在這幾層互相一致:
- 可見 H1、title 和 description 描述同一個主題。
- 作者名稱和日期與 Article schema、頁面 author block 相符。
- 來源連結是公開、可請求、指向實際支持主張的頁面。
- JSON-LD 不填入正文、作者或圖片沒有的資訊。
- canonical、sitemap、內部連結和引用 URL 的差異有被記錄。
nofollow、robots、noindex 或登入限制若存在,說明它影響哪一層。
Google 的 Article structured data 文件 說明 markup 可協助理解標題、圖片和日期;結構化資料介紹與一般結構化資料政策則要求結構化資料描述頁面上可見的內容、並與其相符。那是結構化資料的直接規範。source attribution 要再補上來源實體、日期、scope 和主張支持範圍——schema 管格式,attribution 管證據。
若要把來源歸屬放回內容與 AI 搜尋治理,可先看 EthorX GEO 服務;產品觀測入口可參考 Otlex。這些頁面不是本文的 AI citation 外部成果證據。
7 步來源歸屬驗收
- 把文章中的可驗證主張列成 claim ledger,標記官方事實、專案事實、建議、推論和未知。
- 對每個官方事實找到直接的官方或第一手來源,記錄 URL、日期和適用產品。
- 把來源連到句子或表格附近,檢查連結是否真的支持完整主張。
- 對數字保存期間、分母、樣本和計算方式,沒有資料就寫無資料。
- 核對作者、日期、schema、canonical、圖片 alt 和可見內容的一致性。
- 查初始 HTML、rendered DOM、HTTP、robots 和來源連結是否對 crawler 可用。
- 將 AI citation observation 另記 query、產品、日期、答案、cited URL 和未觀測狀態。
這七步能回答「頁面是否較容易被核查」。它回答不了「AI 是否一定引用」——正式發布、部署、Google 工具檢查和公共答案觀測是四個不同狀態,報告時分欄寫。
source attribution 與 AI citation 的差異
| 概念 | 證據單位 | 可回答 | 不能回答 |
|---|---|---|---|
| source attribution | claim、source、日期、scope | 這句話依據什麼、誰負責 | AI 產品一定會不會選用 |
| crawl/index | URL、crawler、response、索引資料 | crawler 是否取得、搜尋系統是否有資料 | 特定答案一定引用 |
| AI citation | query、產品、日期、cited URL | 某次答案是否顯示來源 | 全平台市場份額或長期因果 |
要算 citation rate,先說清楚分母,例如「指定 query 樣本中,有可判讀來源的回答裡,出現該頁 cited URL 的比例」。沒有完整 query 集合、有效回答數或產品範圍時,只報告觀測到的個案或無資料。來源歸屬改善的是可核查性——它提高了讀者查證的效率,跟結果保證是兩件事。
常見問題
source attribution 只要在文末列參考資料就夠了嗎?
文末清單有助於集中管理。重要或容易誤讀的主張仍要在段落附近連到直接來源,並說明來源支持的範圍——讀者在第五段產生疑問,不會翻到文末去比對十條連結。
作者頁是 AI Search 的必要條件嗎?
本篇查到的 Google AI features 文件沒有訂出「必須有作者頁」這個門檻。建議是清楚呈現作者、責任與來源;要不要獨立的作者頁,依網站架構和讀者需求決定。
更新日期會讓 AI crawler 重新引用頁面嗎?
更新日期說明的是頁面聲稱何時修改。crawler 抓取、搜尋索引和 AI citation 各自要驗收,沒有抓取或答案資料時就保留未確認。
source attribution 可以取代 Article schema 嗎?
兩者責任不同。可見的作者、日期與來源讓讀者核查,Article schema 提供機器可解析的線索;schema 仍要和可見內容一致,而且兩者都不是 AI citation 命令。
沒有第一手來源時,可以用推論寫成事實嗎?
把句子標成推論、編輯建議或未知,並說明推論依據和限制。主張需要第一手證據卻沒有取得的話,保留無資料比填一個看似合理的來源準確——後者會在下一手被當成已查證。
如何避免來源連結支持過度結論?
逐句比較主張與來源原文的適用產品、日期和語氣。來源只說「可協助理解」,文章就寫到那裡;來源只描述 Google,就別推廣成所有 AI 平台。必要時把一句話拆成官方事實、推論和建議三句。
查證邊界
本文以 Google Search 的 AI features、結構化資料與內容歸屬文件整理可核對的技術事實,其餘 claim ledger、責任欄位與驗收順序是編輯方法建議。本文沒有取得每個 AI 產品的內部選用規則、正式環境抓取 log 或固定查詢的完整答案樣本,因此作者、日期與來源對照不能證明特定頁面已被引用,也不能代替產品與日期限定的實際觀測。沒有來源、分母或第一手結果時,保留未確認或無資料。