你在台南開一家冷氣安裝保養公司,全公司 12 個人。每個月 LINE 和官網大約進來 400 則詢問,助理小安同時要接電話、排師傅,還要一則一則看訊息,把要派人到府的先回,問濾網怎麼洗的排到後面。到了夏天訊息一多,她就回不完了。上個月有三位要裝機的客人等到隔天才收到回覆,其中兩位回說已經找別家了。
你手上還有另一件事。公司有賣年度保養合約,三年下來累積了大約 2,400 筆保養單,你想知道明年哪些客戶可能不續約,好提早打電話。朋友跟你說這要用機器學習,來報價的廠商卻說直接接 ChatGPT 就好。
你要決定的是該用哪一種做法,以及手上的資料夠不夠。這家公司是我們寫的示範情境,實測用的則是我們自己網站的搜尋查詢,它和 LINE 訊息的差別也會講清楚。
機器學習是什麼?
機器學習是訓練軟體從資料裡找出規律,再用這個規律去預測或分類新資料的方法。Google 的定義是「訓練軟體(稱為模型)的過程,目的是根據資料做出實用的預測或生成內容」。
它和一般程式的差別在於規則是誰寫的。一般程式是你把規則寫好,例如「訊息裡有報價兩個字就先回」。機器學習則是你拿一堆已經分好類的訊息給電腦,由它自己算出哪些用詞和哪一類有關。
我們會用一個比喻來想它。
機器學習像新來的助理,看小安回過的訊息學判斷。
- 那些舊訊息就是訓練資料。
- 有人在每則訊息旁邊註明「要派人」或「只是問問題」,這個註明就是標籤,也就是正確答案。
- 新人看久了心裡形成的判斷方式,就是模型。
- 新訊息進來時他判斷一次,就是預測。
這個比喻不成立的地方是,真人助理講得出為什麼,遇到沒見過的情況也會跑來問你。簡單的模型頂多告訴你它看重哪些詞,複雜的模型多半講不清楚,而且遇到沒見過的還是會給一個答案。
機器學習分哪三大類?
機器學習常見的入門分法是監督式學習、非監督式學習和強化學習,差別在於訓練時給電腦什麼樣的資料。這是慣用的分法,不是統一的標準。
- 監督式學習:資料附正確答案,就是上面那些註明過的訊息。選一個類別叫分類,例如要不要派人。算一個數字叫迴歸,例如下個月要備多少台冷氣。
- 非監督式學習:資料沒有答案,由電腦自己分群。它可以把保養客戶分成幾群,但每一群代表什麼,要由你去看才知道。
- 強化學習:電腦反覆試,做對有獎勵、做錯有懲罰,AlphaGo 的訓練就用到它。以我們的判斷,一般公司很少需要。
Google 的入門教材還把生成式 AI 列成第四類,也就是模型學完之後會產出新內容,所以你看到三類或四類的說法都不算錯。
回到冷氣公司,分詢問和猜續約都屬於監督式學習的分類,所以要先問手上有沒有附正確答案的舊資料。詢問這邊目前沒有,因為小安看過就回,沒有留下註明。續約這邊的答案就在合約紀錄裡,看每次到期後有沒有續簽。
機器學習怎麼做?三個步驟是什麼?
機器學習的做法可以濃縮成準備資料、訓練模型、用沒看過的資料測試這三步。
- 準備資料:收集舊資料,再標上正確答案。例如把舊訊息標成要派人或只是問問題,或把每次合約到期標成有沒有續約。
- 訓練模型:把大部分資料交給程式,讓它算出線索和答案的關係。詢問的線索是用詞,續約的線索是保養次數這類欄位。
- 用沒看過的資料測試:留一部分資料不給它看,最後拿來考試,再算準確率,也就是答對的題數除以總題數。
第 3 步是判斷能不能用的依據。如果拿訓練過的資料來考,就等於考前先給答案,分數再高也不代表它處理得了新訊息。上線之後,客人的用語和機型也會變,夏天和冬天問的事情也不一樣,所以要定期抽一批新訊息再考一次,我們建議至少每季一次。
該用機器學習、規則還是生成式 AI?
先試規則,等你有了資料、目標也清楚,就可以換機器學習。要產出內容用生成式 AI。生成式 AI 也能做分類,所以分類這件事要讓它和規則、模型用同一批題目比。
先試規則的依據是 Google 的機器學習規則。第一條說不必擔心推出不含機器學習的產品,「如果產品並非絕對需要機器學習,請等到有資料時再使用」。第三條說簡單規則能讓產品上市,複雜的規則卻無法維護,取得資料並對目標有基本概念後,就該用機器學習。生成式 AI 怎麼排,這份文件沒有談,那部分是我們的判斷。
| 你的狀況 | 先用 | 冷氣公司的例子 |
|---|---|---|
| 幾個詞或幾個條件就能判斷 | 規則 | 訊息有多少錢、報價、安裝就先回 |
| 要看很多欄位一起判斷,規則寫不完 | 機器學習 | 從機型、保養次數、區域猜續約 |
| 文字沒有固定格式,規則一直漏 | 模型和生成式 AI 用同一批題目比 | 客人一句話同時講保養和報修 |
| 要產出文字 | 生成式 AI | 替小安草擬回覆 |
| 預測完不知道要做什麼 | 先不做 | 名單算出來了,還沒決定誰打、打了說什麼 |
最後一種情況來自 Google 的提醒,預測如果轉不成動作就沒有價值。
那廠商說的接 ChatGPT 呢?它背後是 LLM(大型語言模型),是別人用深度學習訓練好的,所以接它不代表你要自己訓練模型,把分類方式寫成指示就能開始。
不過每月 400 則一則一則手動貼並不划算,你要請人用 API(讓兩套軟體直接連線的介面)接起來,或者用客服工具內建的 AI 功能,通常會有用量費用。如果沒有先遮蔽,客人的姓名和電話也會傳到外部服務。
要知道它準不準,同樣要有標好答案的題目。這次我們沒有測這個方法,所以沒有數字,上面的費用與個資提醒也是我們的判斷。分類完如果還要自動回覆或開單,那已經是另一件事了,也就是自己決定下一步、動手做完的 AI agent。
我們實測 356 句查詢,模型有比規則準嗎?
在這次測試裡,模型沒有贏過規則,但是規則占了便宜。89 句測試題裡,規則法答對 83 句,模型答對 80 句。
我們用的是 ethorx.com 在 Google Search Console(看網站被搜尋到哪些字的後台)的 931 句查詢,期間是 2026 年 10 月 7 日到 11 月 3 日。
判斷題是「這句是想買或想比較,還是只想了解」。這和小安分訊息是同一類型的問題,但是類別不同,你要分的是要派人和只是問問題,所以下面的分數不能直接換算。
我們先濾掉網址、進階搜尋語法和超過 45 字的長句,剩下 889 句。其中品牌名、單一名詞這類看不出目的的 533 句不標,只標另外 356 句,想買或想比較的有 133 句,想了解的有 223 句。
接著隨機拿 267 句訓練,留 89 句測試。規則法是看句子裡有沒有「推薦、比較、公司、費用」這類 24 個詞。模型用的是單純貝氏分類器,它會算每個詞出現在兩類裡的機率,再判斷整句比較像哪一類。這種模型夠簡單,一個小程式就寫得完,不用買任何工具。
| 方法 | 89 句答對幾句 | 準確率 | 33 句想買,找到幾句 | 56 句想了解,誤判幾句 |
|---|---|---|---|---|
| 全部猜「想了解」 | 56 | 62.9% | 0 | 0 |
| 全部猜「想買」 | 33 | 37.1% | 33(100%) | 56 |
| 規則法 | 83 | 93.3% | 29(88%) | 2 |
| 單純貝氏模型 | 80 | 89.9% | 27(82%) | 3 |
「找到幾句」和「誤判幾句」要一起看。全部猜想買可以找到 100%,可是 56 句想了解也全被判錯了。
這個結果要打不少折扣。
- 規則看過答案:我們看過整批資料之後才寫規則,所以它的成績偏高。
- 題目篩過:533 句看不出目的的查詢被排除,占 889 句的六成。留下來的多半幾個詞就能判斷,這對關鍵字規則有利。
- 標註只做過一次:這 356 句是我們自己標的,規則也是我們寫的,沒有第二個人複核。模型學到的詞和規則很像,可能有一部分是因為標註和規則都出自我們自己。
- 只試了一種模型:所以「模型沒贏」只代表這一種簡單模型。
只把資料切成訓練題和測試題一次,也可能剛好運氣好,所以我們又隨機重切 200 次。規則法平均 93.7%,模型平均 86.4%,規則法贏 189 次,模型贏 6 次,平手 5 次。多切幾次之後模型平均反而更低,但是規則一直是同一份,所以規則分數偏高這件事不會因此消失。
兩邊錯的地方不太一樣。規則法只看字面,所以「如何讓自己的品牌更容易被 chatgpt 推薦?」明明在問做法,有「推薦」就被判成想買。模型則是沒見過的就容易猜錯,例如「買backlink」(想買外部連結)被判成想了解。
模型認為最像想買的詞是比較、公司、工具、費用、軟體,也學到兩個只和我們網站題目有關的工具名稱,換一個行業就沒有用了。
所以這只是一次小測試,不能說規則普遍比模型好。這次只看得出,這種簡單模型沒有明顯贏過事後寫的規則,所以不必急著先訓練模型。而 LINE 訊息比搜尋查詢長,一句可能講好幾件事,有時還只傳一張照片,所以小安的訊息會比這批題目難。
那換成冷氣公司的句子呢?我們另外寫了 20 句,照你要的分法標成 10 句要派人、10 句只是問問題,拿同一套規則和模型去考,判成想買的就算要派人。句子是自己寫的,這個分法也是看過第一次結果才改的,所以只能看方向。全部猜同一類就有 10 句對,這是要比的基準。
規則法答對 11 句,10 句要派人裡只找到 2 句,因為「多少錢」「報價」「優惠」都不在規則裡。模型答對 13 句,找到 8 句,可是它判成要派人的 13 句裡只有 8 句是對的,「多久要洗一次」「遙控器符號」這類問題也被算進去。兩邊都沒有比基準高多少。
所以把寫給搜尋查詢的字詞清單搬過來用,幾乎抓不到要派人的訊息,模型抓得比較多,但也誤判得多。
不管是規則、別人的模型還是 ChatGPT,都要先用你自己的訊息考過。Google 規則第一條提醒的是另一種情況:拿其他問題的資料來調整模型,「可能會比基本啟發法的表現差」,啟發法就是簡單規則。我們這次沒有測這個情況,但它也是要自己考過的理由。
機器學習的資料要多少才夠?
機器學習沒有通用的資料量門檻,要看問題多難、模型多大,所以你的資料夠不夠,要考過才知道。只看有沒有「報價」兩個字是簡單的問題,一句話裡同時講保養和報修就難得多。Google 的教材也寫,簡單的問題幾十筆可能就夠,有些問題一兆筆也不夠。
在這次測試裡,訓練資料從 10 句加到 160 句時,準確率一路上升。
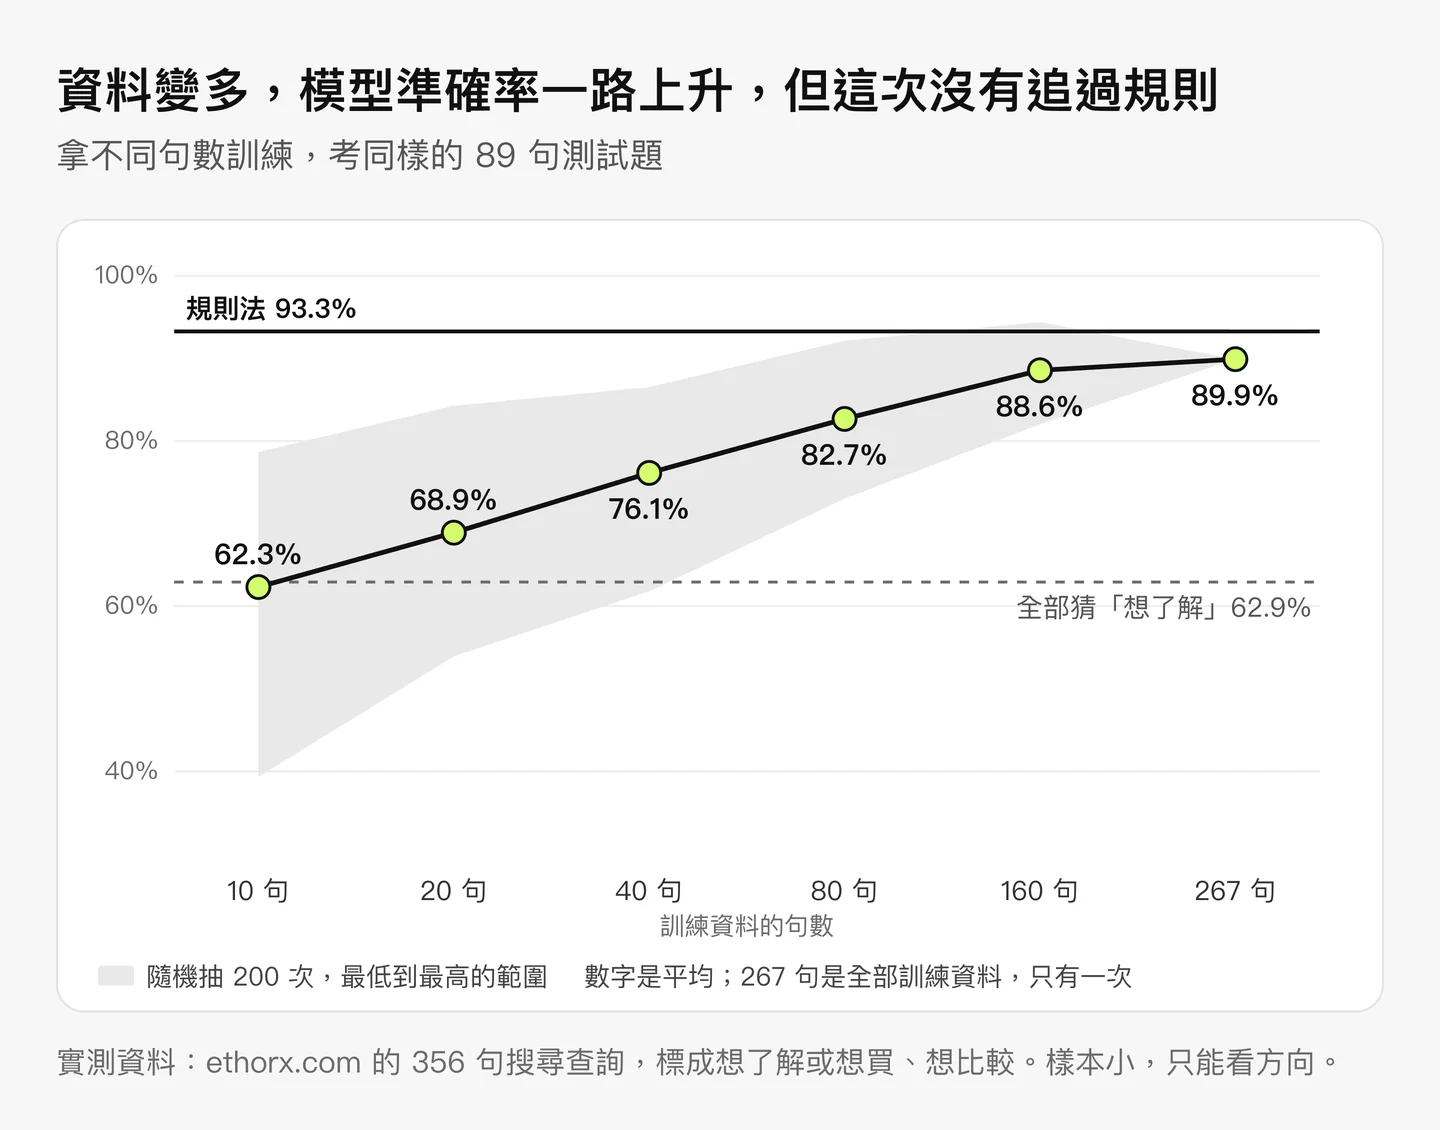
10 到 160 句的每個資料量,我們都隨機抽 200 次取平均。10 句的時候,模型平均 62.3%,和全部猜「想了解」的 62.9% 差不多。而且抽到哪 10 句影響很大,低的時候只有 39.3%,高的時候有 78.7%。
從 160 句加到 267 句只多了 1.3 個百分點,大約等於多對 1 句,而 267 句是整個訓練集,只有一種抽法,所以看不出準確率上升是不是真的變慢。重切 200 次時模型平均只有 86.4%,也表示這 89 句對模型偏容易。這條曲線是這批題目算出來的,160 句不能當成你的目標。
除了數量,Google 也建議資料符合這些條件,例子是我們換成冷氣公司的。
- 一致而且正確:資料的收集方式要一致,標籤也要對。放到這裡,就是小安和另一位同事對同一則訊息要標得一樣。
- 預測當下拿得到:如果要在合約到期前兩個月預測,保養次數就只能算到那一天。到期之後才發生的事放進去,考試成績會很好看,實際上卻用不到。
- 有代表性:只拿夏天的詢問訓練,冬天的詢問可能就不準。
Google 另外有個粗估法則,訓練資料至少要比模型可調的參數(訓練時要算出來的數字)多 10 到 100 倍,而且好的模型用的資料通常遠多於這個數。所以它只是下限,不代表到了就夠。
這時候回頭看那 2,400 筆保養單,張數不是答案的數量。續約的答案是每次合約到期一個,所以資料要整理成每個到期週期一筆,答案是那一次有沒有續約,還沒到期、不知道結果的要排除。如果平均一位客戶三年有三張單,那就只有 800 位客戶,到期的筆數通常也比 2,400 少。
真正決定夠不夠的是裡面有幾筆沒續約。只有幾十筆的話,模型能學的例子太少,留給考試的題目也沒幾題。這是我們的判斷,不是公認的門檻。
深度學習是什麼?和機器學習差在哪?
深度學習是機器學習裡的一種做法,差別在於它用多層類神經網路(一層層計算單元串起來的模型),自己從原始資料裡找判斷線索,所以需要的資料和運算量大很多。這些線索也叫特徵,一般機器學習的特徵多半由人挑,例如保養次數。Google Cloud 的比較可以整理成下面這樣。
| 比較項目 | 一般機器學習 | 深度學習 |
|---|---|---|
| 資料量 | 需要大量欄位整齊或有標註的資料 | 非常龐大,通常到數百萬筆 |
| 硬體 | 一般電腦通常就夠,複雜的模型要更強的機器 | 通常要 GPU 或 TPU 這類高效能晶片 |
| 特徵 | 多半要人工挑選 | 減少人工挑選的需求 |
| 訓練時間 | 幾秒到幾小時 | 幾小時到幾週 |
| 判斷過程好不好解釋 | 視模型而定,簡單的模型比較好解釋 | 通常比較難解釋 |
| 常見用途 | 垃圾郵件、客戶流失預測 | 圖片辨識、語音、自然語言 |
換到你的公司,保養單這種欄位整齊的資料用一般機器學習就好。LINE 訊息是文字,Google Cloud 把自然語言列在深度學習。不過我們的小實測用簡單模型也分得了短句子,所以你的訊息該用哪一種,一樣要用考題比過才知道,不必先自己訓練深度學習。
回到冷氣公司,接下來要做什麼?
先處理詢問分類,因為它的損失已經看得到,上個月就有兩位客人找了別家。
- 先定類別:分成「要派人到府」(裝機、保養、報修)和「只是問問題」,客人問滴水就算要派人。
- 先抽考題:把不同月份的訊息匯出來,至少涵蓋夏天和冬天,抽 400 則。怎麼匯出要先問 LINE 後台或客服工具的廠商,只有單月的話就要記得換季再考一次。先隨機封存 100 則當考題,寫規則和訓練模型時都不能看。
- 交給不寫規則的人標:小安標這 400 則,每則算 15 秒大約 100 分鐘,這段時間要替她排出來。另一位同事也標那 100 則考題,兩人不一樣的地方講好標準再定案。規則由你或廠商寫,只看另外 300 則。400 不是門檻,考完不夠再多標。
- 用同一份考題比較:先比規則和 ChatGPT,兩邊都沒達標才訓練模型。廠商說接 ChatGPT 就好,就把姓名和電話遮掉,把這 100 題給他考,答案留在你手上,請他交回每題的判斷和每則的費用。不願意考的廠商,也是一種答案。
- 決定用哪一種:在達標的做法裡,把建置費、每月費用和誰來維護都算進去再選。
要看的數字有三個,門檻要在考試前先定好。下面的門檻只是例子,要依你能接受的損失來定。
- 找到幾成:要派人的訊息被找到幾成,例如最多漏一成,因為漏掉一位要裝機的客人,比多回一則濾網問題貴得多。
- 判對幾成:被判成要派人的訊息裡,真的要派人的占幾成,例如至少七成。少了這個數字,全部判成要派人就能找到 100%,小安卻一點也沒有輕鬆。
- 等多久:這類客人第一次收到回覆要等多久。用 LINE 的時間紀錄算出上個月的中位數當基準,下班後傳的分開算,因為下班後那段等待,分類再準也救不了。
前兩個沒達到就不上線。上線後每季抽 100 則新訊息再考一次,分數掉了就回頭改。
續約的問題排第二。先定義什麼叫不續約,例如保養合約到期後 60 天還沒續簽。接著把保養單整理成每個到期週期一筆,數出續約和沒續約各幾筆。
沒續約的如果只有幾十筆,就先用規則,例如到期前 60 天還沒續簽、而且這一年報修過的先打。如果有幾百筆,可以試模型,欄位只用到期前兩個月拿得到的,再用前兩年訓練、最後一年考,因為你要預測的就是未來。它要贏過上面那條規則,才值得留下來。
不管用哪一種,都要先講好誰打,名單出來後隨機留一半先不打,再比較兩邊的續約率。如果是挑人打,比出來的差距可能只是那些人本來就會續約。
規則可以請客服工具的廠商設定,模型和 API 要找會寫程式的人,你只要守住考題和答案。等分類要接進 LINE 後台、自動提醒小安先回,就不只是模型準不準的問題,還要把它接進公司內部的流程。我們的企業 AI 營運做的就是這一段。
常見問題
機器學習和 AI 差在哪?
AI 是讓電腦做出像人一樣判斷的統稱,範圍很大。機器學習是其中的核心做法。
學機器學習一定要會寫程式嗎?
公司要判斷該不該用,不需要會寫程式。自己動手做模型的話,通常就要會 Python。
ChatGPT 算機器學習嗎?
算。ChatGPT 背後的 LLM 是用深度學習訓練出來的,而深度學習是機器學習的一種。
資料只有幾百筆可以做機器學習嗎?
可以試簡單的分類,但一定要留一部分當測試題,也要和規則法比較。我們這次用 267 句訓練的模型沒有贏過規則,不過規則是看過資料才寫的,所以這不能證明幾百筆不夠。