你在一家做不鏽鋼法蘭的工廠當業務經理,客戶都叫你王經理,每天要回幾十封詢價信。週會上老闆說:「隔壁那家說他們訓練了自己的 AI 在回信,我們是不是也該訓練一個自己的 LLM?」
大家散會後各自去搜尋,結果看到 GPT、Gemini、生成式 AI、RAG、agent 一整串名詞,越看越不確定該從哪裡回答。
要回答老闆,你得先知道 LLM 是什麼、怎麼產生答案,以及會在哪裡出錯。弄懂之後,你才判斷得下去:要不要讓它先查公司的文件(這叫 RAG),要不要讓它直接操作公司的系統(這叫 agent)。下面這種信你信箱裡很常見,這篇就拿它從頭走一次。
王經理您好,上次那批 SUS304 法蘭 500 件品質很穩定。這次想改成 800 件,交期能不能在 11 月 20 日前?單價可以再談嗎?報價請註明是否含稅與運費。謝謝。
LLM 是什麼意思:讀過大量文字、學會接下一個字的大型語言模型
LLM 是 Large Language Model 的縮寫,中文叫「大型語言模型」。它是用大量文字訓練出來、能讀懂也能寫出文字的模型,所以它能回答問題、翻譯、摘要和改寫(AWS、Google Cloud)。
法學碩士的縮寫「LL.M.」看起來很像,但這篇講的是 AI 的大型語言模型。
「大型」指的是訓練資料和參數都很多。光是 AWS 提到的 Common Crawl 網頁資料集,就有超過 500 億頁。GPT-3 的參數則有 1,750 億個。參數是模型內部可以調整的數值,訓練就是把這些數值一點一點調整,直到預測變準為止。
可以把 LLM 想成一個讀過大量文字的手機輸入法。
你在手機上打「上次那」,輸入法會跳出「批」「次」「個」讓你選,因為它看過很多人這樣打字。LLM 做的是同一件事,只是規模大很多。
- 看前文猜下一個字:它看著目前為止的整段文字,猜接下來最可能是哪一個字。
- 讀得越多,猜得越像樣:訓練時讀過的文字量大到難以想像。所以它接出來的句子通順、口氣也對。
- 只管順,不管對:輸入法不會查證你打的字是不是事實,LLM 也一樣,它產生的是「最可能接下去的文字」,事實正確與否要另外把關。
這個比喻也有對不上的地方。輸入法只猜一兩個字、等你選,LLM 會照你的指令,自己一路接上幾百個字。而且 LLM 讀過的書沒有存起來可以翻查。
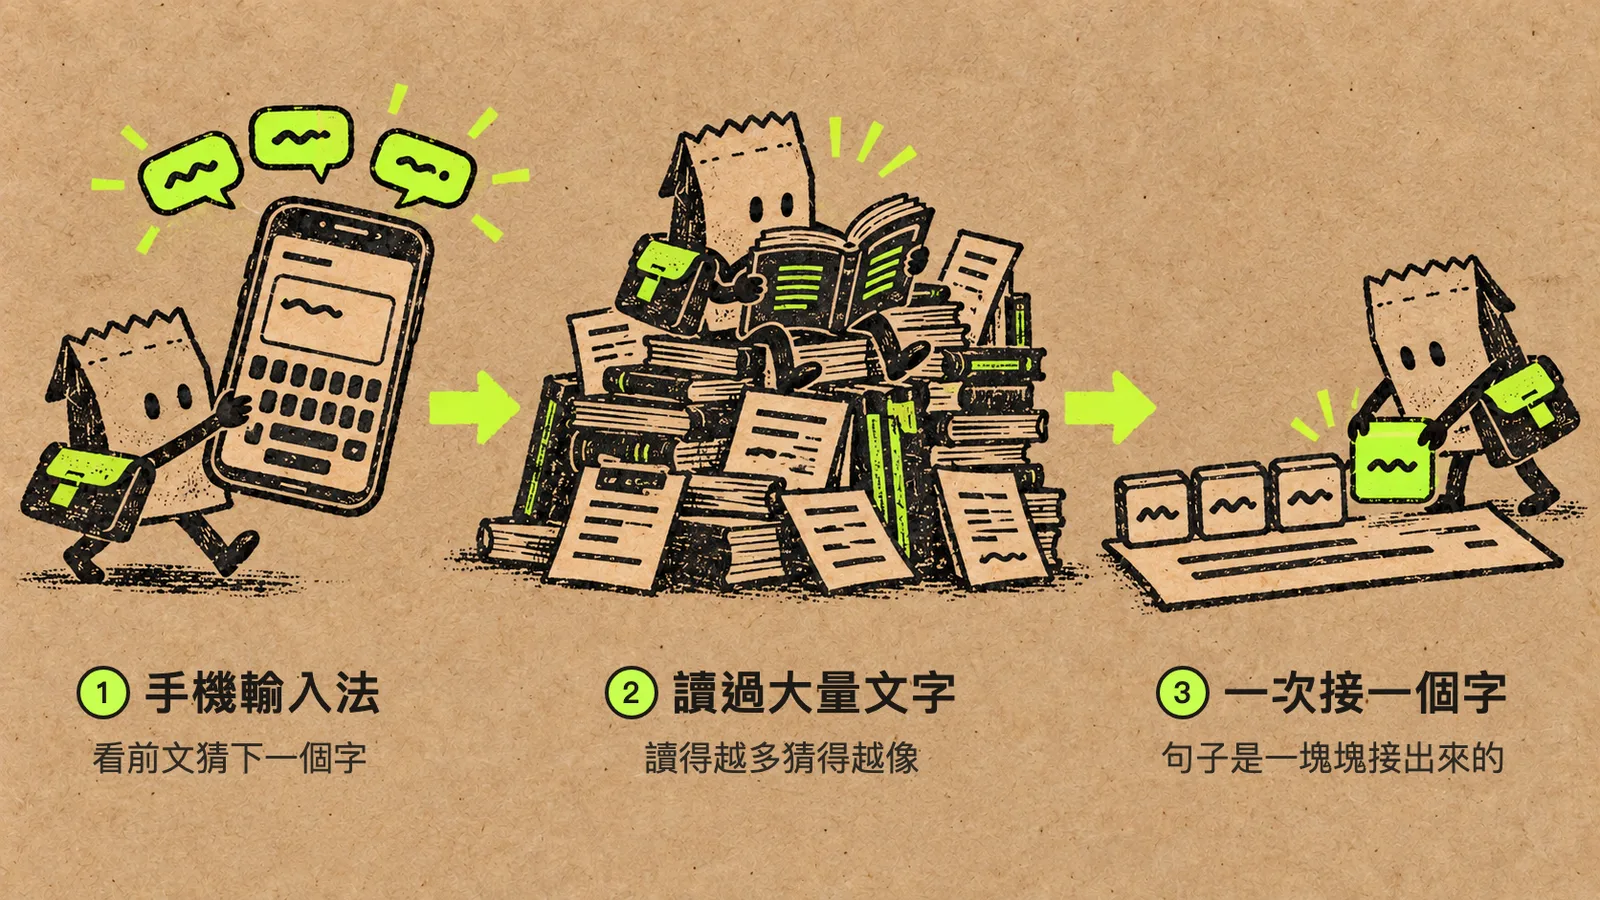 輸入法和 LLM 都是看前文猜下一個字,差在 LLM 看過的文字多很多,也會自己一路接下去。
ChatGPT 是 LLM 嗎?LLM、生成式 AI、ChatGPT 和 AI agent 的關係
ChatGPT 是聊天產品,不是 LLM 本身,它背後用的 GPT 系列才是 LLM。Gemini 和 Claude 比較特別,同時是模型的名字,也是產品的名字。所以有人說「我在用 Gemini」,可能是指模型,也可能是指聊天應用。下表的名詞常被混在一起講,指的卻是不同層次的東西。
| 名詞 | 是什麼 | 在詢價信這件事上 |
|---|---|---|
| 生成式 AI | 能產生新內容的 AI 總稱,包含文字、圖片、聲音 | 寫回信、生成產品圖都算 |
| LLM | 生成式 AI 裡以文字為主的模型(新一代多半也能讀圖),例如 GPT、Claude、Gemini,以及 Google 的開放模型 Gemma | 讀懂詢價信、寫出回信草稿的那個模型 |
| 聊天產品 | 把 LLM 包成介面給人直接用,例如 ChatGPT、Claude、Gemini App | 你把信貼進 ChatGPT 請它擬回信 |
| RAG | 回答前先查你的文件,讓 LLM 依資料作答 | 擬回信前先查公司的價目表和出貨紀錄 |
| AI agent | 由 LLM 判斷下一步,自己去用查詢、寫入這類系統功能,把好幾個步驟做完 | 讀信、查庫存、擬報價,再交給你確認後寄出 |
生成式 AI 能幫公司做哪些事、哪裡一定要人確認,整理在生成式 AI 是什麼。如果你要的只是分類或預測一個數字,不一定要用到 LLM,先看機器學習會比較清楚。
RAG 和 agent 則是在 LLM 外面,加上查資料或操作系統的能力。
AI 要連上 ERP(進銷存與生產管理系統)、CRM(客戶管理系統)去查訂單和客戶資料時,常用的共通規格是 MCP。
agent 和聊天機器人、RPA 的差別,可以看 AI agent 和聊天機器人、RPA、自動化流程差在哪。最近常聽到的 Agentic AI,是指能自己規劃、動手的 AI 系統,和 AI agent 的差別寫在 Agentic AI 是什麼。
LLM 怎麼運作:把文字切成 token,一次預測一個
先把文字切成 token
模型讀的不是「字」,而是 token,也就是模型處理文字時用的單位。一個 token 可能是一個中文字、兩個字組成的詞、一個英文單字、半個單字或一個標點。英文大約 4 個字元是一個 token(OpenAI)。中文的比例要看模型怎麼切,因為每一代模型切字的規則都不一樣。
我拿開頭那封詢價信,用 OpenAI 公開的切字工具 tiktoken 算了一次。這封信不算空白是 76 個字元,token 數則要看切法。
- GPT-4o 之後、包括 GPT-5 系列用的切法(o200k_base):68 個 token。「您好」「品質」「可以」各被切成一個 token,「SUS」「304」也各算一個。
- GPT-4 的切法(cl100k_base):101 個 token。很多中文字被拆成兩三段,同一封信多了將近五成。
更多中文文件的切法對照放在 AI 的 token 是什麼。token 直接關係到費用和上限。
- 費用:API(讓公司系統直接呼叫模型的連接方式)通常按輸入與輸出的 token 數計價。輸出比輸入貴,常見是好幾倍。
- 上限:每個模型一次能處理的 token 數有上限,稱為上下文長度(context window)。
所以要估成本,我建議拿真正會送進去的東西,例如一封詢價信加上報價單,用官方的 token 計算工具算一次,這會比套公式可靠。
一次預測一個 token
訓練的時候,模型會反覆調整參數,直到它能根據前面的 token,正確預測出下一個 token(AWS)。回信時也一樣。它看著詢價信和「請幫我擬一封回信」這句話,先猜回信開頭最可能的 token,例如「您好」。接上去之後再猜下一個,一路接到回信結束。
讓它能看懂一長段文字的,是 Transformer 架構,由 Google 研究團隊在 2017 年的論文〈Attention Is All You Need〉提出。它讓模型在處理每個字時,會回頭去看前面所有字跟它的關係。所以模型讀到「單價可以再談嗎」時,會把它和前面的「800 件」連起來,知道客戶是想用數量換價格。
但「上次那批」到底是哪一批,它只看得到這封信,並不知道。要回答這個,得去查出貨紀錄,這就是 RAG 要做的事。
預訓練之後,還要教它聽指令
如果模型只會預測下一個 token,你把詢價信貼給它、請它擬回信,它可能會接著寫出另一封詢價信,因為網路上的文字常常是這樣接下去的。所以要讓它變成能對話、能照指示做事的助手,還要再訓練幾輪。OpenAI 在 2022 年發表的 InstructGPT 論文,是這一步的代表做法:
| 階段 | 在做什麼 | 效果 |
|---|---|---|
| 預訓練 | 用大量文字學會預測下一個 token | 學會語言、常識和大量知識 |
| 指令微調 | 用人寫的「指令+理想回答」範例再訓練 | 學會照指令回答 |
| 人類回饋強化學習(RLHF) | 請人替多個回答排序,讓模型往較好的方向調整 | 回答更有幫助,較少捏造與有害內容 |
論文拿經過這兩步調整、只有 13 億參數的模型,和 1,750 億參數、沒有調整過的 GPT-3 相比。評分的人反而比較喜歡小模型的回答(Ouyang et al.(2022))。所以模型好不好用,除了參數多寡,訓練後怎麼調整也有很大的影響。
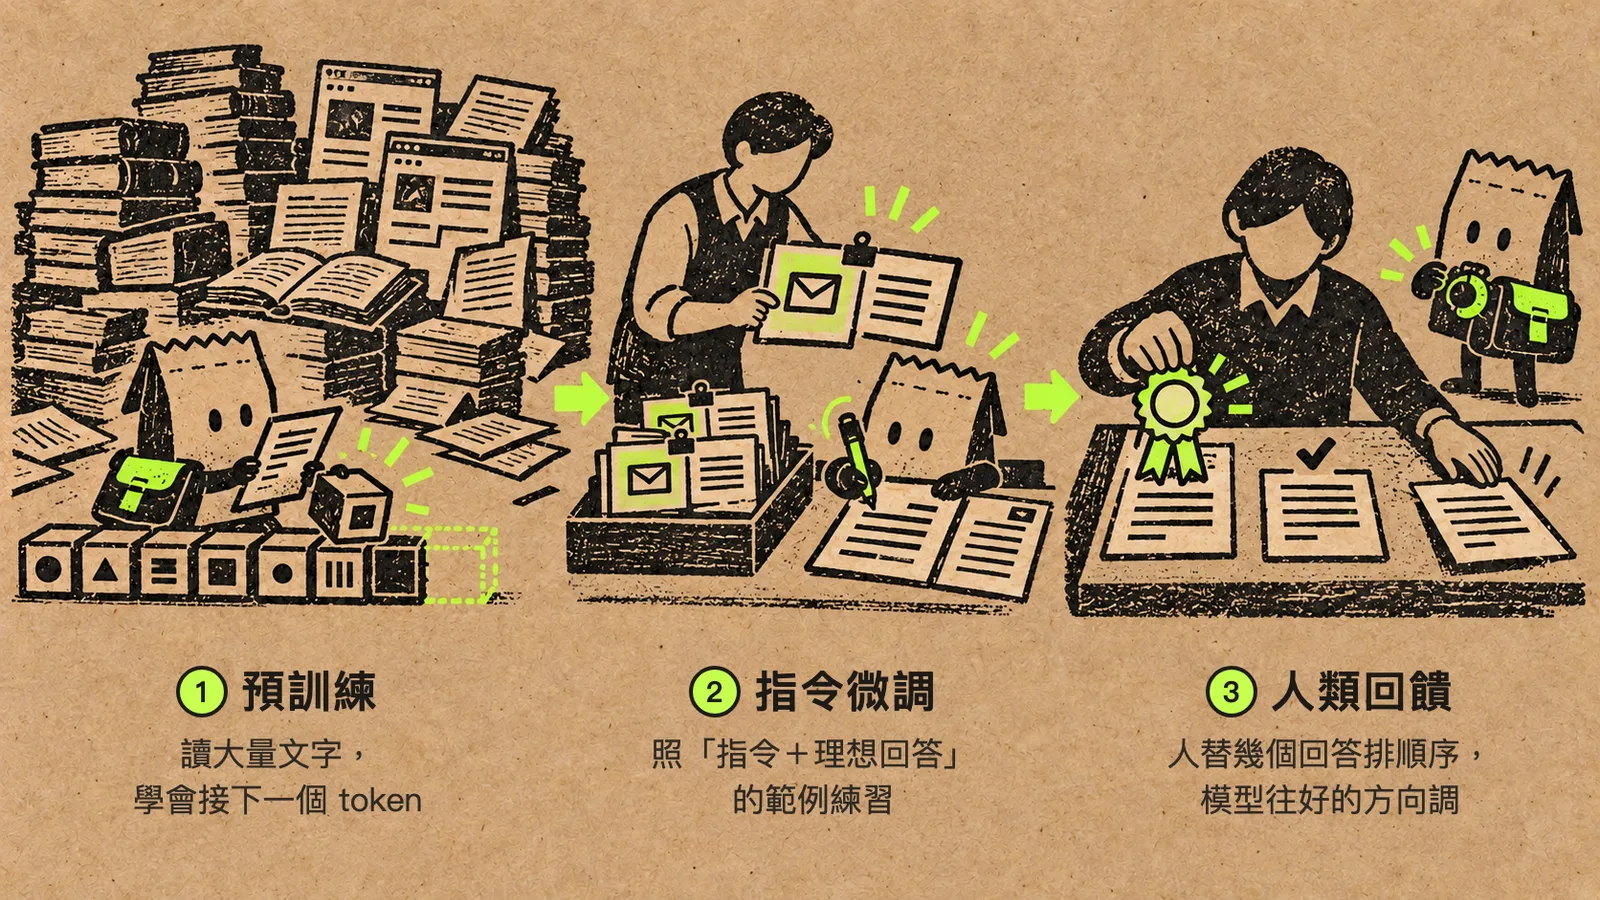 第一段讓模型學會語言,後兩段才教它聽懂指令、回答得有幫助。
LLM 能做什麼、會在哪裡出錯
LLM 能做的是「文字進、文字出」的工作,會出錯的多半是它沒看過的事實和數字。
- 擬回信和改寫:把客戶的詢價信貼進去,請它擬一封語氣得體的回信,或把你寫得太硬的句子改順。
- 摘要:把來回十幾封的信件整理成一段。
- 翻譯:把外國客戶的英文詢價信翻成中文。
- 從信裡抓資料:抓出品名(SUS304 法蘭)、數量(800 件)、交期(11 月 20 日前),整理成固定格式填進報價系統。
- 寫程式:寫一段整理出貨表的小程式。
- 查公司文件回答:先查價目表和出貨紀錄再回信,這是 RAG。
但如果你只把那封詢價信貼給它、沒給任何公司資料,它很可能擬出這樣的草稿:
您好,感謝您再次詢價。800 件的單價可調整為每件 NT$185,交期可配合於 11 月 20 日前出貨,報價含稅、不含運費。上次那批的品質我們也會維持同樣的標準。
這封草稿讀起來很順。問題卻藏在三個地方:NT$185 的單價、「上次那批」的品質、11 月 20 日的交期。這三處剛好對應 LLM 最常見的限制,而「補資料進去就好」也有它的限制。
知識停在訓練資料的截止日
模型只知道訓練資料裡有的東西。你們十月才調過的 SUS304 單價,它不會知道。所以 NT$185 這個數字只能照它讀過的行情去猜。
Anthropic 的模型總覽會分開列「可靠知識截止」和「訓練資料截止」兩個日期。前者之前的事,模型知道得最完整可靠,兩個日期之間的就比較零碎(Anthropic:Models overview)。
上下文有上限,塞越多不一定越好
那把價目表補進去就好了嗎?上下文長度是模型一次能讀進去的文字量。你貼的信、附上的文件、先前的對話和模型的回答,全都算在這個額度裡。
Anthropic 也提醒,一次放進去的內容越多,模型越容易漏看或記錯其中的細節(Anthropic:Context windows)。所以如果你把整本產品型錄貼進去,模型反而可能漏看客戶問的那個規格。
與其放得越多越好,不如挑對要放進去的內容。agent 每一步該放哪些資料,可以看 Context Engineering 是什麼。
會流暢地講錯
「上次那批的品質我們也會維持」這句,模型根本不知道上次那批是什麼,卻寫得像真的一樣。這就是一般說的「AI 幻覺」,NIST 的描述是:模型會自信地產出錯誤或虛構的內容(NIST AI 600-1)。客戶若追問「能不能耐 400 度」,型錄裡沒寫,模型也可能流暢地回答「可以」。
它為什麼會這樣、企業可以怎麼降低,我另外寫在 AI 幻覺是什麼。
精確數字和即時資料要交給系統
「11 月 20 日前出貨」是一個承諾,但模型沒看過產線排程。800 件的單價、現貨還剩幾件、交期排不排得進,這類答案要由 ERP 或報價系統算出來。
LLM 負責讀懂客戶要問什麼、交給系統查,再把結果寫成回信。所以要精確的部分交給系統,要理解和表達的部分交給 LLM。
常見的 LLM 模型有哪些
常見的 LLM 有 GPT、Claude、Gemini、Gemma、Llama、Qwen 六個家族。它們的差別在誰開發、能不能下載到自己的機器,以及從哪裡使用。前三個要透過開發公司的產品、API 或雲端平台使用。後三個是開放模型,模型檔案公開,可以下載到自己的機器上跑。
| 模型家族 | 開發公司 | 能下載到自己的機器嗎 | 常見使用入口 |
|---|---|---|---|
| GPT | OpenAI | 不能。OpenAI 另外釋出的 gpt-oss 可以下載 | ChatGPT、OpenAI API |
| Claude | Anthropic | 不能 | Claude 聊天產品(claude.ai)、Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry |
| Gemini | 不能 | Gemini App、Gemini API、Google AI Studio、Google Cloud | |
| Gemma | 能,在 Kaggle 和 Hugging Face 上 | 下載後在自己的硬體上跑,也有託管服務 | |
| Llama | Meta | 能,在 Hugging Face 上同意授權條款後下載。Meta 新一代的 Muse 也有可下載版本 | 下載後在自己的硬體上跑 |
| Qwen | 阿里巴巴的 Qwen 團隊 | 能,在 Hugging Face 和 ModelScope 上 | Qwen Chat 網站、下載後自己跑 |
選型時我建議用自己的測試題比一次。如果詢價信完全不能出公司,就從開放模型裡挑。我們拿同一批信實測 gpt-oss、Gemma、Qwen 的結果,寫在 Ollama 教學。
企業用 LLM 的四種方式
企業用 LLM 有四種方式:商用版聊天產品、API、雲端平台和自架開放模型。同樣是讓 LLM 幫忙回詢價信,用法不同,信件內容會送到哪裡、成本和維運負擔就差很多。
| 方式 | 這封詢價信會去哪 | 適合 | 要注意 |
|---|---|---|---|
| 商用版聊天產品(ChatGPT Business/Enterprise 等) | 你貼進公司帳號的 ChatGPT;OpenAI 寫明這類方案的資料預設不用於訓練 | 員工日常寫作、摘要、查找 | 個人免費版預設可能用於改善模型,公司資料別放個人帳號 |
| API(讓公司系統直接呼叫模型) | 報價系統自動把信送給模型;OpenAI 寫明 API 資料預設不用於訓練,為了檢查違規使用會保留紀錄最多 30 天 | 把 LLM 接進自己的系統或流程 | 要有人寫程式、保管 API 金鑰(系統登入模型用的密碼)、盯用量 |
| 雲端平台(Amazon Bedrock、Google Cloud、Microsoft 的 AI 平台 Foundry) | 公司雲端帳號裡、你選定地區的機房,依雲端合約處理 | 已經在用某家雲端,想統一帳務與權限 | 各平台提供的模型版本與停用時程不同,以平台公告為準 |
| 自架開放模型(如 Gemma) | 留在公司自己的伺服器 | 資料不能離開公司環境、用量大且穩定 | 硬體、更新、效能調校都要自己來 |
員工已經在用免費版,是最常見的風險。個人帳號要到設定裡的「資料控制」關掉「為所有人改善模型」,新的對話才不會被拿去訓練。與其禁止業務把詢價信貼進個人帳號,我會建議直接提供商用版帳號,並講清楚哪些資料不能貼。商用版怎麼選,可以看企業版 AI 助理怎麼選。員工私下用 AI 的風險與規範,可以看 Shadow AI 是什麼。
我的建議順序是:先用商用版聊天產品或 API 把一個流程跑順,確定值得做,再決定要不要換成雲端平台或自架。因為一開始就自架,很容易花好幾個月架環境,卻還沒碰到業務問題。
要不要訓練自己的 LLM
多數中小企業不需要,因為從零開始訓練一個 LLM,要大量的資料、運算資源和專業團隊,幾乎不划算。老闆說「用我們的資料訓練一個回詢價信的 AI」時,想要的通常是下表其中一件事。
| 你真正想要的 | 做法 | 需要重新訓練模型嗎 |
|---|---|---|
| 回信時用上公司的價目表、出貨紀錄、交期規則 | RAG 或把文件直接放進上下文;RAG 怎麼找到意思相近的段落,可以看向量資料庫是什麼 | 不用 |
| 回信的格式、語氣固定 | 先改給 AI 的指令(提示詞),不夠再用公司範例把模型再訓練一輪(微調) | 微調才需要,而且是在既有模型上調整 |
| AI 能查庫存、建立報價單 | agent+系統串接(如 MCP) | 不用 |
| 詢價信完全不能出公司 | 自架開放模型,再搭 RAG | 通常不用,直接用現成的開放模型 |
OpenAI 在談提高準確度的指南裡,也把「模型缺知識」和「模型行為不對」分開處理。缺知識的時候用 RAG 補上相關資料。行為不穩定的時候,才用微調(OpenAI:Optimizing LLM accuracy)。
前面那封草稿的三個問題,沒有一個是重新訓練模型能解決的。單價和上次那批要查資料,交期要查系統。而且單價、規格和交期規則會一直變,所以用查資料的方式接進來,會比訓練進模型好維護。資料要整理到什麼程度才接得上,可以看企業知識庫要整理到什麼程度,AI agent 才用得上。
所以下一次週會,你可以這樣回老闆。不用訓練自己的模型,先用商用版帳號試 30 封真實的詢價信,讓 AI 擬草稿、你改完再寄。兩週試下來,如果你改得最多的是單價和交期,下一步就是讓它先查價目表和出貨紀錄,也就是 RAG。交期則等它能查產線排程,再考慮做成 agent。
導入前先確認的五件事
- 挑一個流程,寫出現在花多少時間。例如「回覆詢價信,每封平均 15 分鐘」。流程怎麼挑,可以看哪些企業流程適合先交給 AI agent。
- 列出會碰到的資料和它們的權限。報價底價、客戶個資、還沒公開的產品計畫,各自能交給哪一種使用方式。
- 準備 20 到 30 封真實的詢價信當測試題。其中要有幾封問到資料裡沒有答案的,看模型會不會老實說不知道。指令的寫法看提示詞怎麼寫,驗收的設計看 AI agent 專案怎麼驗收。
- 決定哪裡要人確認。對外寄出的信、會改到資料的動作,先設成草稿、等人放行。細節在 AI agent 的權限與人工確認怎麼設。
- 用真實文件估一次 token 用量,例如一封詢價信加價目表。把這個用量乘上每天的封數,就能推算一個月的費用區間。
這五件事寫得出來,找平台、找供應商或自己做都比較好談。自建、買平台或委外怎麼選,可以看企業 AI agent 自建、平台或委外。
我們的企業 AI 營運方案會依每個步驟的需要,在 OpenAI、Claude、Gemini 之間配置模型。這樣能兼顧反應速度與成本。
常見問題
常見的 LLM 有哪些?
最常見的是 GPT、Claude、Gemini、Gemma、Llama、Qwen,差別整理在上面的表格。
LLM 會記得我上次跟它說過的話嗎?
模型本身不會。每次回答時,它只看得到這次送進上下文裡的內容,包括這段對話先前的訊息。有些聊天產品另外做了記憶功能,會把你的偏好存下來、下次自動放進上下文,可以在設定裡查看或關閉。
自架開放模型,資料就一定安全嗎?
資料不會送到外部供應商,這點確實比較單純。但誰能存取這台機器、輸出有沒有留紀錄,還是要處理。看不到某份資料的員工,透過模型是不是也看不到,也要確認。所以自架之後,權限和稽核照樣要做。
公司可以只選一家模型嗎?
可以,而且第一個專案我會建議先專心用一家。等流程穩定之後,再依任務分配,例如擬回信用能力強的模型,抓品名和數量用便宜快速的模型。呼叫模型的程式集中在同一處,之後要換或混用都比較容易。
參考來源
以下依官方文件與原始論文整理,資料政策、模型名稱與平台支援範圍以各家官方頁面當下為準。
- AWS:What is LLM (Large Language Model)?
- Google Cloud:Large language models(LLMs)
- OpenAI Help Center:What are tokens and how to count them?
- OpenAI:tiktoken
- Anthropic:Context windows
- Anthropic:Models overview
- Vaswani et al.(2017):Attention Is All You Need
- Ouyang et al.(2022):Training language models to follow instructions with human feedback
- Meta:Muse models
- NIST:AI 600-1 Generative Artificial Intelligence Profile
- OpenAI:Data controls in the OpenAI platform
- OpenAI:Enterprise privacy
- OpenAI Help Center:Data Controls FAQ
- OpenAI:Optimizing LLM accuracy
- Google AI for Developers:Gemma models overview
- OpenAI:gpt-oss(GitHub)
- Meta:Llama(Hugging Face)
- Qwen:Qwen3(GitHub)
- Google AI Studio:Gemini models