假設一家建材行的採購助理,每天要處理十幾張供應商報價單:有的是傳真,有的是業務用手機拍了傳過來,有的是 PDF。她把品名、數量、單價一格一格打進 Excel,再和另外兩家比價。某天她把單價 410 打成 140,差點拿錯的價格去下單,老闆問:「這些單子能不能讓電腦自己讀?」
能讀,只是讀出來的東西和她要的東西還差一大截。OCR 交出的是一整頁文字,她要的是「第三列的單價」。中間差的那一步,就是傳統 OCR 和現在常聽到的 AI OCR 的分界。我們拿三張自己做的虛構單據實際跑了一輪,下面的數字都來自這次測試。
OCR 在做什麼:從一張圖片到一串文字
OCR 是 Optical Character Recognition 的縮寫,中文叫光學字元辨識。AWS 的說明是:把文字的影像轉成機器可讀的文字格式。流程大致分四步:取得影像、前處理(轉正、去雜訊)、辨識文字,最後整理成可以編輯或搜尋的文字檔(AWS:什麼是 OCR)。
辨識的方法也在變。Apple 的 Vision 框架把它分成兩條路:快速模式先找出單一字元,再用小模型認字,接近傳統 OCR。精確模式用神經網路一次找出整串文字和整行,再往下切成詞,Apple 形容這比較像人讀字的方式。
精確模式是預設值,而且所有處理都在使用者的裝置上完成(Apple:Recognizing Text in Images)。
實際跑一次就知道 OCR 交出來的是什麼。我們用 Vision 讀一張清楚的報價單,59 段文字一字沒錯。順序卻是一欄一欄排的:先是項次和品名,再來整欄規格,接著才是整欄數量。「120」屬於哪一個品項,要靠每段字的位置推回去。OCR 交出的是文字和位置,欄位要另外整理,選工具時要先想清楚這一步由誰來做。
傳統 OCR、文件 AI 和視覺模型差在哪
市面上說的 AI OCR,多半指下表的後兩種。三類工具的差別在交出來的東西:
| 類型 | 代表工具 | 交出什麼 | 擅長 | 要注意 |
|---|---|---|---|---|
| 傳統 OCR | Tesseract、作業系統內建的文字辨識 | 整頁文字,加上每段字的位置 | 清楚的印刷文字、讓掃描檔可以搜尋 | 表格、傾斜、翻拍容易漏字;欄位要自己整理 |
| 文件 AI | Google Document AI、Azure Document Intelligence、Amazon Textract | 文字、表格結構、鍵值對;發票與收據可直接給欄位 | 量大、格式固定的單據 | 文件要上傳到雲端;Amazon Textract 目前不讀中文,繁中單據先用自己的樣本試 |
| 視覺語言模型 | 能讀圖的 LLM,例如本機跑的 gemma4、qwen3.5 | 依你給的格式直接輸出欄位 | 各家格式不同、版面雜亂的單據 | 看不清楚時,可能編出看似合理的值 |
雲端服務的分法可以對照官方文件。Google 的 Vision API 有兩種文字偵測:一般圖片用的 TEXT_DETECTION,以及為密集文字與文件最佳化的 DOCUMENT_TEXT_DETECTION。掃描文件要做表單解析,Google 建議改用 Document AI。
Azure 的 Layout 模型抽出文字、表格與文件結構,發票、收據有現成模型直接給欄位,格式固定的自家表單還能訓練自訂模型。Amazon Textract 會保留表格的行列關係、抓鍵值對,並對每個辨識結果給信心分數;不過它目前只支援英文和五種歐洲語言,中文單據讀不了。
我們拿三張單據實測:讀對幾個欄位
2026 年 10 月 11 日,我們在一台 Apple M4 Pro、24 GB 記憶體的 Mac 上,用三張自己畫的虛構單據測了六種做法。第一張是清楚的電子報價單,要讀 20 個欄位:單號、日期、有效期限、廠商、五個品項的品名數量單價,以及總計。第二張是同一張報價單模擬手機翻拍:傾斜、有陰影、有點模糊,紅色印章正好蓋在總計上。第三張是字很淡的收據,要讀 12 個欄位。
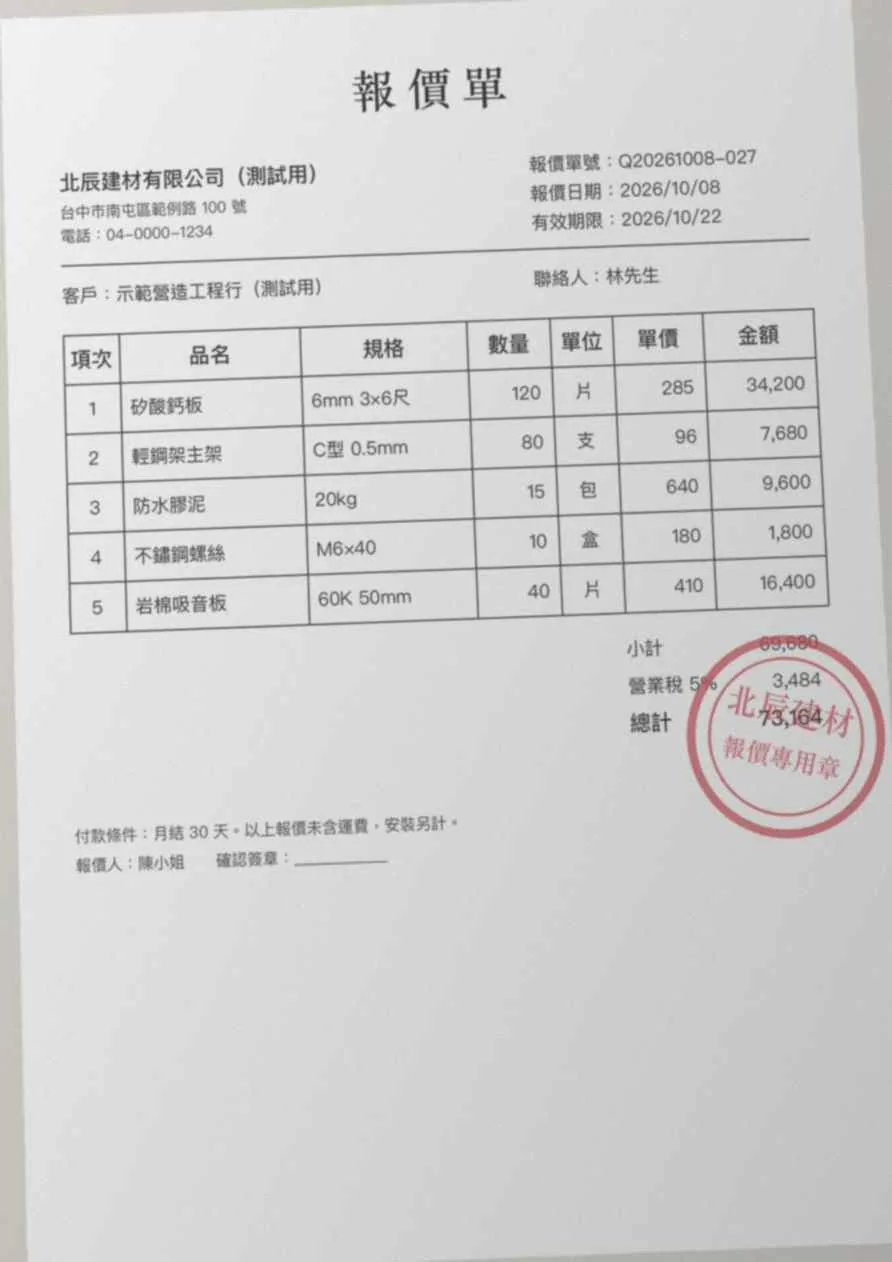 第二張測試單據。公司、品項與電話都是虛構的,印章刻意蓋在總計上。
六種做法分三組:只做 OCR 的 Tesseract 5.5.1 和 Apple Vision;把 Vision 讀出的文字交給本機模型 gemma4:12b 或 qwen3.5:9b 整理成欄位;讓這兩個模型直接看圖填欄位。模型都用 Ollama 在本機跑,溫度設 0;翻拍那張每種做法重跑三次,結果完全一樣。只做 OCR 的兩種,算的是欄位值有沒有一字不差被讀出來。交給模型的四種,算的是值有沒有填進正確的欄位,留空和填錯分開記。
| 做法 | 清楚報價單(20 欄) | 翻拍加印章(20 欄) | 收據(12 欄) | 每張耗時 |
|---|---|---|---|---|
| Tesseract 5.5.1 | 20 | 4 | 11 | 1 秒內 |
| Apple Vision | 20 | 19 | 12 | 1 秒內 |
| Vision → gemma4:12b | 20 | 10(10 個填錯) | 12 | 19–38 秒 |
| Vision → qwen3.5:9b | 9(11 個留空) | 9(11 個留空) | 12 | 7–14 秒 |
| gemma4:12b 直接看圖 | 20 | 17(3 個填錯) | 11(1 個填錯) | 8–26 秒 |
| qwen3.5:9b 直接看圖 | 20 | 20 | 12 | 7–27 秒 |
模型的耗時包含第一張載入模型的時間;兩個模型的授權都是 Apache 2.0,可以商用。
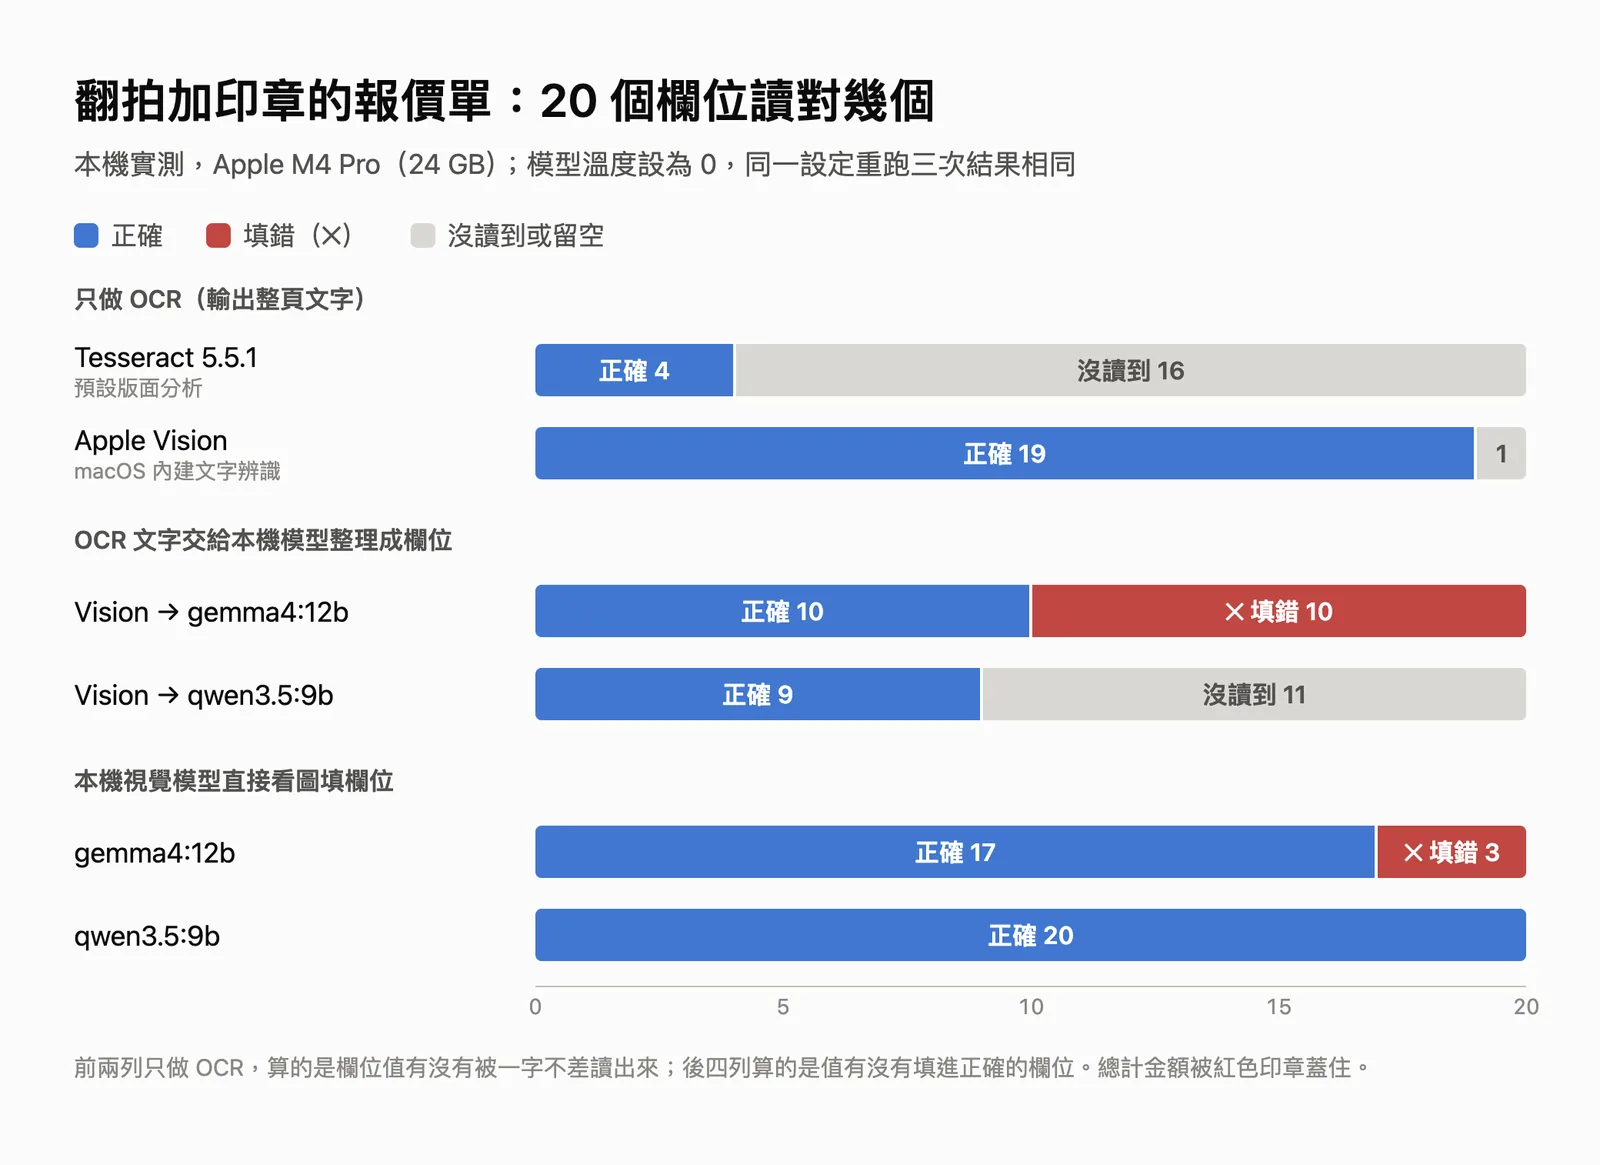 第二張測試單據的結果。前兩列只做 OCR,後四列看欄位有沒有填對。
清楚的單據,大家都讀得對。唯一的例外是 Vision 文字交給 qwen3.5 整理:它沒讀錯任何字,問題出在 Vision 的文字是一欄一欄排的,它拼不回表格,乾脆把數量和單價全部留空。
翻拍加印章,差距一下子拉開。Tesseract 的預設版面分析整張表格都沒讀出來,只剩表頭 4 個欄位。Vision 讀出了除總計以外的每個值,被印章蓋住的 73,164 沒抓到,還把「報價單號」讀成「報價單覽」。換成 Tesseract 的另一種版面模式,收據的每一行都對齊了,報價單的表格卻整張不見。傳統 OCR 要依文件類型調設定,就是這個意思。
最需要提防的是填錯。gemma4 直接看圖時,把蓋在印章下的總計填成 69,000,把「防水膠泥」寫成「防水水泥」,單號多了一個 0。收據上的「水泥釘」則被讀成「水泥泥」。Vision 文字交給 gemma4 時,五個品項的數量和單價整排錯位,總計還抓成了稅額 3,484。這就是 AI 幻覺 出現在單據上的樣子:值看起來都很合理,只是不對。留空的欄位會被人補上,填錯的欄位會一路流進比價表和訂單。
同一張翻拍單,qwen3.5 直接看圖 20 個欄位全對,連印章下的總計都讀出來了。三張單據、一台電腦、一組設定,只能看出差異的方向;換成你們自己的單據,排名可能不一樣,導入前一定要用自己的單據測一輪。
錯誤要在哪一關擋下來
單據上的數字彼此有關係,這是最便宜的檢查。以第二張報價單為例:
- 數量 × 單價 = 金額:矽酸鈣板 120 × 285 = 34,200。錯位的版本把輕鋼架主架填成數量 285、單價 7,680,一乘就知道不對。
- 小計 × 1.05 = 總計:69,680 × 1.05 = 73,164。被填成 69,000 或 3,484 的總計,都過不了這一關。
- 單號格式:這家廠商的單號是 Q 加 8 碼日期再加 3 碼序號,多一個 0 的單號長度就不對。
- 品名對照料號表:「防水水泥」「水泥泥」不在採購品項清單裡,直接標出來。
如果擷取時連金額與小計一起抓,這次測試出現的 14 個填錯,用這四條規則都抓得出來。先讓規則擋掉一批錯,人只看過不了規則的欄位,而且連同原圖那一塊一起看。Vision 和 Textract 都會給每段文字信心分數,分數低的也可以一併送審。
企業文件怎麼選:先看文件,再看工具
選工具之前,先把手上的單據分類:
| 文件情況 | 建議做法 | 原因 |
|---|---|---|
| 電子發票 | 讀證明聯上的 QR Code,或向會計確認能否從電子發票平台取得資料 | 資料本來就是數位的,拍照辨識是多繞一圈 |
| 系統產生的 PDF(可以選取文字) | 直接取文字 | 字本來就在檔案裡,不必 OCR |
| 清楚的掃描檔、格式固定 | 傳統 OCR 加規則,或文件 AI 的現成模型 | 快、便宜,結果穩定 |
| 翻拍照片、蓋章、各家格式不同 | 文件 AI 或視覺模型,加上驗算規則 | 傳統 OCR 容易整張表漏掉 |
| 報價、合約、個資等機密文件 | 先評估本機方案;用雲端前讀過資料處理說明 | 雲端服務會把文件傳到供應商的伺服器 |
台灣的電子發票證明聯上有兩個 QR Code。依財政部的條碼規格,裡面記載發票字軌號碼、開立日期、隨機碼、銷售額、總計額、買賣方統編,以及品名、數量、單價等品目資料(電子發票證明聯條碼規格)。收到的是電子發票,拍照做 OCR 應該排在最後。
資料放在哪也要先想。雲端的文件 AI 會把文件送到供應商那邊處理,存放區域與保存期間要看各家的服務條款。想留在公司內部,有三種選擇。Apple 的 Vision 框架在裝置上處理;Tesseract 是開源軟體,可以裝在自己的電腦;能讀圖的模型可以用 Ollama 在本機跑,這次測試就是這樣做的。
只是偶爾要把一張圖轉成文字,Google 雲端硬碟就做得到:在檔案上按右鍵,用 Google 文件開啟,圖片或 PDF 會轉成可編輯的文字。官方說明檔案要在 2 MB 以內、文字高度至少 10 像素,表格和多欄排版可能不會保留(Google 雲端硬碟說明)。
從哪一段開始做
OCR 很少單獨存在。讀出來的資料要進 Excel、ERP 或比價表,後面通常還接著一段自動化:有 API 的系統用流程串接,沒有 API 的舊系統可能要靠 RPA 代為輸入。
要挑第一個試做的流程,可以用哪些企業流程適合先交給 AI agent 的條件篩一次;如果讀出來的文件要放進知識庫給 AI 查,掃描檔怎麼處理,企業知識庫要整理到什麼程度有一節專門在講。
我們的企業 AI 營運方案會先到現場看單據實際長什麼樣:從哪裡進來、誰在核對、錯了誰會發現。接著整合 ERP、內部單據與庫存資料,比對發票、採購單與物料數據。
資料異常或高風險的判斷設計成先暫停、交由專人確認再放行,例如總計對不上、品名不在料號表裡。哪些情況要停下來,上線前和負責的主管一起訂好。
常見問題
OCR 可以辨識手寫字嗎?
有些服務可以,但要先看支援哪些語言。例如 Amazon Textract 能讀手寫,目前只限英文。中文手寫的筆跡差異很大,我們這次沒有測手寫,建議拿二三十張實際的手寫單據試過再決定,並把手寫欄位都列入人工確認。
OCR 線上可以辨識文字嗎?
可以。免費的有 Google 雲端硬碟的轉換功能,要整合進系統的有 Google Cloud、Azure、AWS 的付費 OCR 服務。線上服務的共同點是檔案會上傳到別人的伺服器,報價單、身分證件這類資料,用之前先確認對方怎麼保存。
掃描檔要多少解析度才夠?
Tesseract 官方建議至少 300 dpi,Google 雲端硬碟要求文字高度至少 10 像素。傾斜的頁面先轉正再辨識,Tesseract 的文件也把轉正列為改善品質的做法之一。
AI OCR 會不會把看不清楚的字直接猜出來?
會。我們在提示裡寫了「看不清楚就填空白」,gemma4 還是替被印章蓋住的總計填了一個數字。提示詞只能降低這種情況,金額、數量這類欄位,要靠驗算規則或人工確認把關。
參考來源
以下依官方文件整理,各服務的功能、支援語言與檔案限制以官方頁面當下為準。
- AWS:什麼是 OCR(光學字元辨識)?
- Apple Developer:Recognizing Text in Images
- Tesseract:Improving the quality of the output
- Google Cloud:Detect text in images(Vision API)
- Microsoft Learn:What is Azure Document Intelligence?
- AWS:Amazon Textract features
- AWS:Amazon Textract FAQs
- Google 雲端硬碟說明:將 PDF 和相片檔轉換成文字
- 財政部電子發票整合服務平台:電子發票證明聯一維及二維條碼規格說明
- Ollama:Vision
- Ollama:Structured outputs