你們公司用 React 做了一個「雲端報價系統」的產品頁。你在瀏覽器打開時,標題、三個方案的價格表、功能比較和 FAQ 都很完整,看起來沒有任何問題。可是有客戶打電話來問,他在 ChatGPT 問你們的報價系統一個月多少錢,回答說查不到官方價格,反而列了一個比較網站上的舊價格。
你回到產品頁,按右鍵選「檢視網頁原始碼」,或者用 curl 把它抓下來看,結果只有一行 <div id="root"></div>,價格表和 FAQ 一個字都沒有。也就是說,你看到的畫面,是瀏覽器執行完 JavaScript 之後才組出來的,而伺服器一開始送出去的那份 HTML 幾乎是空的。讀者看到的畫面,和爬蟲拿到的第一份文件,可能是兩份不一樣的東西。
這件事對 Google 和對 AI 爬蟲的影響也不太一樣。Google 會把頁面排進渲染流程,執行它處理得了的 JavaScript,再拿渲染後的結果去建立索引;而 OpenAI、Anthropic 和 Perplexity 公開的爬蟲說明頁,都只寫了各個爬蟲的用途和怎麼用 robots.txt 控制,沒有寫它們會不會執行 JavaScript。所以我的做法是先把其他 AI 爬蟲當作不會執行 JavaScript,重要的內容一定放進初始 HTML。
伺服器送出去的 HTML,就像一箱組合家具
- 箱子裡是零件和說明書:伺服器送出的初始 HTML 就是那個箱子,裡面的 JavaScript 是組裝說明,頁面還沒有組起來。
- 你的瀏覽器會自己動手組:所以你打開產品頁時,看到的是已經組好的書櫃,也就是渲染後的畫面。
- Google 會組,但要排隊:Google 會把頁面排進渲染流程,輪到了才照說明書組起來,再拿組好的樣子去建立索引。
- 其他 AI 爬蟲沒說會不會組:它們的公開文件沒寫會不會執行 JavaScript,所以要先當作它們只看得到箱子裡現成的東西。
- SSR 就是出貨前先組好:伺服器先把頁面組成完整的 HTML 再送出去,不管誰打開箱子,看到的都是組好的書櫃。
想讓每個爬蟲都看得到價格表,就把價格表直接放進箱子裡,也就是放進初始 HTML。這個比喻不成立的地方是:組合家具的零件一定都在箱子裡,而網頁的部分內容還要另外去 API 拿,只要那支 API 被擋,就算是 Google 也組不出完整的頁面。
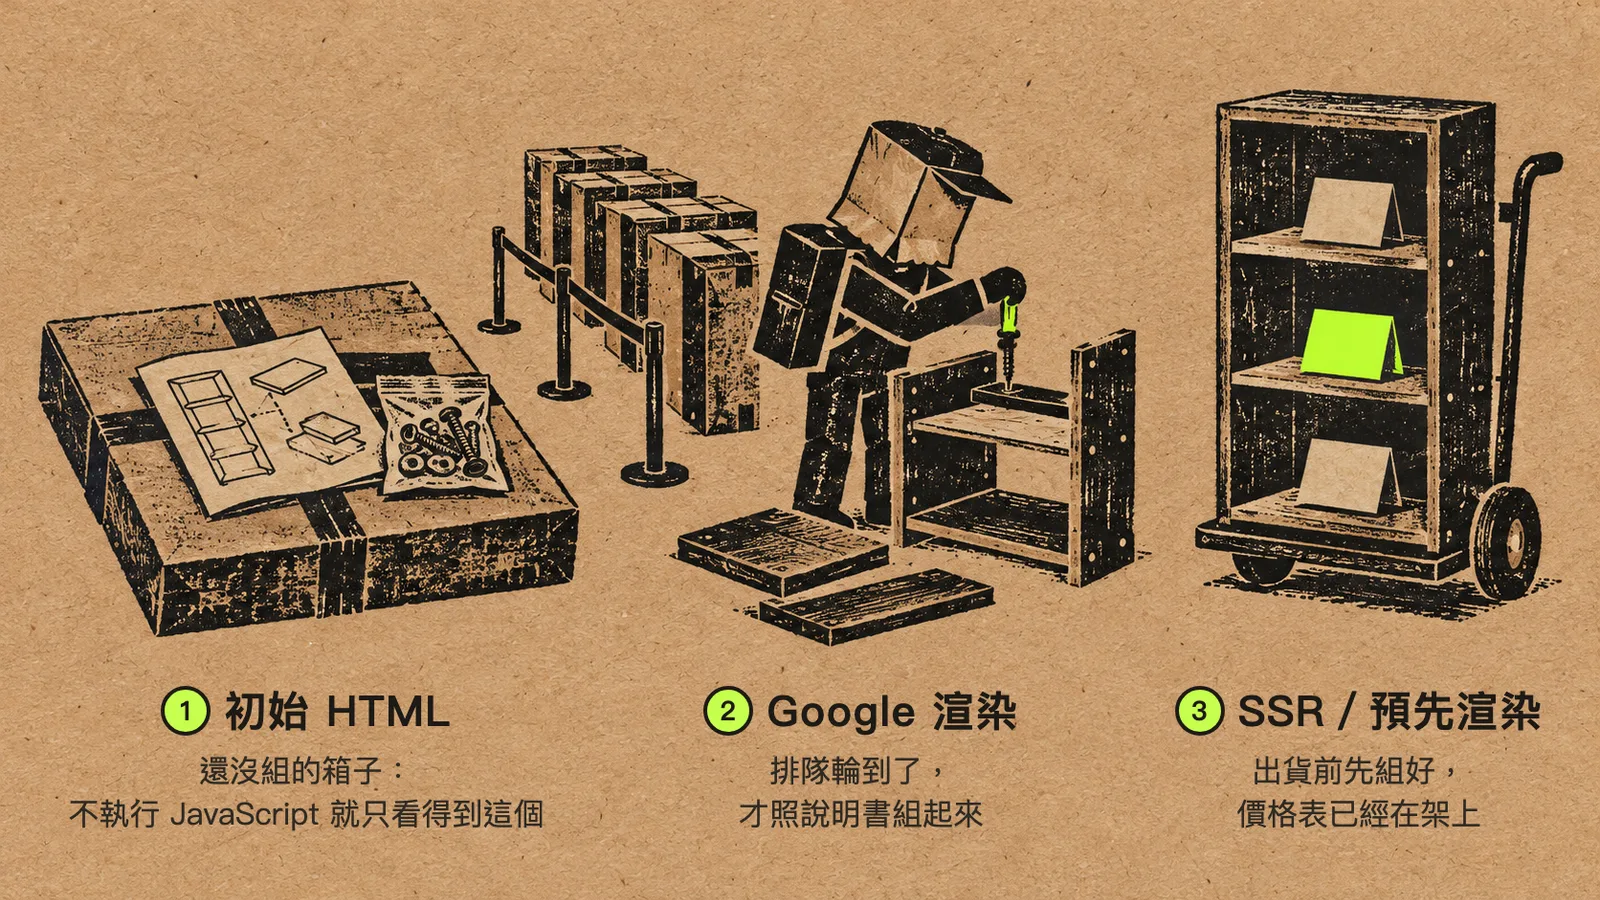 同一套書櫃的三種到貨方式:只送箱子、等 Google 排隊組好,或出貨前先組好,價格表一開箱就在架上。
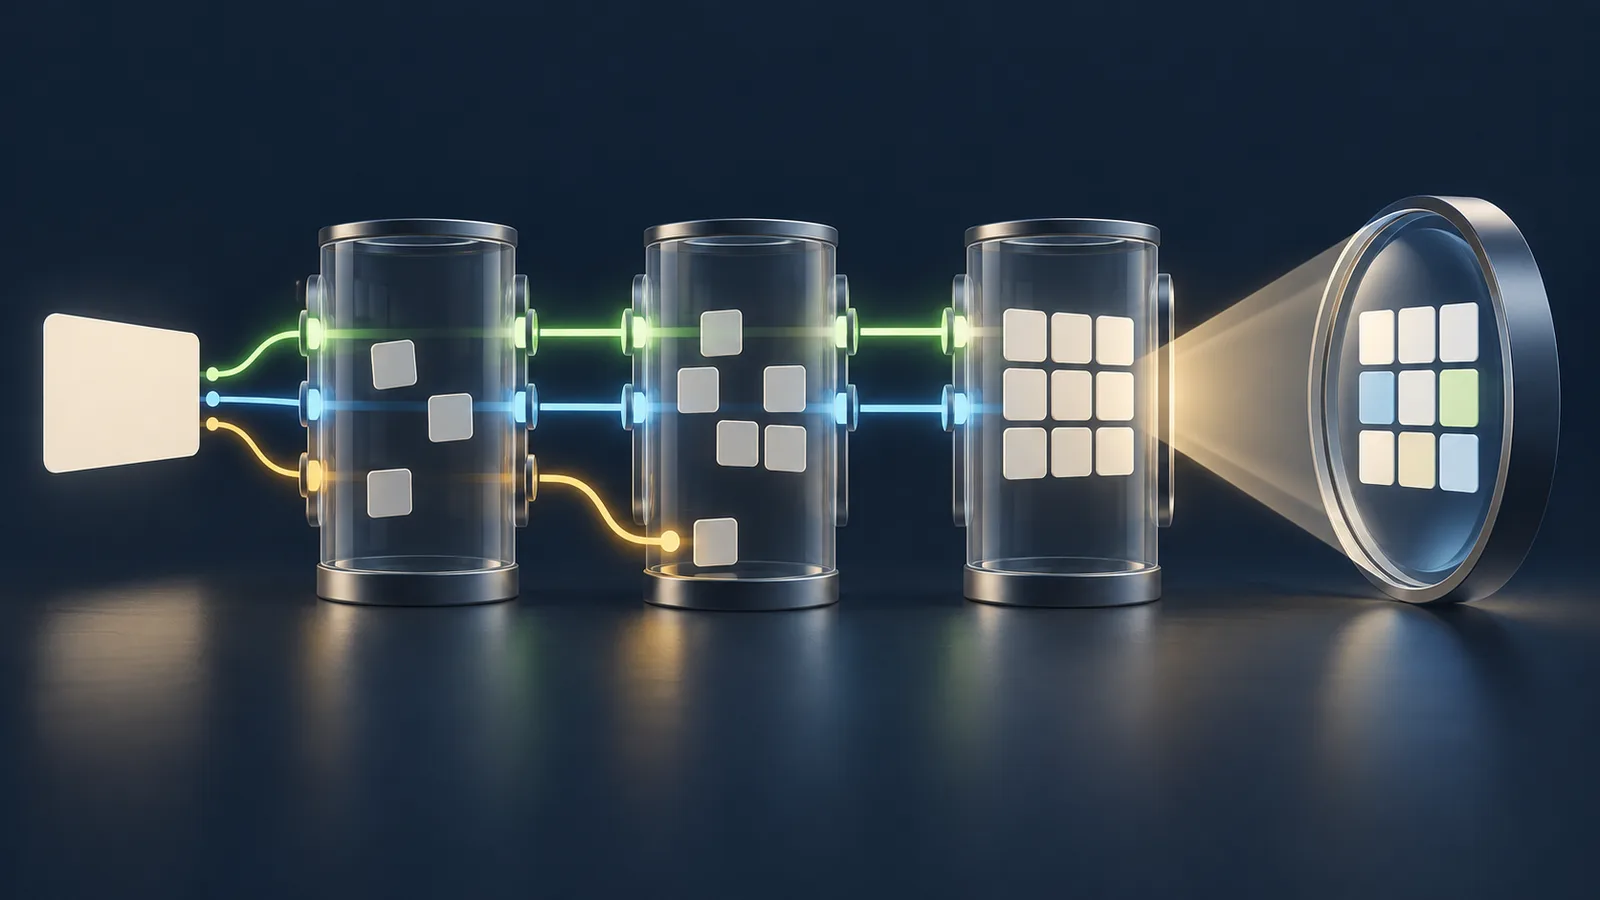 Google 會不會渲染、其他爬蟲拿到什麼,以及 AI 回答有沒有用到你的頁面,要分開確認。
先分清楚三件要分開看的事
同一個網址,有三件事要分開看:
- 初始 HTML:伺服器一開始回傳的原始內容,還沒有執行任何 JavaScript,也就是組合家具的箱子。
- 渲染後的 DOM:瀏覽器或 Google 執行完 JavaScript 之後,實際組出來的頁面結構,畫面上的每個標題、表格和按鈕都在裡面。
- AI 回答:某一天、某個問題問下去之後,AI 有沒有用到這一頁。
| 狀態 | 用什麼看 | 報價系統產品頁要查什麼 |
|---|---|---|
| 初始 HTML | 瀏覽器「檢視網頁原始碼」、curl | 狀態碼、title、H1、方案價格、FAQ 文字、連結、canonical |
| 渲染後 DOM | 開發者工具的 Elements 面板、Search Console 網址檢查、複合式搜尋結果測試 | JavaScript 跑完後價格表還在不在、console 錯誤、失敗的網路請求 |
| AI 回答 | 用固定的問題實際去問各個 AI 平台 | 哪個平台、哪個問題、哪一天、引用了哪個網址 |
瀏覽器截圖只能證明畫面長怎樣,它看不出初始 HTML 裡有沒有價格表,也看不出 AI 有沒有用到這一頁。如果你只檢查第二種狀態,就看不出爬蟲沒執行 JavaScript 時拿到的是一個空頁;只檢查第一種,又會漏掉渲染之後才出現的錯誤或重複內容。而第三種狀態要另外用固定的問題去問,前兩種檢查都推不出 AI 會不會引用。
Google 的抓取、渲染、索引流程
Google 的 JavaScript SEO 基本知識把處理流程分成三個階段:先檢索網址,再把頁面排進渲染佇列,等輪到它的時候用瀏覽器執行 JavaScript,最後拿渲染後的 HTML 去建立索引。文件裡也寫到,頁面在渲染佇列裡可能只待幾秒,但也可能更久。所以報價系統產品頁如果全靠 JavaScript 產生內容,Google 要等渲染完才看得到價格表;而在這之前,伺服器回應的狀態碼、JavaScript 檔案和資料 API 能不能載入、robots.txt 有沒有擋住這些資源,都會影響最後的結果。
Google 在同一份文件裡也建議,伺服器端渲染或預先渲染還是很值得做,因為它能讓網站對使用者和爬蟲都更快,而且並非所有的爬蟲都能執行 JavaScript。另外有三條也跟報價系統直接有關:
- canonical 直接寫在 HTML 裡:canonical 是寫在頁面裡、告訴搜尋引擎哪個網址才是正式版本的標記,Google 建議不要用 JavaScript 把它改成別的網址,細節在 canonical 與 AI 引用。
- 連結要用
<a href>:Google 只會沿著有href屬性的<a>元素去找連結,用按鈕加 JavaScript 跳頁的連結,它找不到。 - 初始 HTML 不要放 noindex:初始 HTML 裡如果有 noindex,Google 可能會直接跳過渲染,之後再用 JavaScript 拿掉也沒用。
這份文件講的只有 Google。OpenAI、Anthropic、Perplexity 會不會用同樣的方式渲染,從 Google 的文件推不出來,而這三家的爬蟲說明頁(OpenAI、Anthropic、Perplexity)目前也都沒有寫到 JavaScript。所以在拿到各家的說明之前,我會建議你把它們當作只讀得到初始 HTML。
初始 HTML 應該先放什麼
對內容頁來說,初始 HTML 要先放讀者最需要、爬蟲也最容易拿到的資訊。以報價系統產品頁為例:
- 一個清楚的 H1、title 和描述,而且和頁面主題一致,例如 H1 就寫「雲端報價系統:方案與價格」。
- 開頭直接回答主要問題,例如三個方案各多少錢、適合幾個人的團隊;不要讓答案等到使用者點擊、或 JavaScript 跑完之後才出現。
- 看得到的文字裡,要寫出每個方案包含的功能、人數上限、月繳或年繳,以及必要的說明連結。
- 用
<a href>寫的內部連結,指向上層頁面、同主題文章和服務頁,做法可以看內部連結與 AI 引用。 - canonical、robots 指令和必要的結構化資料,而且內容要和頁面上看得到的文字一致。
- 圖片要有 alt 和文字說明,不要把關鍵的價格或規格只放在圖片或 canvas 裡。
互動篩選、即時資料和登入後的操作,可以留給 JavaScript 處理;但公開的價格、規格和 FAQ,要有一份不用執行 JavaScript 就讀得到的文字版本。
SSR、prerender 與 hydration 如何分工
這三個詞常常一起出現,先各用一句話講清楚:SSR(伺服器端渲染)是每次有人請求時,伺服器先把內容組成完整的 HTML 再送出去;prerender(預先渲染)是在建置或部署的時候,就先把每一頁產生成靜態的 HTML 檔;hydration 則是頁面送到瀏覽器之後,JavaScript 再接手這份已經有內容的 HTML,把按鈕、篩選這些互動功能接上去。
用組合家具來說,SSR 和預先渲染都是「出貨前先組好」,差別只在於是每次有人訂貨時才組,還是先組好一批放在倉庫。所以報價系統產品頁如果改用 SSR 或預先渲染,伺服器送出去的 HTML 裡就已經有價格表和 FAQ;hydration 則像書櫃組好之後再裝上抽屜滑軌,書櫃本來就在那裡,JavaScript 只負責讓方案切換的按鈕可以按。
兩種要選哪一種,我會看內容多常變、是不是每個人看到的都一樣。公開價格每個人看到的都相同、一季才調一次,用預先渲染就夠了,改價時重新建置一次;如果價格會因帳號、地區或庫存而不同,或是每天都在變,就用 SSR。不管選哪一種,這類架構通常比較容易對照初始 HTML 和渲染後的 DOM。不過檢查時要看伺服器實際回傳了什麼,因為框架名稱說明不了部署後的結果,例如同一套程式在開發環境有 SSR,部署到正式環境時,卻可能因為設定不同又退回只在瀏覽器端產生。
| 架構狀態 | 需要確認 | 風險訊號 |
|---|---|---|
| SSR | 伺服器回應已經含有主要文字與連結 | 正式環境和開發環境的輸出不同 |
| 預先渲染 | 靜態 HTML 有沒有在改版時一起更新 | 價格或日期比正式資料舊 |
| hydration | JavaScript 執行後,文字與連結有沒有保留 | hydration 出錯、內容閃一下或被清空 |
| 只在瀏覽器端產生 | 初始 HTML 幾乎沒有答案 | 一打開就看到的內容全靠 JavaScript 產生,不執行 JavaScript 的爬蟲拿不到 |
| 延遲載入 | 內容要捲動、點擊或等一段時間才載入 | 爬蟲通常不會捲動或點擊,內容可能看不到 |
做技術選擇時,要把讀者體驗、Google 的渲染、其他 AI 爬蟲,以及正式環境實際的回應分開評估,因為其中一項通過了,其他幾項還是要各自確認。
五個常見失敗點
1. 頁面回應 200,卻沒有主要文字
HTTP 200 只代表伺服器回應成功。如果報價系統產品頁回傳的只是一個「載入中」的空殼,或出錯時顯示的備用畫面,爬蟲還是拿不到價格表。這種情況在單頁應用特別常見,也就是整個網站只有一個 HTML、切換頁面都交給 JavaScript 處理的架構:連找不到的產品網址也回 200,Google 就可能把它當成軟性 404,也就是內容看起來像錯誤頁、狀態碼卻回成功。同一份 JavaScript SEO 文件建議,這種頁面要回有意義的狀態碼,例如找不到就回 404。
2. robots 或網站防火牆(WAF)擋住腳本與 API
頁面本身可能回 200,但負責載入價格的 JavaScript、CSS 或資料 API 卻收到 403、429,或是被瀏覽器的跨網域限制(CORS)擋下。這時候你可以打開開發者工具的 Network 面板、伺服器 log 和網站防火牆的紀錄,確認價格表是不是靠一支被擋住的 API 才出現。robots.txt 也一樣,如果它擋住了 /static/js/ 或 /api/ 這類路徑,Google 就沒辦法用那些資源去渲染頁面。
3. 渲染後內容和原始內容互相矛盾
如果初始 HTML 裡的 title、canonical 或價格,和渲染後的不一樣,Google 就要自己判斷哪一個才對,例如初始 HTML 寫「每月 990 元」,JavaScript 跑完之後卻變成「每月 1,290 元」。canonical 尤其要注意,Google 建議直接寫在 HTML 裡,不要用 JavaScript 改成別的網址。結構化資料也要和頁面上看得到的內容一致,只存在腳本裡、讀者看不到的價格,不能拿來當作頁面上的說法。
4. 只測一般瀏覽器
你自己的瀏覽器有完整的 JavaScript、cookie、地區設定和登入狀態,而爬蟲的請求環境可能完全不同。所以至少要做三種檢查:不帶 cookie、換成爬蟲的 user-agent,以及看不執行 JavaScript 時的初始 HTML,並且把正式環境和本機測試的結果分開記錄。
5. 把渲染成功誤當成 AI 會引用
Google 的工具看得到報價系統的價格表,只代表 Google 渲染得出來,AI 產品還是可能不用這一頁。要知道 AI 有沒有引用,得用固定的問題實際去問,並記下是哪個平台、哪一天、問了什麼,以及引用了哪個網址。
單頁檢查步驟
照下面這個順序,把報價系統產品頁從初始 HTML 一路查到 AI 回答。
1. 用瀏覽器「檢視網頁原始碼」
在 Chrome 打開產品頁,按右鍵選「檢視網頁原始碼」,看到的就是伺服器一開始回傳的 HTML,還沒有執行 JavaScript。用 Ctrl+F(Mac 是 ⌘+F)搜尋 H1 的文字和某個方案的價格,例如「990」。搜得到,代表內容已經在初始 HTML 裡;如果只看到 <div id="root"></div> 和一堆 <script>,就代表內容要等 JavaScript 跑完才會出現。要注意的是,按右鍵選「檢查」打開的開發者工具,顯示的是渲染後的 DOM,兩者不要搞混。
2. 用 curl 抓初始 HTML
如果要留下紀錄,或一次檢查很多頁,可以改用 curl:
curl -sL -o quote-page.html -w "%{http_code}\n" https://example.com/products/quote
grep -c "990" quote-page.html
第一行會把初始 HTML 存成檔案,並印出 HTTP 狀態碼;第二行計算價格出現在幾行裡,結果是 0 就代表初始 HTML 裡沒有價格。你也可以加上 -A 換成某個爬蟲的 user-agent 字串再抓一次(各家的字串在它們的爬蟲說明頁都有列),看看網站防火牆有沒有回給爬蟲不一樣的內容。不過有些防火牆會比對來源 IP,所以用自己的電腦換 user-agent,不一定重現得了爬蟲實際遇到的狀況。
3. 用 Search Console 網址檢查看 Google 拿到什麼
如果你有這個網站的 Search Console 權限,就在上方的網址檢查輸入產品頁網址。「查看已檢索的網頁」顯示的是 Google 上次檢索時拿到的內容;按「測試線上網址」之後再點「查看已測試的網頁」,可以看到即時測試的 HTML 和渲染後畫面的螢幕截圖,「更多資訊」裡還有載入的網頁資源和 JavaScript 控制台訊息(網址檢查工具說明)。如果截圖裡的價格表是空的,或 HTML 裡搜不到「990」,就代表 Google 渲染時也沒拿到那段內容;而 Google 的 JavaScript 文件也寫到,內容沒有出現在渲染後的 HTML 裡,Google 就沒辦法建立索引。
4. 沒有權限就用複合式搜尋結果測試
如果你要檢查的是別人的網站,或者還沒拿到 Search Console 權限,可以用 Google 的複合式搜尋結果測試。它一樣會渲染頁面,讓你看渲染後的 HTML 和截圖,同時檢查結構化資料有沒有錯誤;Google 的 JavaScript 文件也把它和網址檢查並列為看渲染後 HTML 的方法。
5. 比對初始 HTML 和渲染後的內容
把前面拿到的兩份結果放在一起比:H1、主要答案、方案價格、FAQ、來源連結、canonical、結構化資料和 robots 指令,在初始 HTML 和渲染後是不是都一樣。只在渲染後才出現的內容,就是不執行 JavaScript 的爬蟲讀不到的部分;兩邊寫得不一樣的地方,例如價格不同、canonical 指向不同網址,就要優先修。同時也確認 robots.txt、網站防火牆、CDN 和 API,有沒有對特定爬蟲回傳不同的內容。
6. AI 回答另外用固定問題去問
最後,針對 AI 搜尋,用一組固定的問題實際去問。這組問題不要寫成搜尋關鍵字,而是寫成客戶在挑報價系統時,實際會怎麼問 AI,因為客戶問 AI 時通常會把公司規模和需求一起講出來,回答引用的來源也會跟著不同:
| 關鍵字寫法 | 客戶實際會問 AI 的方式 |
|---|---|
| 雲端報價系統 推薦 | 我們是 15 個人的室內設計公司,每個月要開 80 張報價單,有推薦的雲端報價系統嗎? |
| 報價系統 價格 | 這套雲端報價系統一個月多少錢?10 個人一起用要選哪個方案? |
| 報價系統 比較 | 雲端報價系統跟用 Excel 開報價單比起來,差在哪裡? |
記下每個平台有沒有引用這一頁、引用的是哪個網址,同一組問題隔一段時間再問一次,才看得出改成預先渲染之後有沒有差別。題目要分哪些類型,可以看 AI 搜尋題庫怎麼設計。而用同一組問題定期去問各家 AI、保存回答和引用的網址,就是我們的 Otlex 在做的事。
回到開場那個產品頁。你們的公開價格一季才調一次,所以選了預先渲染:價格表和 FAQ 在建置時就寫進 HTML,改完之後檢視原始碼搜得到「990」,curl 那行 grep -c 也不再是 0。接著用那三題真實問法隔一段時間再問一次,記下回答引用了哪個網址。這時候 AI 讀得到官網上的價格,回答才有機會直接引用它,而不是比較網站上的舊資料;如果還是引用比較網站,問題就不在渲染,而要回頭看內容和其他來源了。
常見問題
JavaScript 內容完全不能被 Google 讀到嗎?
Google 讀得到。它會檢索、渲染再建立索引,處理得了的 JavaScript 都會執行;Google 的生成式 AI 搜尋指南也寫到,只要沒有被擋住,Google 可以處理 JavaScript 裡的內容。會出問題的是回應狀態、資源能不能載入和程式錯誤:同一段程式在你的瀏覽器跑得起來,渲染時卻可能因為一支 API 被擋或逾時,價格表就變成空的。所以重要的內容還是適合直接放在初始 HTML 裡。
SSR 一定會提升 AI 搜尋的引用嗎?
SSR 讓爬蟲在初始 HTML 就拿得到內容,也降低內容只在瀏覽器端產生的風險。但 AI 產品會不會抓、會不會用這一頁,要另外拿固定的問題去各個平台問,才知道結果。
只看渲染後的 DOM 可以嗎?
不夠。渲染後的 DOM 要和初始 HTML、HTTP 狀態碼、網路請求、robots.txt、網站防火牆和 canonical 一起對照,因為你的瀏覽器會把畫面補得很完整,只看畫面的話,爬蟲沒有執行 JavaScript、或爬蟲拿到不同回應的情況,你都看不出來。
回應 200,但內容只是載入中的空殼頁,算抓得到嗎?
HTTP 回應成功了,但內容還沒有。如果主要文字、標題或連結要等互動之後才載入,對不執行 JavaScript 的爬蟲來說,它拿到的就是一個沒有內容的頁面。這種情況就要改成 SSR 或預先渲染,或至少讓主要文字直接出現在初始 HTML 裡。
要如何知道某個 AI 爬蟲會不會執行 JavaScript?
先看那個平台當下的官方說明;OpenAI、Anthropic 和 Perplexity 的爬蟲說明頁目前都沒有寫到 JavaScript。如果你有伺服器 log,可以看那個爬蟲來訪時,有沒有接著請求頁面上的 JavaScript 檔案和 API,有的話才代表它可能有執行。拿到這些證據之前,就把它當作只讀得到初始 HTML。