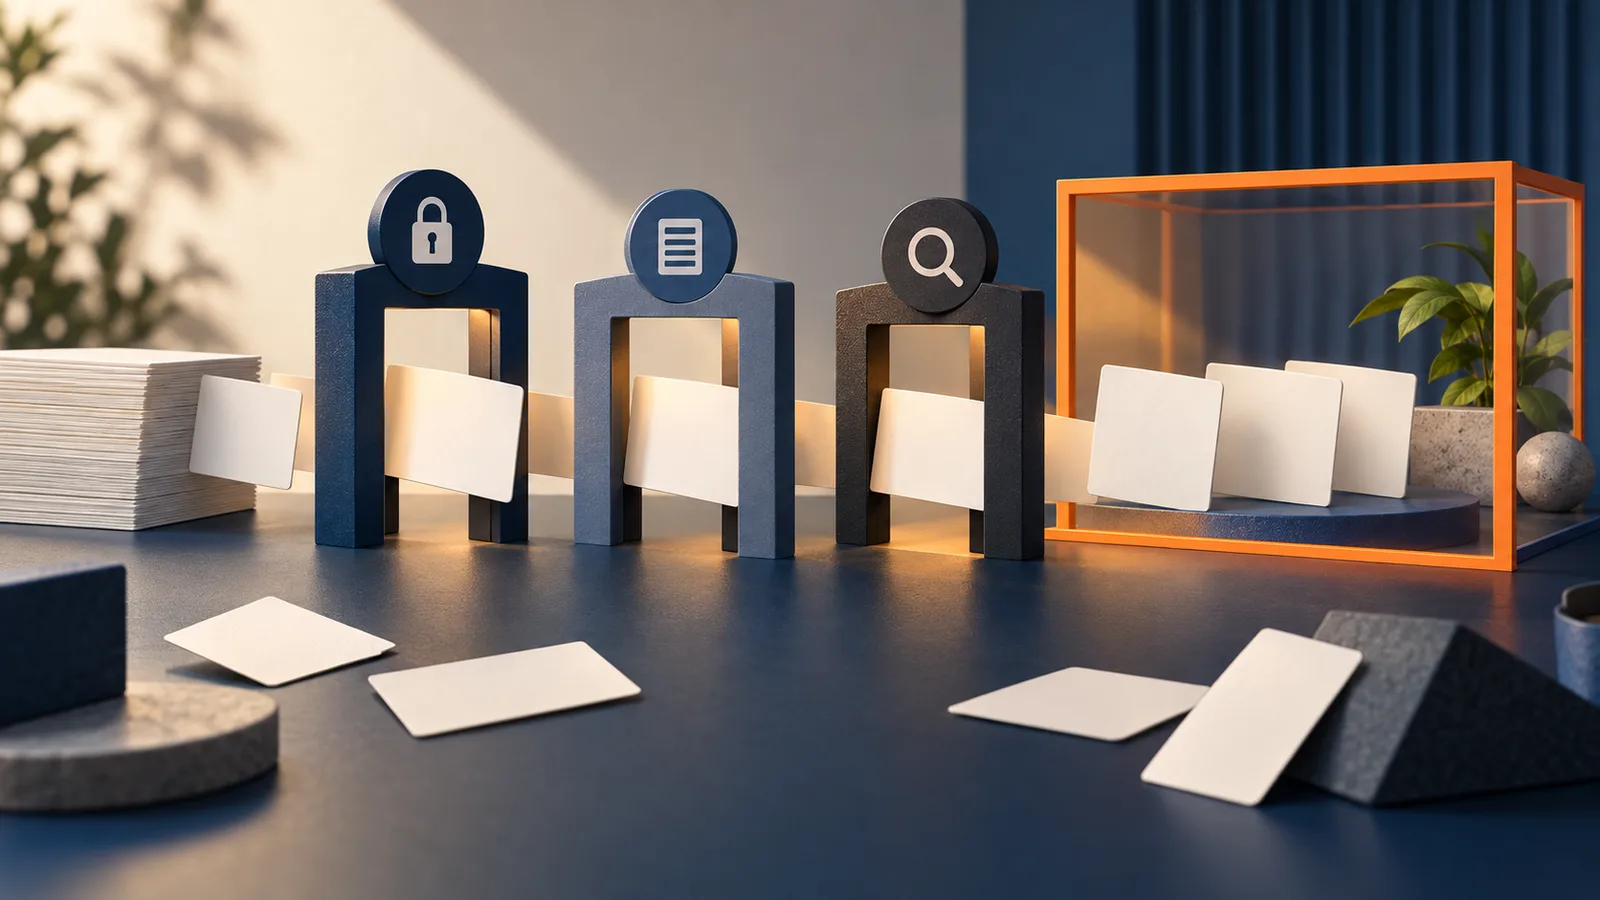
常見的誤用是這樣:財務頁面不想出現在搜尋摘要裡,團隊乾脆把整個網站用 robots.txt 擋掉,結果連需要被找到的公開說明也一起失去抓取機會。目標只是控制摘要文字的話,要先分清楚 nosnippet、max-snippet、data-nosnippet 與 robots 各自控制哪一層。這些指令像窗簾、門鎖和門牌,控制的是不同程度的可見性,把它們當成同一把總開關就會出這種事。
robots.txt 把頁面擋住的時候,這些 meta 指令連被讀到的機會都沒有,就談不上生效。
三個指令的關係,可以想成一本書和圖書館的規則。noindex 是「這本書不要進館藏目錄」;nosnippet 是「書可以進目錄,但別把內文印在索引卡上」;robots.txt 則是「這個書架不要進去」,最後這條一旦生效,書上貼的任何標籤都沒有人看得到。這些規則講的都是 Google 端的摘要與直接輸入,其他來源會不會提到同一主題,要另外查。
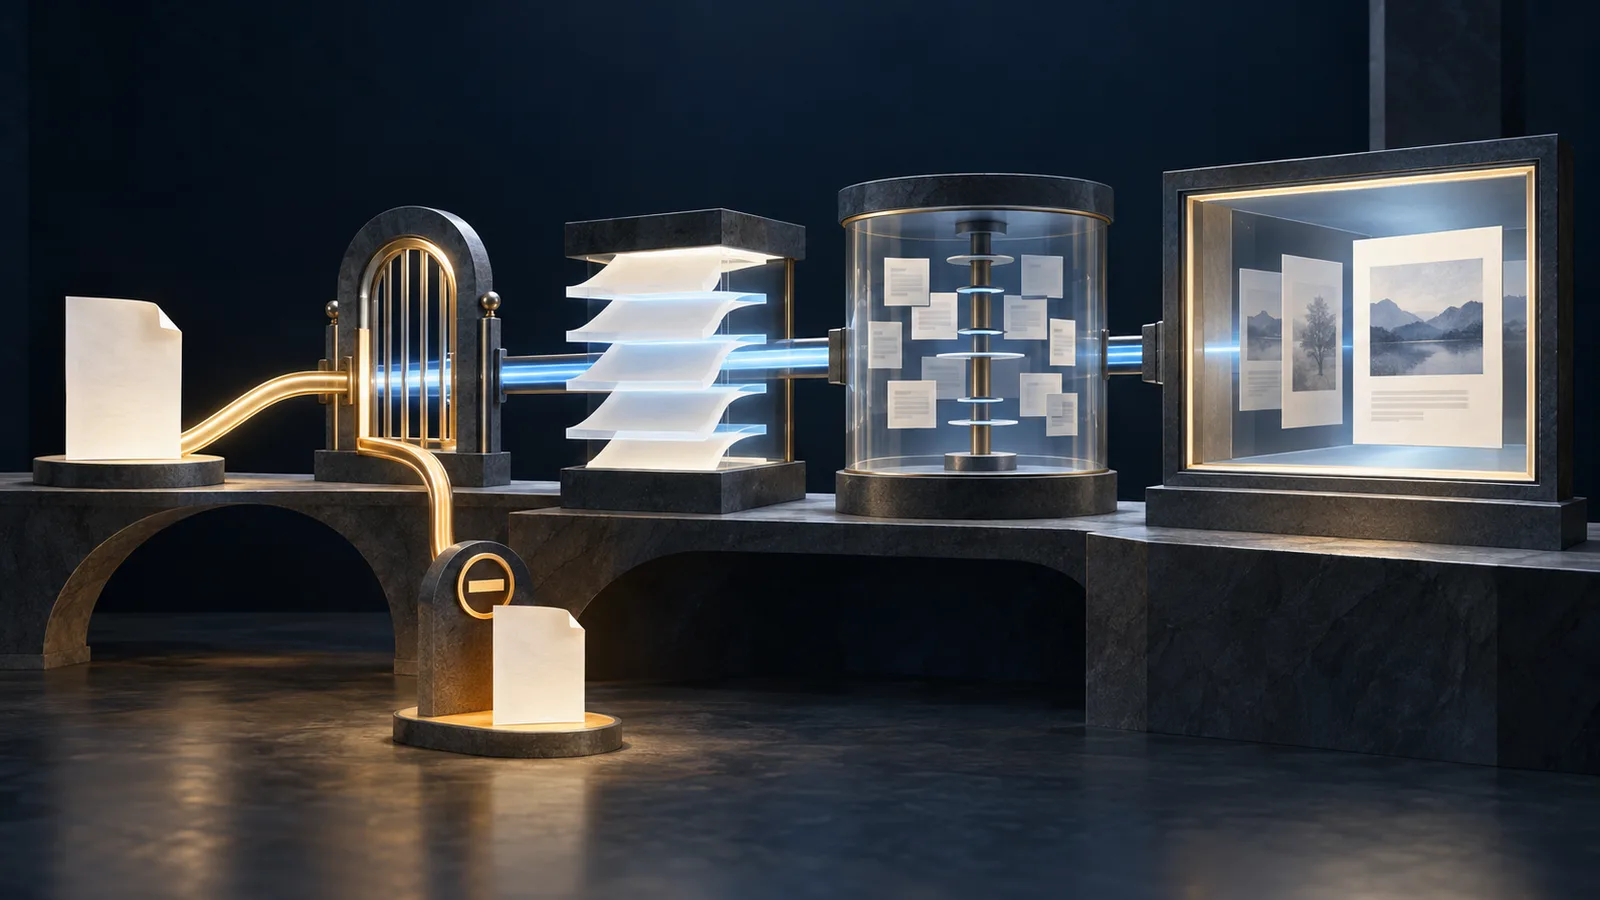 HTML 指令控制得了摘要,控制不了別人怎麼寫你。
先回答 nosnippet 控制什麼
Google 的 robots meta tag 文件 將 nosnippet 定義為不顯示文字摘要,並說明它適用 Google Web Search、Google Images、Discover、AI Overviews 和 AI Mode。這裡的關鍵在於分清兩件事:Google 讀到的頁面內容,以及 Google 產品的摘要或直接輸入。網頁本身照樣存在、讀者照樣打得開,被限制的是摘要這一層。第三方服務怎麼處理,按各自政策查。
如果目標是讓 Google 仍可索引頁面,但不希望頁面文字成為 Google 搜尋摘要或 AI features 的直接輸入,先看 nosnippet 或 max-snippet;只要排除 HTML 某一段的搜尋摘要,看 data-nosnippet,它對 AI 直接輸入的效果要按當前文件核對。目標是讓頁面不出現在 Google 搜尋索引,用 noindex,nosnippet 管不到索引。目標是禁止 crawler 請求,那是 robots.txt 或權限控制的事。
四種控制方式的責任差異
| 指令或機制 | 主要作用 | Google 讀到後的效果 | 它推不出來的事 |
|---|---|---|---|
nosnippet | 不提供文字摘要 | 該內容也不作為 AI Overviews、AI Mode 的直接輸入 | 其他 AI 產品是否讀到需另查 |
max-snippet | 設定可用摘要的最大文字長度 | Google 依限制產生摘要,長度為 0 時等同 nosnippet,不提供文字摘要 | 某個答案完全不提到這個主題 |
data-nosnippet | 在 HTML 中標記特定文字區塊 | 被標記文字不作為 Google 搜尋摘要;AI features 的預覽效果需按當前文件核對 | 它不是整頁 noindex |
noindex | 要求 Google 不將頁面編入索引 | 需要 Google 能抓到指令,並以 Google 的索引處理為準 | 其他搜尋引擎或 AI crawler 也照做 |
表格描述的是 Google 官方文件的適用範圍。Google 仍可能依產品和頁面情況處理 URL,其他平台也有自己的 crawler 政策,跨平台的整理見 robots.txt 能控制 AI 搜尋嗎。
設定範例與適用範圍
整頁限制可以放在 HTML <head> 的 robots meta tag:
<meta name="robots" content="nosnippet">若要設定摘要長度,Google 文件提供 max-snippet 的 robots meta 形式:
<meta name="robots" content="max-snippet:120">若只有一段不應進入 Google 摘要或 AI 直接輸入,可以在頁面可見 HTML 中標記:
<p data-nosnippet>
  這段文字仍可供頁面讀者閱讀,但不作為 Google 搜尋摘要。
</p>要不要加到某一頁,由控制目標決定。部署前先核對 HTML 實際輸出,並讓內容負責人知道摘要會因此變少。Google 的文件也提醒,robots meta tag 只有在 crawler 可以存取頁面時才讀得到;如果 robots.txt 先阻擋 URL,Google 可能無法看到這些指令。
另外,Google robots meta 文件列出部分結構化資料的例外,例如 Article 的 description 欄位,所以 nosnippet 清不掉所有機器可讀的資料。要控制 JSON-LD 的顯示或使用,另查該結構化資料類型的官方文件。
依目的選擇規則
照這個順序問自己,就不太會用錯:
- 你要隱藏整個頁面,還是只限制摘要中的一段文字?整頁索引問題先看
noindex,區塊問題再看data-nosnippet。 - 你是否仍希望 Google 使用頁面內容理解主題?若只控制摘要長度,
max-snippet和nosnippet的後果不同,先確認產品需求。 - 你是否只在意 Google?若還要控制 OpenAI、Anthropic、Perplexity 或其他 crawler,需另外查看其官方政策和 robots 行為。
- 頁面是否需要 crawler 讀取 meta 指令?若 WAF 或 robots.txt 阻擋,必須把存取層與指令層分開查。
- 你要驗證的是搜尋摘要、AI Overviews、AI Mode,還是頁面是否被索引?先固定產品和指標,再選規則。
常見的誤讀有兩種:把「摘要沒有出現」當成「Google 沒有看到頁面」,或把「頁面仍可被打開」當成「它一定能成為 AI 直接輸入」。指令本身證明不了這兩件事。
設定後怎麼確認
本地或測試環境可以先檢查,正式環境要另外拿到實際回應:
| 檢查層 | 檢查內容 | 結果記錄 |
|---|---|---|
| HTML | 初始 HTML、rendered HTML 是否保留預期 meta 或 data-nosnippet | 原始碼版本、時間、URL |
| 存取 | Google crawler 是否收到 200、是否被 robots 或 WAF 擋下 | HTTP 狀態、response header、log 範圍 |
| 索引 | 若使用 noindex,透過 Google 官方工具檢查指令是否被讀到 | URL、檢查時間、工具結果 |
| 摘要 | 在限定產品、查詢與日期下觀察 Google 摘要或 AI features | 查詢、裝置、結果截圖或文字證據 |
| 外部平台 | 若要驗證其他 AI 產品,單獨記錄其 crawler 或答案觀測 | 平台、時間、取樣方法、無資料狀態 |
一次搜尋沒有摘要,證明不了規則已經對所有搜尋結果生效。Google 可能需要重新抓取,搜尋結果也受查詢、語言、位置和產品狀態影響。重複觀測不夠,就記「尚未驗證」,別補成成功或失敗。
nosnippet 管不到的事
nosnippet 只限制 Google 的摘要和 AI 直接輸入。頁面還在,索引還在,其他平台照舊;其他網站寫過你的資料、使用者提供的資訊、已經被獨立取得的事實,它一樣碰不到。你關的是自己那扇門,走廊上別人的門還開著。
反過來也一樣,沒設 nosnippet,Google 也未必會把頁面內容放進 AI Overview。Google 的 AI features 文件 說明 AI features 使用現有 Search 基礎,頁面需要符合索引與摘要資格,抓取、索引和顯示仍由產品狀態決定。指令是限制條件,換不來曝光。
常見問題
nosnippet 會讓頁面完全不出現在 AI Overviews 嗎?
它防止的是你的頁面內容成為 Google AI Overviews 和 AI Mode 的直接輸入,也禁止 Google 顯示文字摘要。同一個主題若有其他來源寫過,那些內容不受你的指令影響。要更廣泛的控制,分開查各平台政策。
nosnippet 和 noindex 有什麼差別?
nosnippet 控制的是 Google 摘要和 AI 直接輸入,noindex 控制的是索引。回到圖書館那個比喻:一個管索引卡上印什麼,一個管書進不進目錄。兩者都要 Google 抓得到、讀得到指令才成立,實際處理以 Google 的索引系統為準。
data-nosnippet 可以標記一個 FAQ 答案嗎?
技術上可以,要不要這樣做則看內容目標。它限制那一段出現在 Google 搜尋摘要;AI features 的預覽效果按當前文件核對,讀者在頁面上仍然看得到那個答案。FAQ 若是這頁的主要回答,部署前先想清楚這個取捨,你擋掉的可能正是讀者搜尋時最需要看到的那一句。
robots.txt 阻擋後,nosnippet 還有效嗎?
這時候它是一個沒有人讀過的指令。Google 官方說明要求 crawler 能存取頁面,才看得到 robots meta tag。擋住存取和傳遞頁面指令是兩個層次,前者會讓後者失去意義。在 log、HTTP 和實際工具結果中分開記錄。
nosnippet 會影響其他 AI crawler 嗎?
Google 的 robots meta 文件描述的是 Google 產品的行為。其他 crawler 讀不讀同一個標記、讀了遵不遵守,查各自的官方文件,同一行 HTML,七家平台可能有七種處理方式。跨平台政策可從 robots.txt 能控制 AI 搜尋嗎開始,仍要按平台驗證。
要把 Google 指令和整體內容治理放回同一個服務範圍,可以從我們的 GEO 服務看起;固定查詢觀測 AI 回答的部分,Otlex 是我們為此開發的平台。