假設一位採購對 ChatGPT 說:「幫我找三家台中能做鋁件小量打樣的廠商,比較交期,再把我們的需求填進他們的詢價表。」agent 打開三家官網。
A 家的交期寫在服務頁上,詢價表欄位清楚,agent 填完後停下來,請採購確認內容再送出。B 家的規格只在一份掃描的 PDF 型錄裡,agent 讀不出交期,只能在比較表上寫「未提供」。C 家的「材質」欄是一個自己刻的下拉選單,agent 點了幾次選不到,最後回報無法完成。
採購最後只收到一張成功送出的詢價單。agent 看得懂、點得到、填得完的網站,才會留在最後那張比較表上。
這篇講的是 agent 在網站上「辦事」這一段:它怎麼看網頁、最常卡在哪、怎麼辨識它、哪些步驟該交回人。至於要不要讓搜尋爬蟲抓取、怎麼寫 robots.txt,請看 robots.txt 管理 AI crawler。
AI agent 和搜尋爬蟲差在哪
同樣是「AI 來你的網站」,背後是三種不同的訪客。搜尋爬蟲自動抓頁面建索引。使用者觸發的抓取,是有人在對話裡貼了網址、請 AI 去讀。agent 則替使用者操作網站,會點按鈕、填欄位、換頁。
例如同一天裡,Googlebot 來抓你的服務頁;有人在 ChatGPT 貼了你的網址問交期;另一位採購請 agent 直接幫他填詢價表。三次來訪,網站要處理的事完全不同。
| 訪客 | 誰啟動 | 做什麼 | robots.txt | 網站要關心的事 |
|---|---|---|---|---|
| 搜尋爬蟲(Googlebot、OAI-SearchBot) | 平台自動排程 | 抓取頁面、建立索引 | 通常會遵守 | 能不能被找到 |
| 使用者觸發的抓取(ChatGPT-User) | 使用者在對話中要求 | 讀取指定頁面 | 可能不適用 | 單頁內容讀不讀得到 |
| 代操 agent(ChatGPT agent、Google-Agent、Edge 的 Copilot) | 使用者交辦任務 | 瀏覽、點擊、填表、預約 | Google 說這類請求一般會略過 | 流程能不能走完、哪裡要停 |
OpenAI 說 ChatGPT-User 由使用者行動觸發,robots.txt 規則可能不適用。Google 對 Google-Agent 的說明也類似:它由 Google 基礎設施上的 agent 使用,依使用者要求瀏覽網頁並執行動作,而使用者觸發的抓取一般會略過 robots.txt。擋爬蟲的設定,管不到替使用者辦事的 agent,這一點要先放進風險評估。
agent 怎麼「看」你的網站
OpenAI 說明,ChatGPT agent 透過虛擬瀏覽器的畫面截圖來「看」網頁,再點按鈕、填表單。Google 的 web.dev 則整理了 agent 讀網站的三種方式:畫面截圖、原始 HTML、無障礙樹(accessibility tree,也就是螢幕閱讀器讀的那份結構)。OpenAI 在 ChatGPT Atlas 瀏覽器的說明裡也提到,它用 ARIA 標籤理解頁面結構和可互動元素。
有些 agent 不在雲端,而是直接在使用者自己的瀏覽器裡操作。微軟說 Edge 的 Copilot 瀏覽功能在本機執行;Chrome 的 Gemini 自動瀏覽也可以在使用者的 Chrome 裡跑。這時你的伺服器看到的就是一般瀏覽器,沒有特別的標記。
實務上的結論很單純:畫面、HTML、無障礙標記三者都要能讀出同一件事。圖片裡的文字、只能用滑鼠拖曳的元件、沒有名字的按鈕,螢幕閱讀器讀不好,agent 也一樣。這其實就是無障礙設計的基本功。
它會在哪裡停下來
各家都設了停下來交給使用者的點,但畫線的位置不同。OpenAI 說 ChatGPT agent 在採取有實際後果的行動前會先徵求同意,例如購買;遇到需要登入的網站,會暫停並請使用者接手虛擬瀏覽器。Chrome 的 Gemini 自動瀏覽會在送出網頁表單、寄送訊息前詢問;Edge 的 Copilot 則在購買、訂位、寄信這類動作前請使用者注意與監督。
換成網站的角度:登入、付款、送出前的確認頁,是 agent 把工作交還給人的地方。這些頁面要讓人一眼看懂 agent 替他填了什麼。
最常卡住的五個地方
下面五個卡點都能在自己的網站上檢查,不需要任何 agent 帳號。
1. 關鍵資訊只在圖片或 PDF 裡
回到開頭的 B 家。交期、材質、最小訂購量寫在掃描版型錄裡,人看得懂,agent 從截圖勉強辨識,HTML 和無障礙樹裡卻什麼都沒有。改法是把會影響選擇的規格寫成頁面文字,型錄留著當下載附件。
2. 表單欄位沒有標籤,或用自製元件
C 家的材質選單是用 <div> 拼出來的,沒有對應的標籤,agent 不知道那是一個選項欄。web.dev 的建議很具體:用 <label> 的 for 屬性把標籤接到輸入欄位,按鈕與連結用 <button>、<a>,少用改造過的 <div>、<span>。表單用標準元件、欄位有標籤,是讓 agent 填得完的最低門檻。
3. 驗證碼與機器人防護擋掉整段流程
OpenAI 說明,每個網站最終決定是否允許它的雲端瀏覽器流量。驗證碼或過嚴的防火牆規則,會讓 agent 在第一頁就停住。這不一定是壞事,付款頁本來就該擋;問題在於連「查規格」都擋掉,客戶的採購 agent 就只能把你寫成「無法存取」。
4. 價格、規格要登入才看得到
agent 碰到登入會停下來請使用者接手。如果只是想看價格區間也要先註冊會員,很多使用者會直接略過你。會員限定的內容可以保留,但公開的資訊不要鎖在登入後面。
5. 送出之後沒有明確結果
表單送出後頁面沒變化、沒有確認頁、也沒有寄確認信,agent 無從判斷是否成功,只能回報「狀態不明」。送出後顯示一頁摘要(收到了什麼、編號、多久回覆),並寄一封確認信給填寫人,人和 agent 都看得懂。
| 卡點 | agent 遇到的情況 | 改法 | 怎麼驗收 |
|---|---|---|---|
| 資訊在圖片/PDF | 讀不到規格,比較表寫「未提供」 | 關鍵規格寫成頁面文字 | 用「檢視原始碼」搜尋規格字串 |
| 欄位沒標籤 | 不知道欄位用途,填錯或跳過 | <label for>、標準表單元件 | 螢幕閱讀器逐欄朗讀一次 |
| 驗證碼全站擋 | 第一頁就停住 | 只在送出、付款等高風險步驟驗證 | 分頁列出哪一步有驗證 |
| 資訊鎖在登入後 | 暫停請使用者登入 | 公開資訊不需登入 | 用無痕視窗走一遍 |
| 送出後無結果 | 回報狀態不明 | 確認頁摘要加確認信 | 送一次測試單,確認頁與信件內容 |
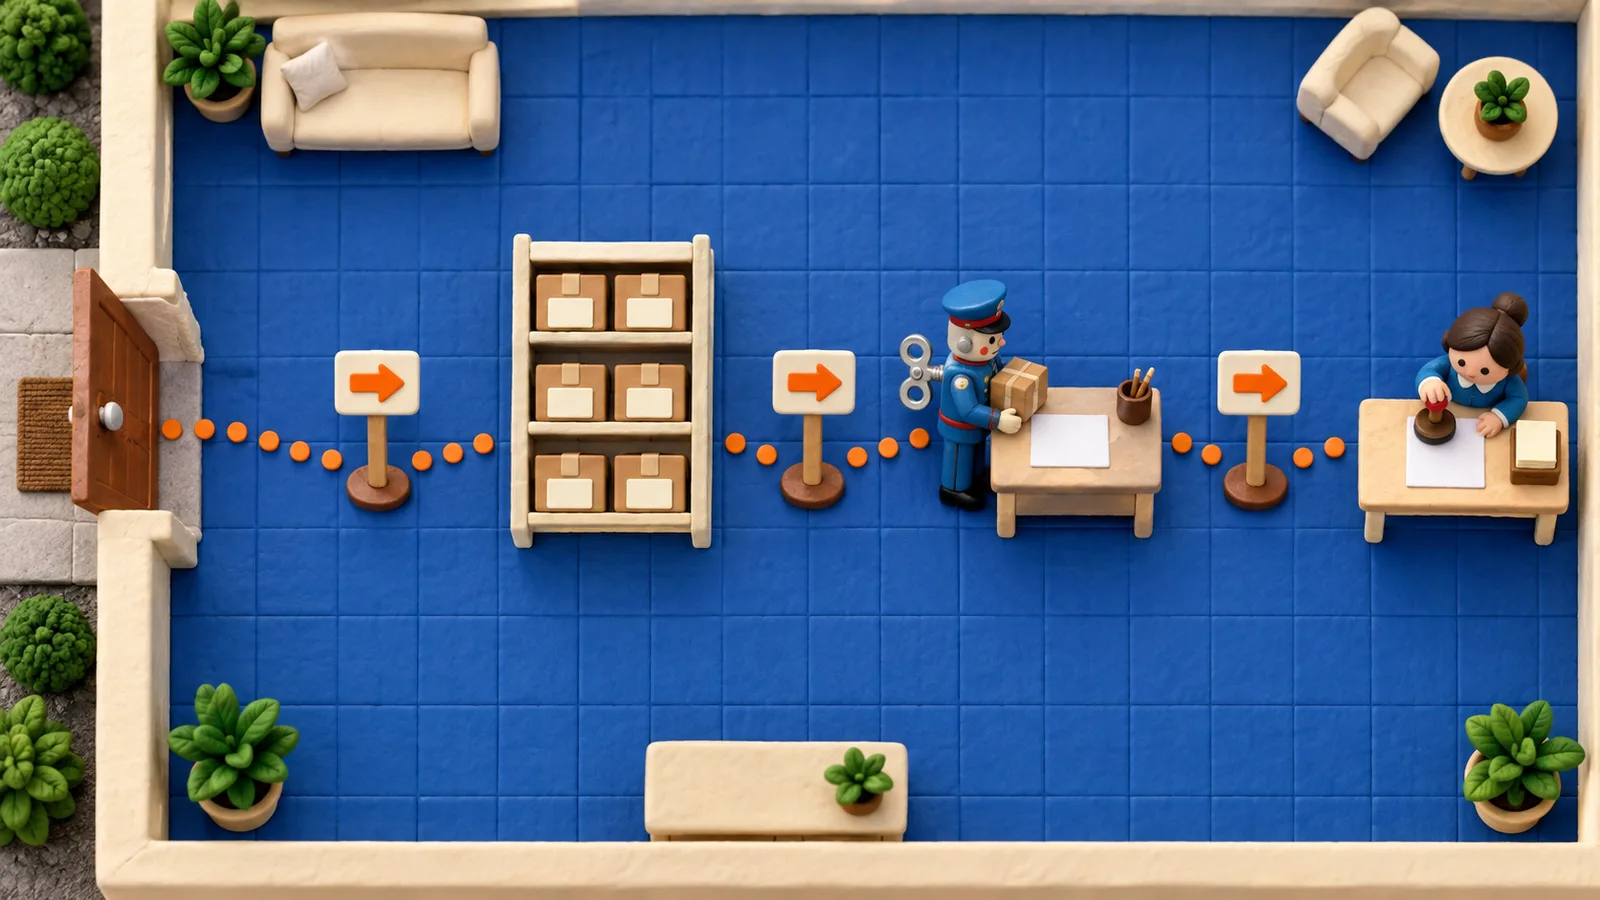 agent 在網站上的一趟任務:找到資訊、填好表單,最後一步交回給人確認。
怎麼辨識 agent 流量
先講限制。Google 說使用者代理(User-Agent)字串可以被偽造;在使用者本機瀏覽器執行的 agent,送出的請求看起來跟一般訪客一樣。只靠 User-Agent 名稱判斷,證據力有限。
比較可靠的是簽章。OpenAI 說它的雲端瀏覽器用 Web Bot Auth 簽署對外的 HTTP 請求,請求會帶 Signature-Agent: "https://chatgpt.com",公鑰放在 OpenAI 公布的固定位置。Cloudflare 的機器人管理也把它標成 chatgpt-agent。
Google 則說正在試驗用 Web Bot Auth 替 Google-Agent 標示身分。Web Bot Auth 目前是 IETF 工作小組的草案,建立在已是正式標準的 HTTP Message Signatures(RFC 9421)之上。
我建議的做法是按流程分級,而不是按訪客名字一刀切:
- 公開資訊頁(服務、規格、價格區間、聯絡方式):放行,讓 agent 讀得到。
- 表單送出:允許填寫,但加上送出頻率限制與重複單檢查,確認信寄給填寫人。
- 付款、合約、帳號設定:維持人工驗證,這些本來就該由本人完成。
- 紀錄:伺服器或 CDN 日誌保留
Signature-Agent與簽章驗證結果,之後才有依據調整規則。
robots.txt 的角色是管搜尋和訓練用的爬蟲,細節請看 OAI-SearchBot 與 GPTBot 設定。
哪些步驟讓 agent 做完,哪些交回人
例如開頭那位採購的詢價任務,可以拆成五步來看:
| 步驟 | 建議 | 理由 |
|---|---|---|
| 查規格、交期、價格區間 | 讓 agent 自己完成 | 公開資訊,讀不到就被排除 |
| 下載型錄、比較方案 | 讓 agent 完成,並提供 HTML 版 | 附件讀不到時還有頁面可讀 |
| 填寫詢價或預約表 | agent 可以填,送出前由使用者確認 | 各家 agent 本身也會在送出前詢問 |
| 付款、簽約 | 交回使用者 | 有金錢與法律後果 |
| 修改帳號、密碼、收件資料 | 交回使用者 | 身分與安全相關 |
確認頁要寫給人看:把 agent 代填的內容列成摘要,讓使用者在按下送出前看得出有沒有填錯。這一頁做得好,對直接上網填表的客戶一樣有用。
新標準還在早期,先做基本功
幾個常被提到的新東西,目前的狀態是這樣:
- WebMCP:Chrome 提出的網頁標準提案,讓網站把表單、功能宣告成 agent 可以直接呼叫的工具,其中一種做法就是在既有的 HTML 表單上加註記。Chrome 149 起開放 origin trial,規格仍是 W3C 社群小組草案,不在正式標準流程上。
- 代操結帳:OpenAI 在 2026 年 3 月調整做法,讓商家用自己的結帳流程;Google 的 UCP 代操結帳目前適用美國、加拿大、澳洲的合格商家。
- AI Mode 代訂餐廳:Google 已在美國、英國、加拿大、南非開放,做法是把使用者帶到訂位頁完成最後一步。
ChatGPT 的 agent 模式開放給付費方案使用,Google 與微軟的代操功能多半先在美國等市場開放。對台灣的網站來說,現在最值得做的是語意化的 HTML、有標籤的表單和寫成文字的關鍵資訊,這些對人、對搜尋、對 agent 都有用;WebMCP 等標準穩定、主要瀏覽器都支援後再評估。
跟 AI 搜尋的其他技術設定怎麼接
agent 準備和 AI 搜尋的技術設定是連在一起的。頁面要先讀得到,agent 才有東西可用:初始 HTML 有沒有正文,看 JavaScript 渲染會不會影響 AI Search;從 robots.txt 到防火牆的整套檢查,看 AI crawler 可存取檢查表。
差別在於,爬蟲只需要「讀得到」,agent 還需要「走得完」。例如 C 家的服務頁,爬蟲抓得到、搜尋也找得到,卡住的是那個自製下拉選單。所以檢查清單要多出表單、確認頁與身分驗證這幾項。
想請人幫你走一遍
如果你想知道自己的網站在 agent 眼裡長什麼樣,我們的 GEO 服務會把網站技術檢查納入診斷:頁面是否讀得到、表單與流程能否完成、agent 流量怎麼分級。
如果你想的是反過來,讓公司內部用 agent 處理詢價整理、客服分案這類工作,那是我們企業 AI 營運方案處理的範圍。
常見問題
robots.txt 能擋住 AI agent 嗎?
不太能。OpenAI 說 ChatGPT-User 這類使用者觸發的請求,robots.txt 可能不適用;Google 也說使用者觸發的抓取一般會略過 robots.txt。要限制 agent,得在伺服器或 CDN 層用簽章與規則處理,並按流程分級。
AI agent 會自己幫客戶按下送出或付款嗎?
依各家公開說明,購買、訂位、送出表單這類有後果的動作,agent 會先停下來請使用者確認,但每家畫線的位置不同。網站這一端的做法,是讓確認頁清楚列出代填內容,付款與帳號變更維持本人驗證。
現在要不要導入 WebMCP?
大多數網站還不用。WebMCP 目前是 Chrome 的 origin trial,規格仍是社群小組草案。先把表單標籤、按鈕元件和確認流程做好,這些工作在 WebMCP 成熟後也用得到,它的宣告式做法本來就建立在既有 HTML 表單上。
驗證碼會把 agent 擋在外面,要不要拿掉?
不用全拿掉,挪位置就好。驗證放在送出、付款這些高風險步驟,查規格、看價格區間的頁面不要擋。這樣 agent 能讀資訊,關鍵動作仍由本人完成驗證。
台灣的使用者現在用得到這些 agent 嗎?
ChatGPT 的 agent 模式開放給付費方案;Google AI Mode 代訂、Chrome 自動瀏覽、Edge 的 Copilot 瀏覽目前多半先在美國等市場開放。開放範圍變動很快,但網站端的準備工作不需要等。
參考來源
以下依官方文件整理,功能與開放地區以各家頁面當下為準。
- OpenAI:ChatGPT agent
- OpenAI:Introducing ChatGPT agent
- OpenAI:ChatGPT Work’s Cloud browser allowlisting
- OpenAI:Publishers and Developers FAQ
- OpenAI Developers:Overview of OpenAI Crawlers
- Google:List of Google user-triggered fetchers
- web.dev:Build agent-friendly websites
- Google Chrome 說明:Gemini in Chrome auto browse
- Microsoft:Browse with Copilot
- Chrome for Developers:WebMCP
- Web Machine Learning CG:WebMCP 草案
- IETF:Web Bot Auth HTTP Message Signatures 草案
- Cloudflare Docs:Web Bot Auth
- OpenAI:Powering Product Discovery in ChatGPT
- Google Merchant Center 說明:Universal Commerce Protocol
- Google:AI Mode 代訂餐廳在英國開放