假設內容團隊說:「我們用瀏覽器打開是 200,AI crawler 應該也看得到。」工程師改用指定 user-agent 重跑,卻先在 WAF 收到 403;放行後,初始 HTML 仍只有載入中的 <div>,主要答案要等 JavaScript 執行才出現。這不是同一個問題的兩種說法,而是「連得上」和「讀得懂」分在不同層。
把每一關的請求、回應與內容各自留下來,最後才知道該修 robots、WAF、HTML,還是把索引與 AI 產品的觀測另列,而不是看到一個 200 就提前下結論。
這篇給你的是可以照著跑的東西:可存取的三個層次、八層檢查表、逐層執行方法與指令示例,以及哪些結論不能從技術檢查推出來。
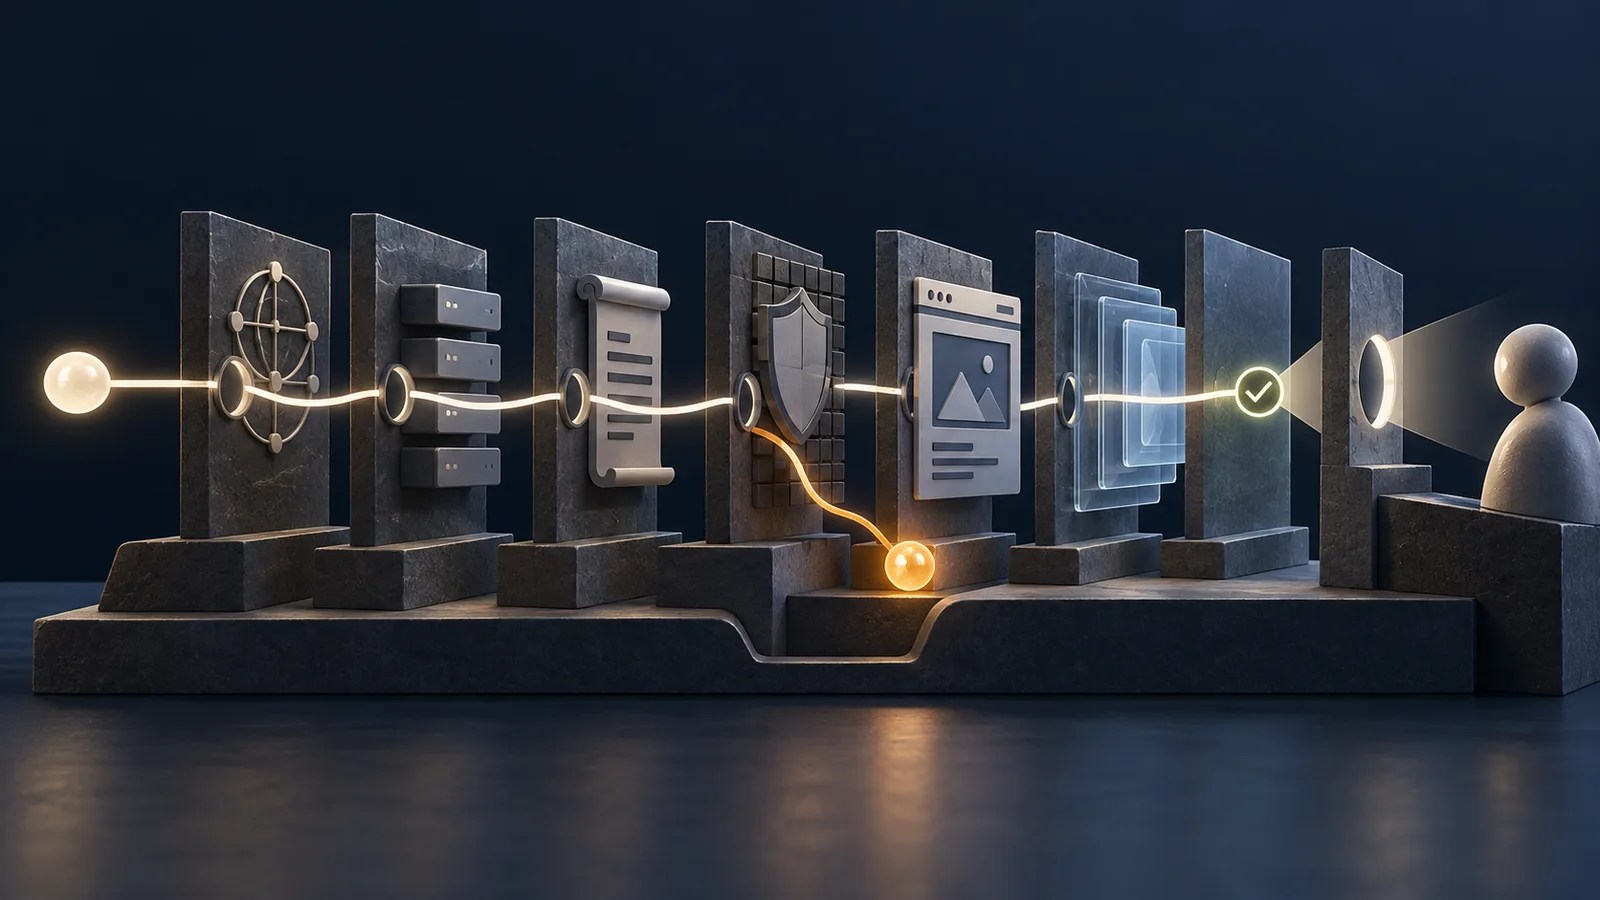
一個 URL 打不開的原因,比大多數人想的多。robots.txt 的 Allow 只是第一道門,後面還有 DNS、TLS、HTTP 狀態、WAF、登入、noindex、canonical、JavaScript 渲染、空白 HTML。這有點像寄一封掛號信:地址寫對只是最開始,中間還有分揀、投遞、大樓管理室、對方在不在家——任何一關卡住,信都沒送到,而寄件人看到的只是「查無投遞紀錄」。
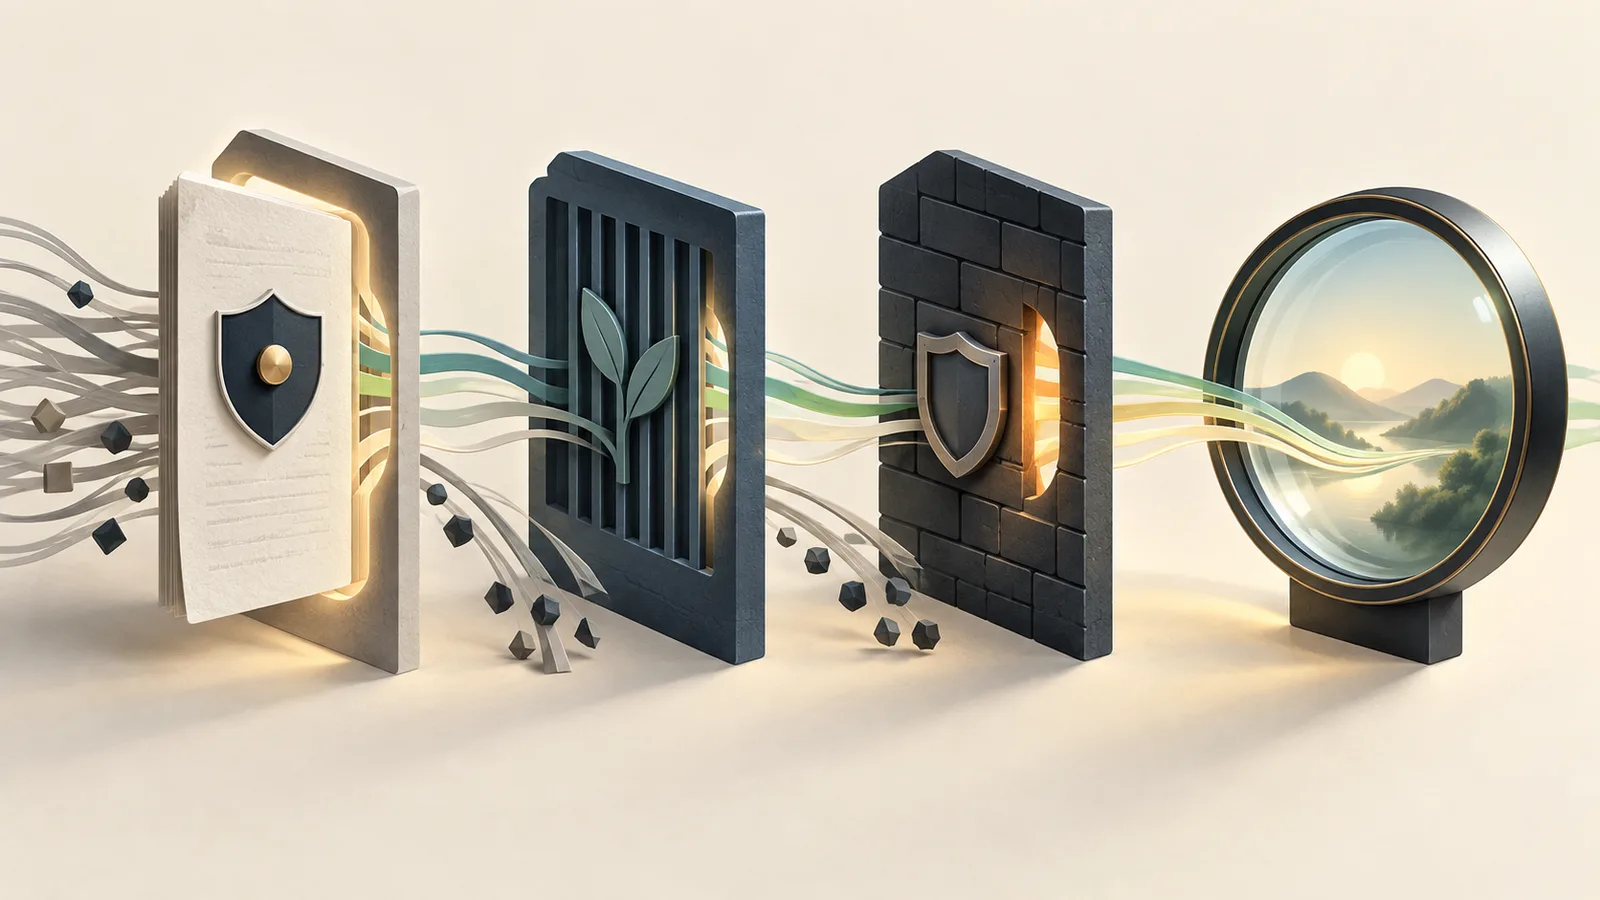 通過技術檢查不等於索引或 AI citation 成立。
先定義可存取,不要直接寫成可引用
可存取有三個層次:指定 crawler 建立得了連線、收得到頁面回應、回應裡有讀得懂的內容。AI 產品會不會用這份內容,是第四層的產品與查詢選用。用瀏覽器手動打開頁面,證明的是「一般讀者在這個環境打得開」——你的瀏覽器帶著你的 IP、你的 cookie、你的地區,crawler 一項都沒有。
Google 的 robots.txt 介紹 說明 robots.txt 控制 crawler 可以請求哪些 URL,但它不是完整的隱藏機制;Google 的 AI features 文件 則要求頁面可被抓取、編入索引並具備摘要資格,且抓取、索引和顯示都不保證。這兩份官方邊界支持的是分層稽核。從「robots 寫了 Allow」直接跳到「會被 AI 引用」,中間跳過了六層。
跨平台的 user-agent 和政策矩陣已在 robots.txt 管理 AI crawler另行整理。這篇不重複列每家 crawler,只講一套能套到指定平台、指定 URL 的檢查流程。
八層檢查表總覽
| 層次 | 要回答的問題 | 主要證據 | 常見未確認 |
|---|---|---|---|
| 1. 範圍 | 查哪個 URL、哪個 crawler、哪個日期? | URL、user-agent、時區 | 沒有固定查詢範圍 |
| 2. 網路 | DNS、TLS、連線是否可用? | request 結果、錯誤碼 | CDN 或區域限制未讀取 |
| 3. HTTP | 回應是否為可處理的狀態? | status、header、redirect chain | 只測瀏覽器,不知 crawler response |
| 4. robots | 規則是否允許目標路徑? | robots.txt 版本與解析結果 | 平台是否遵循未查證 |
| 5. WAF | 安全層是否放行真實 crawler? | WAF event、IP 或 UA 規則 | UA 可偽造,來源未核對 |
| 6. HTML | 回應是否有標題、文字、連結與指令? | initial HTML、headers | 只看渲染後畫面 |
| 7. 渲染 | 重要內容是否依賴 JavaScript? | rendered DOM、錯誤 log | 目標 crawler 是否渲染未知 |
| 8. 索引與產品 | 頁面是否索引、是否在答案中被選用? | URL tool、Search Console、固定觀測 | 沒有資料不能寫成零 |
這張表把技術讀取和產品結果放在不同層。前七層在你的網站與測試環境就拿得到局部證據;第八層要指定搜尋產品、property、日期和查詢——它是唯一能回答「有沒有被用到」的一層,前七層全過也替代不了它。
逐層執行 AI crawler 稽核
1. 先建立 URL 與 crawler 範圍
先寫下完整 URL、協定、主機、路徑、查驗日期、指定 user-agent 和地區。只查了首頁的話,結論就停在首頁——產品頁、圖片 URL 或 API 可能走不同的路由和規則。要比較不同 crawler 時,用相同 URL、相同時段、相同測試條件;差一小時測,看到的差異可能只是 WAF 當下的心情。
2. 測 DNS、TLS 和 HTTP
記錄 DNS 是否解析、TLS 是否成功、response status、content type、content length 和 redirect chain。可在測試環境用不含憑證的基本請求建立紀錄:
curl -I -L -A "指定的測試 user-agent" https://example.com/page這個命令只是示範檢查方法,真實 crawler 未必送出相同 header。Response 是 401、403、429、5xx 或一長串重新導向時,先找出存取層的原因。瀏覽器最後顯示 200 很容易讓人收工——中間那幾跳的拒絕,和換一個 user-agent 之後的結果,都還沒有被看過。
3. 讀 robots.txt 與實際路徑
保留被測日期的 robots.txt 內容,逐條比對 user-agent、Allow、Disallow 和 sitemap 宣告。Google 文件提醒,robots.txt 不能用來當作從搜尋結果隱藏頁面的完整方法,禁止存取的 URL 仍可能以沒有內容的形式出現在索引中。若目標是傳遞 noindex,必須讓 crawler 能讀取頁面指令。
別只看最上面的 User-agent: *。更具體的 token 規則會蓋過它,解析方式也要按 RFC 9309 和平台文件理解。跨平台的政策細節回到各家官方文件——同一份 robots.txt,七個服務可能有七種讀法。
4. 檢查 WAF、CDN 與速率限制
WAF 可能依 IP、ASN、TLS 指紋、header、請求頻率或地區作出判斷。user-agent 字串可以被偽造,所以只以一個 UA 名稱放行,證據強度有限。若要核對官方 crawler,保存官方發布的 IP 或驗證方法、WAF event、response status 和時間窗;若拿不到這些資料,就把來源驗證記為未知。
網站 log 也要留意 403 與 429,不要只統計 200。若同一 URL 在不同時間收到不同回應,記錄快取、負載和規則版本,避免把一次成功請求當成長期可存取。
把 robots、WAF 與 HTTP 分開記錄
可用下表保存每次稽核,並把「允許」和「已讀到」分開:
| 欄位 | 範例值 | 判讀界線 |
|---|---|---|
| URL | https://example.com/guide | 必須固定 canonical 版本或明確說明參數 |
| crawler | 指定平台 token | 產品用途與 token 來源需記錄 |
| robots | allowed、disallowed、unparsed | 只代表規則解析,不代表 HTTP 成功 |
| HTTP | 200、403、429、5xx | 只代表本次 request response |
| WAF | allowed、challenged、blocked | 需有 event 或規則證據 |
| HTML | text present、thin、empty | 要標示 initial 或 rendered |
| index | verified、未確認、excluded | 需要搜尋工具或第一手證據 |
| answer | observed、not observed、無資料 | 需固定 query、日期、產品 |
這種紀錄比單一綠燈更適合交接。not observed 是在指定樣本中沒有看到,無資料是資料不足,未確認是尚未知道狀態,三者都不能簡化成零。
初始 HTML 與渲染內容
如果重要答案只在 JavaScript 執行後出現,檢查 initial HTML 和 rendered DOM 的差異。Google 的 JavaScript SEO basics 說明 Google 會經過抓取、渲染、索引階段,且不是所有 crawler 都執行相同的 JavaScript。頁面至少要在可接受的 HTML 或可驗證的渲染結果中提供標題、主要文字、內部連結、canonical 和 robots 指令。
不要把 screenshot 當成 HTML 證據。檢查原始 response、DOM、console、network 和 HTTP 狀態,並標示檢查是在本地、測試環境或正式環境。若不同 crawler 的渲染能力未知,結論應保留平台範圍,不能說「AI crawler 都能讀」。
用本站 135 個 URL 跑一次公開 HTML 檢查
2026 年 10 月 3 日,我們把 EthorX 正式 sitemap 當成固定清單,以 EthorXSEOAudit/1.0 發出 GET,解析回應裡的 UTF-8 HTML。這次共讀取 135 個 URL;程式先讀 robots.txt,使用 5 個 worker,每次請求前等待 1 秒,逾時設為 25 秒。
| 檢查項目 | 當次結果 | 結果支持到哪裡 |
|---|---|---|
| HTTP 200 | 135/135 | 本次測試請求成功 |
| title 與 description 均存在 | 135/135 | HTML 有這兩個欄位,未評分文案品質 |
| 單一 H1 | 135/135 | 每頁找到一個 H1 |
| canonical 與被測 URL 相同 | 135/135 | 網站宣告一致,未確認 Google 採用 |
| HTML/HTTP 指令含 noindex | 0/135 | 這份 sitemap 的回應未出現 noindex |
你可以下載當次逐頁結果 JSON和Python 檢查程式,在裝有 Python 3 的電腦上重跑。程式只使用標準函式庫,不需要 API key。將下載的程式放到工作目錄後執行:
python3 audit-public-seo.py --base https://www.ethorx.com --out audit.json換成自己的網域時,這個簡版程式接受根目錄的 sitemap.xml URL 清單,上限 300 個頁面;sitemap index 要另拆清單處理。結果保留請求時間、狀態、欄位與 HTML 的 SHA-256,錯誤會另列,不把抓不到的頁面算成通過。今天重跑得到不同數字,不必然是網站變差,也可能是清單或內容已更新。先比日期、URL 與回應,再下結論。
這次也抓出檢查器本身的一個誤判:重複輪播的裝飾 logo 使用空 alt,先前解析把空值當成沒有屬性。修正成檢查屬性是否存在後,135 頁中的圖片沒有缺少 alt 屬性的情形;這仍不代表每張圖的替代文字都寫得恰當。
這份資料完成的是上表中的部分 HTTP 與初始 HTML 檢查。它沒有冒充 Googlebot 或任何 AI crawler,沒有讀取 WAF 記錄,也沒有測到索引或 AI 回答。要繼續查第八層,仍需用對應工具取得另一次證據。
如何保存未確認與無資料
每次完成稽核後,至少保存四份內容:測試條件、取得的 response、判斷規則、尚未取得的資料。以下是適合報告的句型:
- 已取得:指定 URL 在某日期、某 user-agent 下回傳 200,initial HTML 含有主要文字。
- 部分取得:robots.txt 顯示允許,但尚未取得 WAF event 或官方 crawler IP 驗證。
- 未知:尚未確認該 AI 產品是否使用 JavaScript 渲染或該頁是否已索引。
- 無資料:指定日期沒有足夠的固定查詢結果,因此不計算引用率。
這些句型能把技術證據和產品推論分開。若需要整理網站整體可見度,可以從 EthorX GEO 服務了解工作範圍;若需要產品層的觀測入口,可參考 Otlex。
常見問題
robots.txt 允許 AI crawler 就代表頁面會被引用嗎?
robots 處理的是部分 crawler 的 URL 存取規則,後面還有 HTTP、WAF、HTML、索引和產品選用五層。指定查詢沒看到引用時,保留查詢與日期——允許規則是一道門開著,不是有人走進來。
一個 200 response 就足以證明 AI crawler 能讀內容嗎?
200 證明的是那一次請求成功了。還要看 content type、內容完不完整、有沒有登入牆、依不依賴 JavaScript,以及指定 crawler 實際收到什麼——同一個 URL 回 200,內容可能是一段「請先登入」。只測過一般瀏覽器的話,crawler 版本記成未知。
WAF 只用 user-agent 放行可以嗎?
它可以是規則的一部分。UA 這個欄位任何人都能自己填——所以用它當唯一條件放行,等於在門口只問名字。要主張官方 crawler 已被驗證,依平台官方文件核對 IP、DNS、WAF event 或其他方法;拿不到來源證據時,把放行規則的限制寫出來。
AI crawler 可讀取圖片就代表可理解文章嗎?
文章能不能被理解,還涉及可見文字、HTML 結構、標題、內部連結、圖片替代文字、渲染結果和來源歸屬。圖片抓得到、文章讀不到的情況很常見——兩者是不同的觀測,要分開記。
稽核完成後就能計算 AI 搜尋 SOV 嗎?
可存取稽核給的是技術條件。SOV 或提及率需要固定平台、查詢樣本、日期、分母和有效回答規則——這五項一項都不在稽核結果裡。沒有產品答案資料時保存無資料狀態;從一個 200 或一行 robots Allow 推出比例,那個分母是憑空的。