你把公司官網做好、按下發布之後,架站平台的 SEO 檢查清單跳出一行「請提交 sitemap」。或者你拿免費的 SEO 檢查工具掃了自己的網站,報告寫著「找不到 sitemap」。你搜了這個詞,想知道它要不要做,做了又能換到什麼。
2026 年 10 月 16 日,我在 Search Console 查我們的產品頁 ethorx.com/otlex。Search Console 是 Google 給網站主看搜尋狀況的免費後台。這一頁一直列在 sitemap 裡,Google 也知道它存在,可是一直沒有來讀過它。「關於我們」那一頁也一樣。
所以 sitemap 做到的,是讓 Google 知道有這一頁。Google 什麼時候來讀、讀了之後收不收錄,之後 AI 回答會不會引用,都要另外確認。
後面我把爬蟲來讀頁面叫做「抓」,把頁面被存進 Google 的資料庫叫做「收錄」。爬蟲是搜尋引擎派來讀網頁的程式。Search Console 的畫面上,這兩件事寫成「檢索」和「建立索引」。
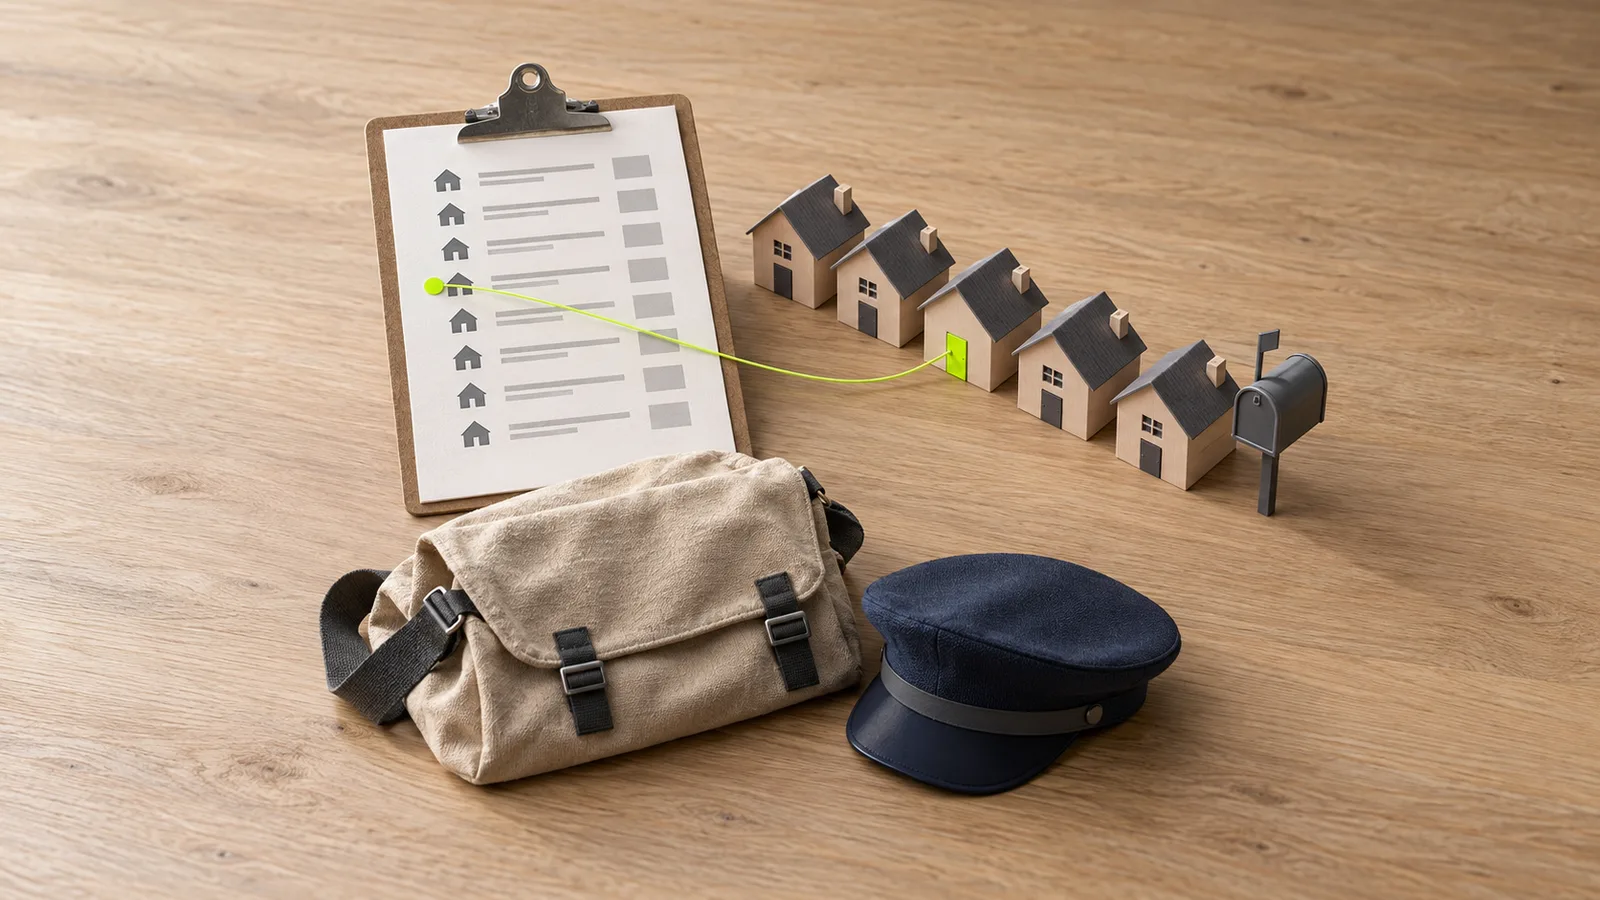
sitemap 像是交給郵差的住戶名冊
- 名冊上列出社區裡有哪些門牌。sitemap 列出的則是網站有哪些網址。
- 每一戶旁邊可以註明最近一次整修的日期。sitemap 裡的 lastmod 就是這個日期。
- 郵差拿到名冊,只是知道有這一戶,什麼時候去按門鈴,還是郵局自己排班。Google 拿到 sitemap 也一樣,什麼時候來抓是它自己決定的。
- 名冊上的地址如果有一半是空屋或已經拆掉,整修日期又每天都寫今天,郵差就會越來越不信這本名冊。
- 這個比喻有一處對不上。真的郵差拿到名冊,每一戶遲早都會送到。Google 卻可以一直不來,來了也不一定收錄。至於 AI 回答會不會引用,更是名冊管不到的事。
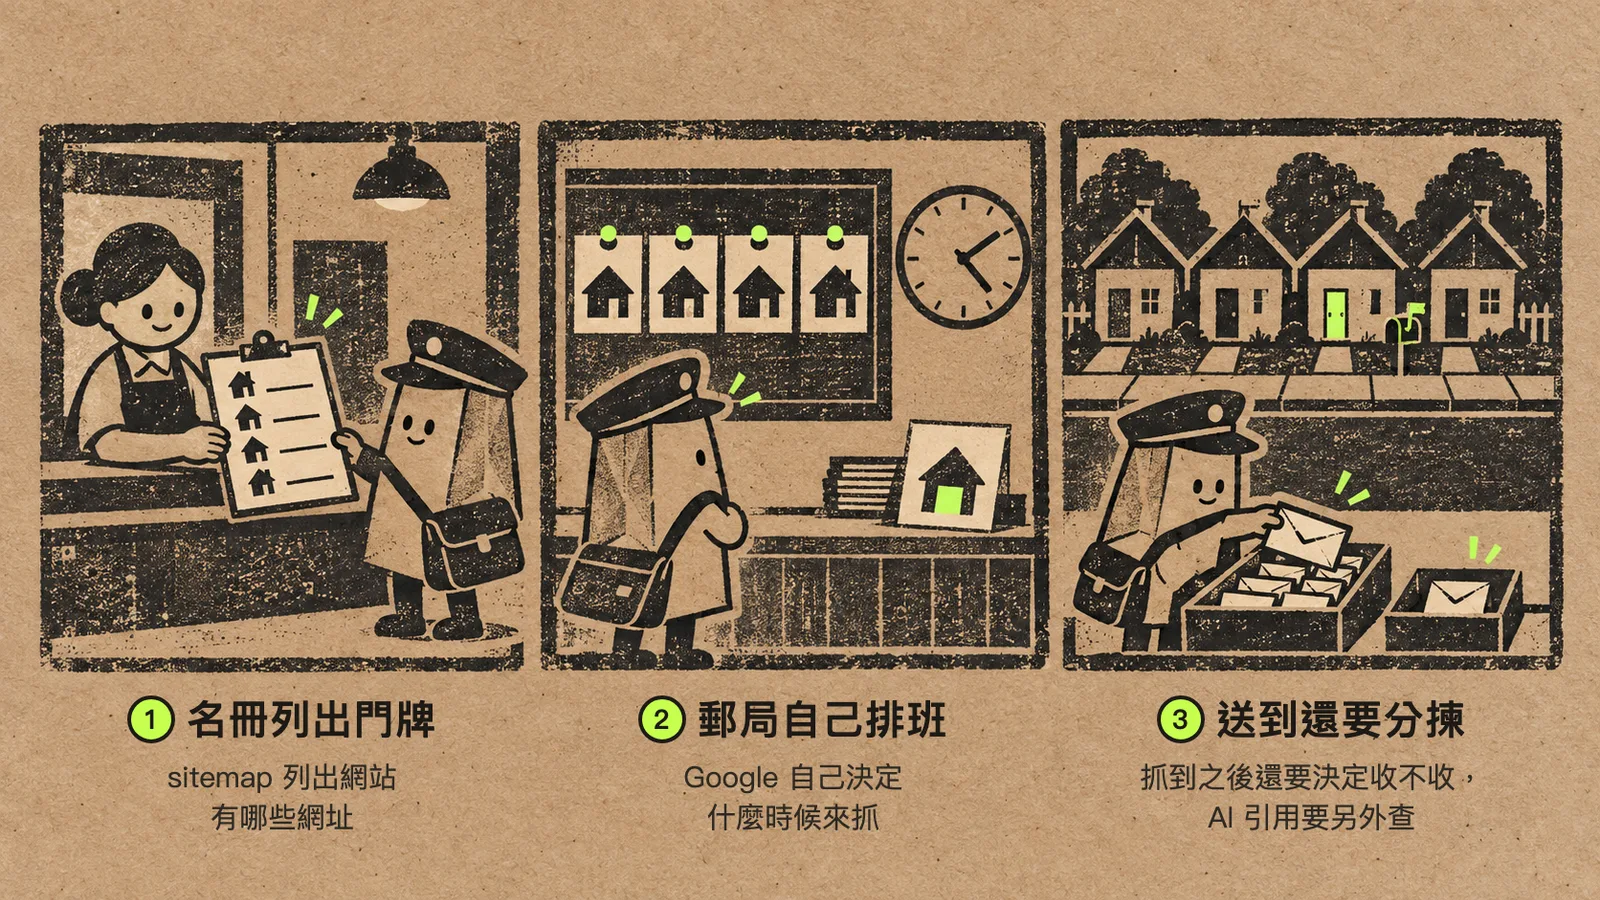 小郵差代表 Google 的爬蟲。名冊只負責告訴它有哪些門牌,什麼時候去、送到之後收不收,都是另外決定的。
sitemap 能幫上什麼、幫不上什麼
sitemap 能幫搜尋引擎更有效率地找到你的網址,但它不保證每個網址都會被抓、被收錄(瞭解 Sitemap)。我們的 /otlex 就是例子:名冊上有,郵差還沒去。
下面三種網站比較需要 sitemap。
- 網站很大:頁面多到很難確保每一頁都有別的頁面連過去,爬蟲就容易漏掉新頁。
- 新網站,還沒有什麼外部連結:爬蟲是順著連結找網頁的。沒有別的網站連到你,它就不容易找到你。
- 影片和圖片很多:sitemap 可以替這些檔案補上額外的資訊。
反過來說,如果你的網站大約 500 頁以內,站內的頁面也都互相連好了,你可能不需要 sitemap。以 ethorx.com 來說,網頁數在這個範圍內,文章之間也有互相連結。所以 sitemap 對我們比較像保險:新文章還沒被其他頁面連到之前,Google 就能先知道它存在。
sitemap 只回答一個問題:網站希望搜尋引擎知道哪些網址。爬蟲進不進得來、頁面有沒有被收錄、AI 回答有沒有引用,它都回答不了,要另外查。
AI 爬蟲會不會用 sitemap?
要看是哪一家。Google 的 AI 摘要和 AI 模式用的是 Google 收錄的網頁,Copilot 用的是 Bing 收錄的網頁。這兩家的爬蟲都會讀 sitemap。
Bing 的網站管理員指南更把 XML sitemap 列為讓 Bing 和 Copilot 找到網址的四種方法之一。另外三種是 IndexNow、站內連結和外部連結(Bing Webmaster Guidelines)。
OpenAI、Anthropic、Perplexity 就不一樣了。這三家公開的爬蟲說明頁只寫爬蟲的名稱、用途,以及怎麼用 robots.txt 管它。robots.txt 是放在網站根目錄、告訴爬蟲哪些路徑別來抓的文字檔。
這三頁從頭到尾都沒有提到 sitemap(OpenAI、Anthropic、Perplexity)。所以你不能假設它們會照 sitemap 來抓。
它們有沒有來過,要看伺服器的存取紀錄,後面的檢查點會講怎麼看。各家 AI 爬蟲的名字怎麼在 robots.txt 裡設定,可以看 robots.txt 怎麼管理 AI 爬蟲。
sitemap 要怎麼產生與提交?
多數架站平台會自動產生 sitemap,你要做的是找到它的網址,再提交給搜尋引擎。自己寫的網站才需要用程式或工具產生(建立並提交 Sitemap)。
sitemap 通常是一個 XML 檔。XML 是用標籤把每一筆資料標出來的文字格式,後面有一段實際的例子。
| 平台 | sitemap 在哪裡 | 要注意的事 |
|---|---|---|
| WordPress(內建) | 5.5 版起內建,網域後加 /wp-sitemap.xml 就是總表 | 後台把「搜尋引擎可見度」設成阻擋時,內建的 sitemap 會關閉;每個子檔最多 2,000 個網址 |
| WordPress 加 SEO 外掛 | Yoast SEO 和 Rank Math 的總表都在 /sitemap_index.xml,開關在各自的外掛設定裡 | Yoast 的 sitemap 功能開著時,會自動停用 WordPress 內建的那一份;Rank Math 連上 Search Console 帳號後,會自動替你提交總表 |
| Wix | 網域後加 /sitemap.xml 是總表,底下再分 /pages-sitemap.xml 等子檔 | 改網站就自動更新;用 SEO 設定檢查清單連上 Search Console 時,Wix 會替你提交,但要有 Premium 方案和已連接的網域 |
| Shopify | 網域後加 /sitemap.xml,連到商品、分類、網誌、網頁各自的檔 | 新增商品或頁面時自動更新;商店設成不公開(private mode)時 Google 讀不到;Basic 以上方案用了國際網域功能時,每個網域各有一份,要分開提交 |
| 自己寫的網站 | 用程式依內容產生,或用產生器工具掃一次 | ethorx.com 是程式依文章狀態產生的,規則在後面「XML sitemap 裡的網址要怎麼整理」那一節;用工具掃出來的是當下的快照,之後新增的頁要自己補 |
不知道自己的 sitemap 在哪裡,先在網域後面加 /sitemap.xml 試試,不行就看 robots.txt 裡有沒有 Sitemap: 那一行。已經提交過的,Search Console 的 Sitemap 報表也列得出來。
把 sitemap 交給 Google,一般網站主用得到的方法有兩種。工程師另外還可以用 Search Console API 以程式提交。
- 在 Search Console 左側的「Sitemap」報表貼上網址、按提交。你要是那個資源的擁有者才能提交。資源就是你在 Search Console 加入並驗證過的那個網站。
- 在 robots.txt 加一行
Sitemap: https://你的網域/sitemap.xml。沒有擁有者權限時也能用,Google 下次抓 robots.txt 時就會看到它。
只寫在 robots.txt、沒有在報表提交過的 sitemap,不會出現在 Sitemap 報表裡。你也就看不到 Google 讀它讀得順不順。所以就算 robots.txt 已經寫了,我還是建議到報表提交一次(Sitemap 報表)。報表怎麼讀,Search Console 教學那篇有截圖。
提交之後報表一直沒有資料,也先別急著判斷失敗。Google 在你提交後會立刻嘗試讀這份 sitemap,讀不到的話,接下來幾天還會再試幾次。這段期間先確認 sitemap 的網址打得開,而且你是在對應這個網域的資源底下提交的。
如果你用的是網址前置字元資源,也就是用一個網址開頭來設定的資源,http 和 https、有沒有 www 都算不同的資源。網域資源則把它們全部包在一起(新增網站資源)。
Bing 也值得提交一次,因為 Copilot 用的是 Bing 收錄的網頁。
Bing Webmaster Tools 的 Sitemaps 功能可以提交 XML、RSS、Atom 或純文字清單。從 Google Search Console 匯入的 sitemap,也會列在同一份清單裡(Bing:Sitemaps)。
網頁一改就要通知 Bing 的話,用的是 IndexNow,它要和 sitemap 一起用。IndexNow 即時通知有變動的網址,sitemap 讓搜尋引擎持續找到全站的網址(IndexNow FAQ)。兩樣怎麼設定,寫在 Bing Webmaster Tools 教學。
有些網站另外有一頁叫「網站地圖」的 HTML 頁面,把全站的連結列出來給人看。它和這篇講的、給搜尋引擎讀的 XML 檔案是兩件事。
sitemap、robots.txt、canonical 和內部連結怎麼分工
這四樣各管一件事。sitemap 管搜尋引擎知道哪些網址,robots.txt 管爬蟲能不能進來。canonical 是頁面上的一個標記,管哪個網址算正式版本。內部連結管新頁面有沒有路可以走到。
| 工具 | 它在做什麼 | ethorx.com 的做法 | 它管不到的事 |
|---|---|---|---|
| sitemap | 告訴搜尋引擎有哪些網址、什麼時候更新 | 文章、FAQ 和列表頁自動列進去,草稿不列 | 抓不抓、收不收錄 |
| robots.txt | 告訴爬蟲哪些路徑不要來抓 | 只擋 /api/,最後一行寫 sitemap 的位置 | 不能用來把頁面從搜尋結果藏起來 |
| canonical | 告訴 Google 幾個重複網址裡哪一個是正本 | 每頁都指向自己的正式網址 | Google 還是可能選別的網址 |
| 內部連結 | 讓爬蟲和讀者從一頁走到另一頁 | 每篇文章都連到上層的主題文章和幾篇相關文章 | 會不會被收錄 |
表裡有三個地方最容易弄錯。
第一,sitemap 和頁面上的 canonical 指向不同網址時,canonical 的分量比較重。對 Google 來說,轉址和 rel="canonical" 是比較強的提示,網址有沒有列在 sitemap 裡只是比較弱的提示(整合重複網址)。
第二,robots.txt 是用來管理爬蟲流量的,它擋不住網頁出現在 Google。想讓某一頁不被收錄,要在那一頁設 noindex,也就是要求搜尋引擎不要收錄這一頁的標記。而且不能同時用 robots.txt 擋住它,否則 Google 連 noindex 都讀不到(robots.txt 簡介)。
第三,只交 sitemap、站內卻沒有任何一頁連到新文章。這樣讀者找不到它,爬蟲也只能從 sitemap 知道它存在,看不到其他頁面怎麼描述它。修正方式是從上層的主題文章、分類頁或相關文章各連一次過去,連結文字直接寫這篇在講什麼,例如「sitemap 是什麼」。
sitemap 只是多給爬蟲一條路,站內連結還是要自己排好,怎麼排可以看內部連結會讓 AI 更常引用你嗎。
XML sitemap 裡的網址要怎麼整理
sitemap 裡的每一個網址,都應該是你真的希望被收錄、而且任何人都打得開的正式網址。一份最小的 XML sitemap 長這樣。每一個 <url> 是一個網址,<loc> 寫網址本身,<lastmod> 寫這一頁最後一次修改的日期。沒有可靠的日期就不寫。
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.example.com/</loc>
    <lastmod>2026-11-03</lastmod>
  </url>
  <url>
    <loc>https://www.example.com/contact</loc>
  </url>
</urlset>
ethorx.com 的 sitemap 是程式依照內容自動產生的,只列已經發布、而且要讓 Google 收錄的頁。所以草稿和設了 noindex 的頁都不會出現在清單裡。不管你的 sitemap 是怎麼產生的,清單裡的網址都可以照下面的原則檢查。
- 網域和協定統一:網址用 https 和同一個網域,例如統一用
https://www.開頭,不要有的有 www、有的沒有。 - 每個網址都打得開:不用登入就打得開。伺服器回應每個請求時會附一個三位數的狀態碼,sitemap 裡的網址都要回代表正常的 200。404(找不到)的頁面不該列。301(轉址)的舊網址也不該列,改列轉址後的新網址。
- 和 canonical 一致:網址要和頁面上的 canonical、站內連結指向同一個版本。不要 sitemap 列一個、canonical 又指向另一個。canonical 跟 AI 引用哪個網址的關係,另外寫在 canonical 會影響 AI 引用哪個網址嗎。
- 不列不該收錄的頁:草稿和設了 noindex 的頁面也不要列。這些網址和 404、舊網址一樣,最常在改版或搬家之後留下來。Wix、Shopify 的 sitemap 會跟著網站自動更新,用程式或產生器工具做的 sitemap 就要自己清掉再重新提交。
- 不超過上限:一個檔最多 50,000 個網址、未壓縮 50 MB,檔案要用 UTF-8 編碼。超過就拆成多個檔案,再用一份 sitemap index 把它們串起來。sitemap index 就是列出其他 sitemap 位置的總表。
lastmod 只在內容真的改了才更新
lastmod 是每個網址旁邊的「最後修改日期」,也就是名冊上的整修日期。Google 只有在這個日期一直都準確、而且對得上頁面實際的修改時,才會參考它。這裡說的修改,指的是正文、結構化資料或連結這類重要的更新,頁尾的版權年份更新不算。
另外,sitemap 裡的 <priority> 和 <changefreq>,Google 會直接忽略(建立並提交 Sitemap)。
ethorx.com 的文章,lastmod 直接用文章的「更新日期」欄位。所以只有我們真的改過那篇文章,這個日期才會變。分類頁和專欄首頁的 lastmod,取的是它列出的文章裡最新的那個日期,因為新文章上線之後,列表頁的內容也跟著變了。
關於我們、聯絡頁和 /otlex 這些固定頁沒有可靠的更新紀錄,所以我們乾脆不寫 lastmod。
有一種錯誤很容易發生:網站每次重新建置,就把所有網址的 lastmod 改成今天。這樣日期就對不上實際的修改,Google 也就可能不採用。所以如果你的平台給不出準確的更新日期,寧可不填,也不要填一個每天都在變的日期。
從 sitemap 到 AI 回答的六個檢查點
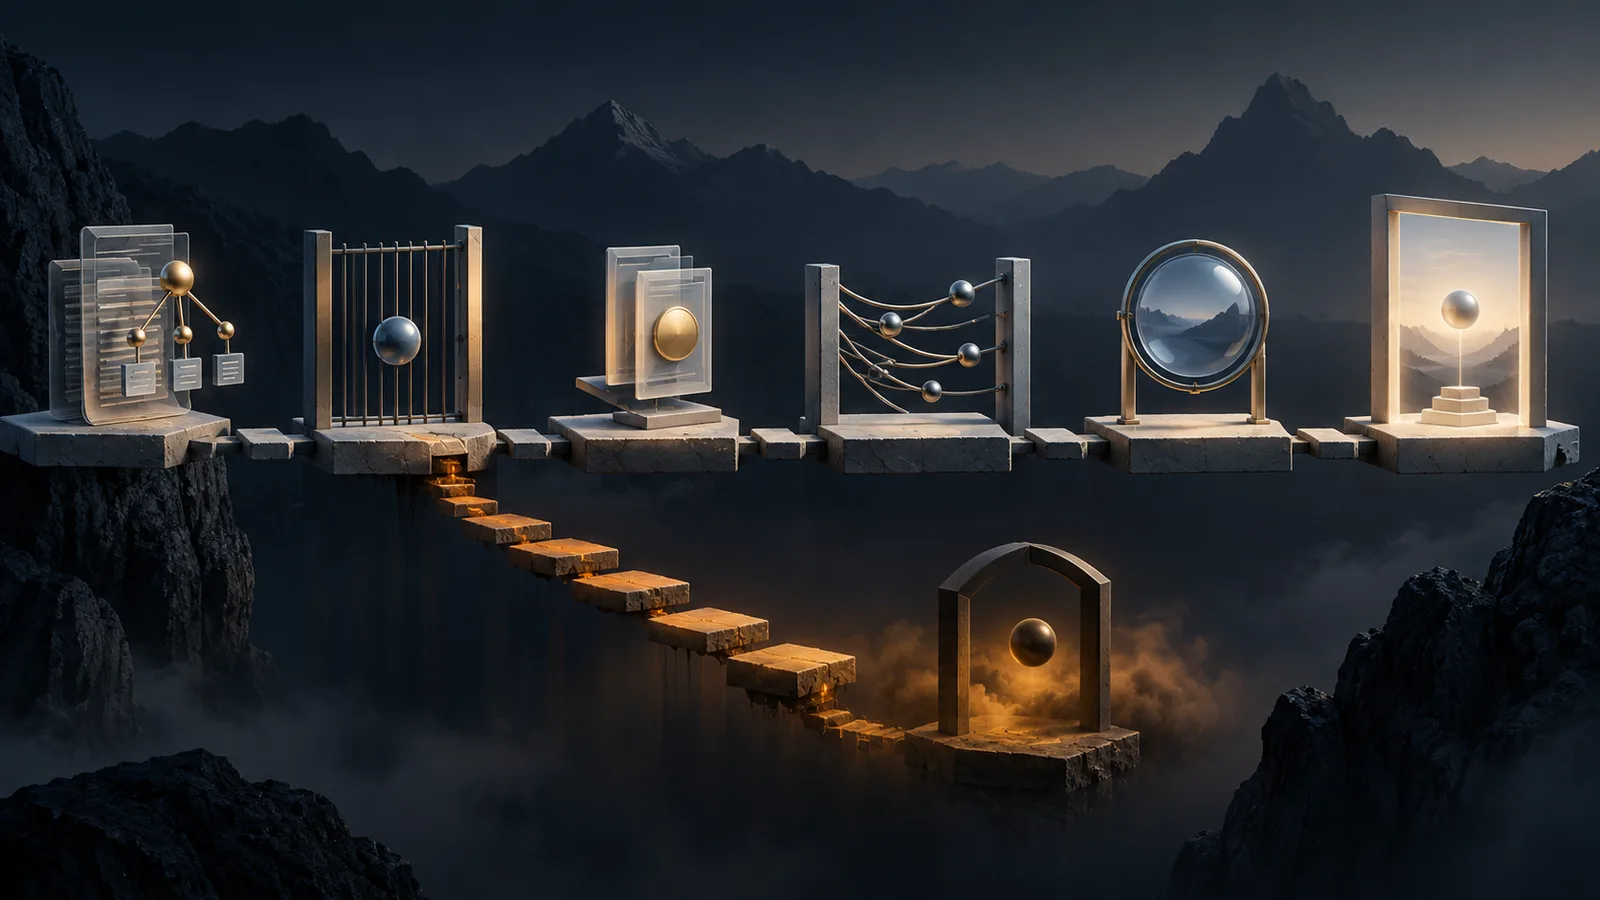 sitemap 負責告訴搜尋引擎有哪些網址;後面的抓、收錄和 AI 引用,要一層一層確認。
新文章上線後,我會照下面六個檢查點由上往下看。前五個是網頁被 Google 收錄的順序,前一個沒通過,後面的就先不用查。第六個是 AI 回答,ChatGPT、Perplexity 這些產品各自決定引用哪些來源,所以要另外查。
| 檢查點 | 去哪裡看 | 正常的樣子 | 不正常時先查什麼 |
|---|---|---|---|
| 網址清單 | 直接打開 sitemap.xml | 新文章的網址在裡面,草稿和已刪的頁不在 | 產生 sitemap 的規則或外掛設定 |
| XML 格式 | Search Console 的「Sitemap」報表 | 狀態是「成功」,「系統探索到的網頁」數跟你預期的差不多 | 出現「無法擷取」或「發生錯誤」時,先查檔案格式和網址 |
| 回應狀態 | 打開瀏覽器的開發者工具(Windows 按 F12,Mac 按 Option+Command+I),切到「Network」分頁後重新整理,看清單最上面那一筆的 Status | sitemap 和新文章都是 200 | 出現 301(轉址)、404(找不到)或 5 開頭的伺服器錯誤 |
| 存取規則 | robots.txt、頁面原始碼裡的 noindex 和 canonical | 沒被擋、沒有 noindex、canonical 指向自己 | 外掛或範本有沒有自動加上 noindex |
| 收錄 | Search Console 的「網址檢查」 | 顯示「網址在 Google 服務中」 | 展開「網頁索引狀態」看 Google 給的原因 |
| AI 回答 | 拿固定的問題實際去問 ChatGPT、Gemini 或 Google 的 AI 摘要 | 回答附上的來源裡有這一頁 | 換幾天再問一次,並記下日期 |
我們的 /otlex 在 2026 年 10 月 16 日就是停在第五個檢查點。前四個都正常:
- sitemap.xml 裡有
https://www.ethorx.com/otlex這一行。 - Search Console 的 Sitemap 報表是「成功」。
- 開發者工具看到的是 200。
- robots.txt 只擋
/api/,頁面上的 canonical 也指向自己。
可是到了第五個,網址檢查顯示的狀態是「已找到 - 目前尚未建立索引」。意思是 Google 已經知道這個網址,但還沒來抓。Google 對這個狀態的說明是,它想來抓,但怕一次抓太多拖慢網站,所以把時間往後排(網頁索引報表)。不過哪一天會來,報表不會告訴你。
就 Google 來說,網頁要出現在 AI 摘要或 AI 模式裡,條件是已經被收錄,而且有資格在搜尋結果裡顯示那一小段說明文字。除此之外不用另外做 AI 專用的設定(AI 功能與你的網站)。所以前五個檢查點都通過,代表條件備齊了。至於 Google 的 AI 要不要拿這一頁來用,還是 Google 決定。
OpenAI、Anthropic、Perplexity 的爬蟲有沒有來抓過你的頁面,最直接的查法是看網站主機或 CDN 的存取紀錄。CDN 是把網站內容放到各地主機加速、順便擋惡意流量的服務,例如 Cloudflare。
紀錄裡會有每個爬蟲的名字,以及它請求了哪些網址。我們開發的 Otlex 也會記錄 AI 爬蟲造訪網站的紀錄。
查 AI 回答時要注意,某一天問了沒看到這一頁,只代表那一天、那個問題、那個產品的回答沒有引用它。隔幾天用同一組問題再問幾次,你才看得出引用的情況有沒有在變。問題怎麼寫成顧客真的會問的樣子,可以看 AI 搜尋題庫怎麼設計。
回到 /otlex:我們怎麼處理,後來怎麼了
/otlex 和「關於我們」這兩頁,就停在第五個檢查點。sitemap 已經交過了,再交一次也只是讓 Google 再讀一次同一份清單。所以我們在 Search Console 的網址檢查裡,替這兩頁各送出一次建立索引的要求,請 Google 來抓。
送出要求之後,狀態不會馬上變。要看的是網址檢查裡的「網頁索引狀態」。「上次檢索時間」有日期,代表 Google 來抓過。狀態變成「網址在 Google 服務中」,才算收錄。
後來的情況,我們是從成效報表看到的。我們在 2026 年 11 月 5 日讀報表,看的是 10 月 7 日到 11 月 3 日這 28 天,其中也包含送出要求之前的日子。這段期間 /otlex 有 21 次曝光、平均排名 6.9。「關於我們」有 25 次曝光、2 次點擊、平均排名 2.9。
有曝光,代表這兩頁已經出現在搜尋結果裡。
換成你的網站,順序是一樣的。
- 先找到 sitemap 的網址,確認它打得開,新頁面也在裡面。
- 到 Search Console 的 Sitemap 報表提交一次,看狀態是不是「成功」。
- 挑三到五個最重要的頁面做網址檢查。停在「已找到 - 目前尚未建立索引」的,先確認站內有頁面連過去。然後再送出建立索引的要求。
- 之後每個月看一次 Sitemap 報表和網頁索引報表。看有沒有新的錯誤,未收錄的頁數有沒有突然增加。這些頁在成效報表開始有曝光,就代表已經出現在搜尋結果裡。
常見問題
sitemap 更新後要重新提交嗎?
不用。提交成功之後,Google 會持續回來重讀這份 sitemap,新增的網址它下次重讀就會看到。只有報表顯示讀取失敗時,才要修好再重新提交一次。
sitemap 檔案要放在網站的哪裡?
建議放在網站根目錄。sitemap 放在其他資料夾也可以,但沒有透過 Search Console 提交的話,它只對那個資料夾底下的網址有效,放在根目錄才涵蓋全站。
圖片要另外做一份 sitemap 嗎?
不一定。你可以另外做一份圖片 sitemap,也可以在現有的 sitemap 裡加上圖片標記,Google 兩種都接受。它主要幫 Google 找到不容易發現的圖片,例如用 JavaScript 載入的圖片。
參考來源
以下依各官方文件整理,各平台 sitemap 的路徑、提交條件與方案限制以官方頁面當下為準。
- Google:Sitemap 簡介
- Google:建立及提交 Sitemap
- Google:圖片 Sitemap
- Google:整合重複網址(canonical)
- Google:robots.txt 簡介
- Google:AI 功能與你的網站
- Search Console 說明:Sitemap 報表
- Search Console 說明:網頁索引報表
- Search Console 說明:新增網站資源
- sitemaps.org:通訊協定
- WordPress Core:New XML Sitemaps Functionality in WordPress 5.5
- Yoast:XML sitemaps in the Yoast SEO plugin
- Yoast:Yoast SEO settings: Site features
- Rank Math:Configure Sitemaps
- Wix 說明中心:Understanding Your Site’s Sitemap File
- Wix 說明中心:Submitting Your Sitemap and URLs Directly to Search Engines
- Shopify 說明中心:Finding and submitting your sitemap
- Bing Webmaster Tools:Sitemaps
- Bing Webmaster Guidelines
- IndexNow:FAQ
- OpenAI:Overview of OpenAI Crawlers
- Anthropic:Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Perplexity:Perplexity Crawlers